一、公司介绍
久章智能是一家专注于解决企业物流优化问题的算法公司,致力于研究利用高效算法解决物流与制造行业“大规模、多要素、多约束、多目标、多层次”的动态组合优化问题,为客户提供高性价比、高定制化的供应链系统解决方案。
团队工作氛围融洽,团队成员来自复旦大学、上海交大、同济大学、南开大学、四川大学、山东大学、南京航空航天大学、暨南大学、华南师范大学等重点高校,拥有丰富且前沿的运筹优化、算法开发、人工智能实践积累。
目前已与南航、松下、安永、地面通、隶首、范达、得帆、京东、富勒、运匠、沈阳自动化所、晞德、杉数、谷斗、宁波任大等多家企业合作,均取得良好反馈。
二、原型产品
1. 炼油厂优化Refinery Optimization(2024.9.11)
一、问题描述
炼油厂购买两种原油(原油1和原油2)。这些原油经过四个过程:蒸馏、重整、裂解和混合,生产出汽油和燃料出售。
- Distillation蒸馏
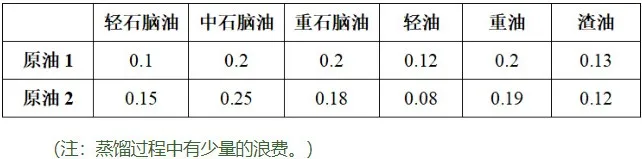
蒸馏根据沸点将每种原油分离成称为轻石脑油、中石脑油、重石脑、轻油、重油和渣油的馏分,轻、中和重石脑油的辛烷值分别为90、80和70。下表给出了每种原油中各成分的比例:
【补充知识:汽油的辛烷值(Octane Rating)是衡量汽油抗爆性能的一个指标,它表示汽油在内燃机中燃烧时抵抗自燃(即爆震)的能力。辛烷值越高,汽油的抗爆震性能越好,发动机在高压缩比下运行时越不容易发生爆震】
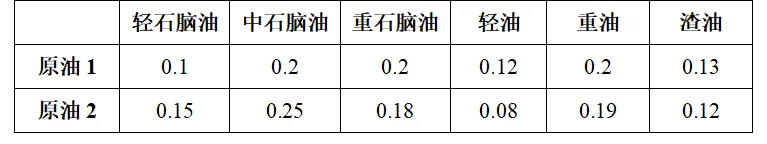
(注:蒸馏过程中有少量的浪费。)
- Reforming重整
石脑油可以立即用于混合成不同等级的汽油,或者可以进入重整。重整产生重整汽油,辛烷值为115。每桶不同种类石脑油的重整汽油产率如下:
1桶轻石脑油产0.6桶重整汽油;
1桶中石脑油产0.52桶重整汽油;
1桶重石脑油产0.45桶重整汽油。
- Cracking裂解
这些油(轻质和重质)可以直接混合成喷气燃料或燃料油,也可以投入催化裂化过程。催化裂化器产生裂化油和裂化汽油。裂化汽油的辛烷值为105。
1桶轻质油生产0.68桶裂化油和0.28桶裂化汽油;
1桶重油生产0.75桶裂化油和0.2桶裂化汽油。
裂化油用于调和燃料油和喷气燃料;裂解汽油用于调和汽油。
渣油可用于生产润滑油或调和喷气燃料和燃料油:
每桶渣油生产0.5桶润滑油。
- Blending混合
(1)汽油(汽车燃料)
有两种汽油,普通汽油和优质汽油,是由石脑油、重整汽油和裂解汽油混合而成的。关于它们的唯一规定是,普通汽油的辛烷值必须至少为84,高级汽油的辛烷值必须至少为94。假定辛烷值按体积线性混合。
(2)喷气燃料
有关喷气燃料的规定是其蒸气压不得超过1公斤平方厘米。轻油、重油、裂化油和渣油的蒸气压分别为1.0、0.6、1.5和0.05 kg cm 2。可以再次假设蒸汽压按体积线性混合。
(3)燃料油
为了生产燃料油,轻油、裂化油、重油和渣油必须按10:4:3:1的比例混合。
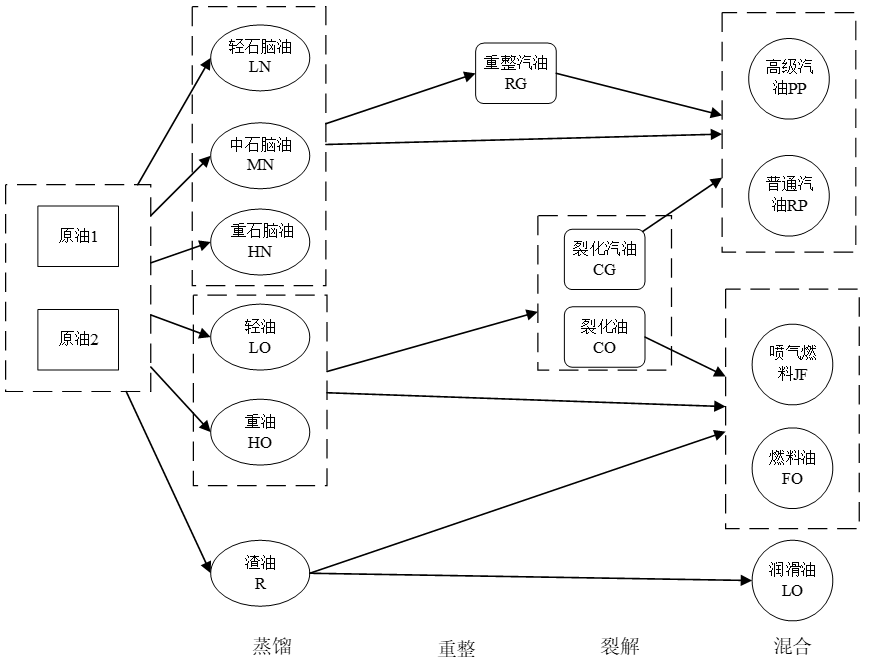
原油转化过程图
在使用的数量和工艺上存在可用性和能力限制,如下所示:
-
原油1的日供应量为20000桶。
-
原油2的日供应量为30000桶。
-
每天最多可蒸馏出45000桶原油。
-
每天最多可重整10000桶石脑油。
-
每天最多可裂解8000桶石油。
-
润滑油的日产量必须在500至1000桶之间。
-
优质车用燃料产量必须至少为常规车用燃料产量的40%。
来自最终产品销售的利润贡献(以便士/桶计)如下:
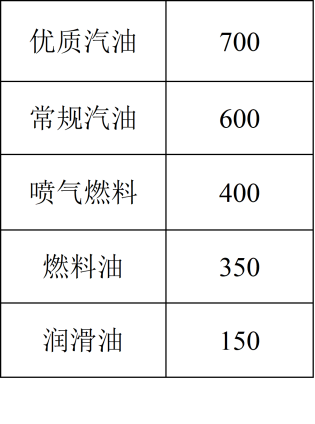
为了使总利润最大化,炼油厂的操作应如何规划?
二、求解
石油工业是线性规划模型的主要用户。这是典型应用中的一个非常小的部分。一般来说,所使用的模型将由数千个约束组成,可能将一个以上的炼油厂连接在一起。
- 变量
考虑到这种模型中有许多不同种类的变量,在描述公式时使用助记符名称是方便的。以下变量用于表示材料的数量(以桶计):
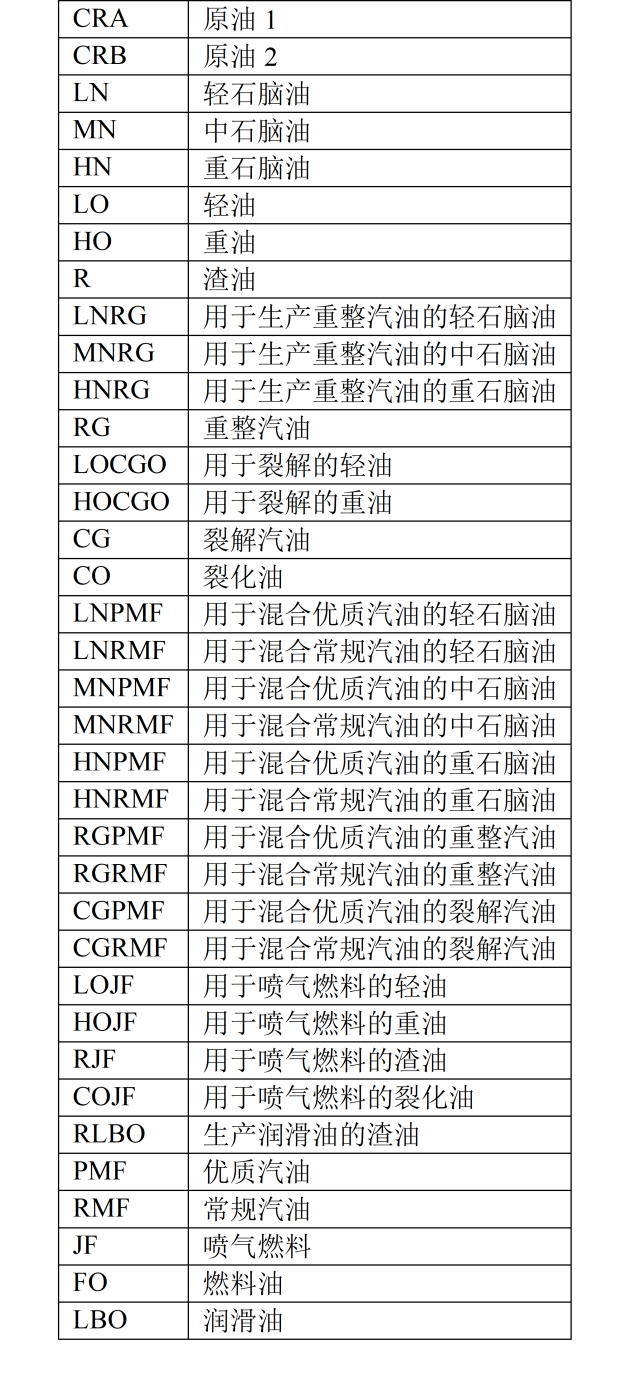
- 约束
可供量
原油的有限可供量提供了简单的上界约束:
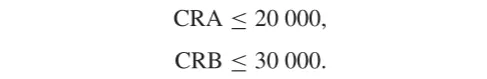
能力约束
蒸馏能力约束:
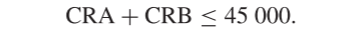
重整能力约束:
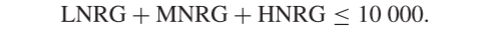
裂解能力约束:
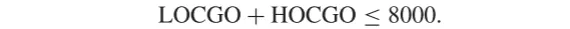
关于润滑油生产的规定给出了以下下限和上限约束:
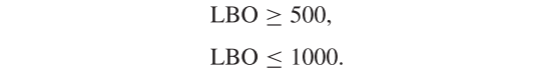
连续性:
轻石脑油的产量取决于所用原油的数量,同时考虑到每种原油在蒸馏下的分离方式。这给出:
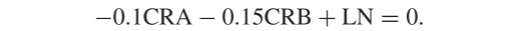
对于MN、HN、LO、HO和R存在类似的约束。
-0.2CRA-0.25CRB+MN=0
-0.2CRA-0.18CRB+HN=0
-0.12CRA-0.08CRB+LO=0
-0.2CRA-0.19CRB+HO=0
-0.13-0.12CRB+R=0
生产的重整汽油的量取决于重整过程中使用的石脑油的量。这给出了约束:
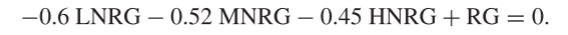
生产的裂解油和裂解汽油的数量取决于使用的轻油和重油的数量。这给出了约束条件:
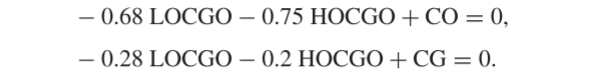
润滑油的生产(和销售)量是渣油使用量的0.5倍。这给出:
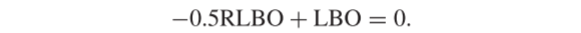
用于重整和混合的轻石脑油的量等于可用的量。这给出:
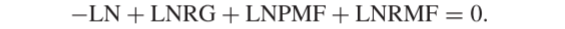
对于MN和HN存在类似的约束。
-MN+MNRG+MNPMF+MNRMF=0
-HN+HNRG+HNPMF+HNRMF=0
用于裂化和混合的轻油的数量与可用的数量相等。这给出:
-LO+LOCGO+LOJF+0.55FO=0
蒸馏后的轻油有:用于裂解(LOCGO)、用于生产喷气燃料(LOJF)和用于生产燃料油。对于燃料油的调和,轻油的比例固定为10/18。因此,这里并没有引入单独的变量,即用于生产燃料油的轻油,而是直接用轻油占用燃料油的比例表示。
HO、CO和R也存在类似的限制,也涉及固定比例的FO,以及CG和RG。
-HO+HOCGO+HOJF+3/18FO=0
-CO+COJF+4/18FO=0
-R+RJF+1/18FO+RLBO=0
-CG+CGRMF+CGPMF=0
-RG+RGRMF+RGPMF=0
生产的优质汽车燃料的数量等于其成分的总量。这给出:
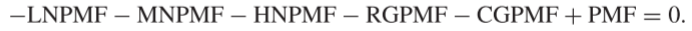
RMF和JF也存在类似的限制。
-LNPMF-MNRMF-HNRMF-RGRMF-CGRMF+RMF=0
-LOJF-HOJF-COJF-RJF+JF=0
优质汽车燃料产量必须至少为常规汽车燃料产量的40%,
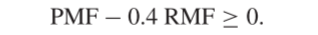
品质
有必要规定高级汽车燃料的辛烷值不低于94。这是由以下约束完成的:
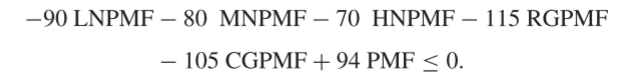
(体积可看为权重系数,加权求和之后再除以总量,即PMF\<=94)
RMF也有类似的限制。
-90LNPMF-80MNRMF-70HNRMF-115RGRMF-105CGRMF+84RMF\<=0
对于喷气燃料,我们有蒸汽压的限制。
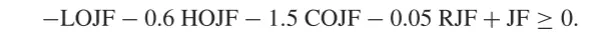
该模型有29个约束条件,以及三个变量的简单界限。
- 目标函数
唯一涉及利润(或成本)的变量是最终产品。这给出了要最大化的目标(以磅为单位),
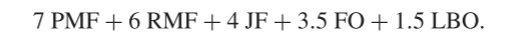
三、求解
最优解的利润为211365英镑。
第三部分中定义的变量的最佳值如下:
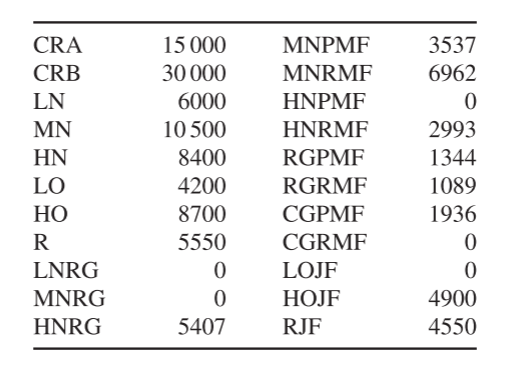
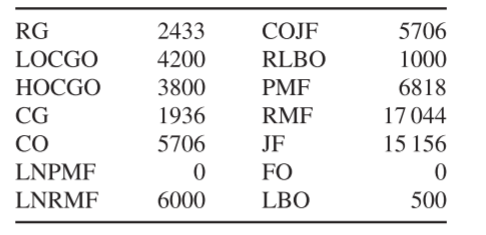
四、展示
炼油厂优化问题页面展示
原图视频\.mp4
五、建模小tip
modal formulations用于减少约束数量
在这个问题中,对于燃料油混合,其中的成分(轻油、重油、裂化油和渣油)是按固定比例混合的。在此,最好将FO的生产视为一项固定的活动。这就是modal formulations方法,其中活动表示过程的极端操作模式。在石油工业中,从活动而不是数量的角度来思考是很常见的。在这种情况下,活动的数量会按比例自动固定各成分的数量。
模态公式举例:
在大型LP问题中,可以使用模态公式来减少约束的数量。如果一系列约束只涉及少数变量,则可以考虑这些变量空间的可行域。例如,假设x_A和x_B是LP模型中的两个(非负)变量,并且它们出现在以下约束中:
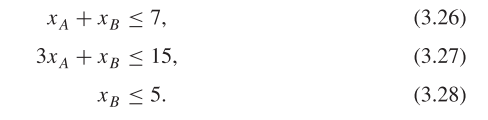
如图3.3所示,这种情况可以通过用变量而不是x_A和x_B来表示“极端运行模式”的活动来模拟。如果这些变量是λ0、λ1、λ2、λ3和λ4,我们只需指定单个约束。
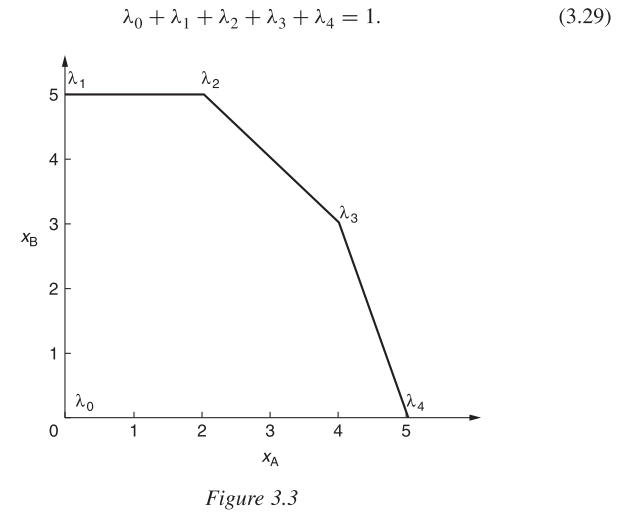
当x_A和x_B出现在模型的其他部分时,除了现在被忽略的约束(3.26),(3.27)和(3.28)之外,我们替换以下表达式:
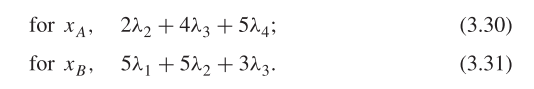
对于x_A,λ1,λ2,……的系数是图3.3中x_A轴上对应的值,同样地,对于x_B,替换后变量的系数是x_B轴对应的值。
在本例中,我们节省了两个约束。巧妙地使用这个想法可以大大节省模型中的约束数量。
参考文献
[1] Williams, H. P. (2013). Model Building in Mathematical Programming (5th ed.). Wiley.
2. 工厂生产计划Factory Product Planning(2024.9.23)
一、问题介绍
在生产规划问题中,需要对生产的产品种类、数量、生产能力进行决策和分配,从而实现有限生产能力下的最大利润。为帮助制造企业更好地决策以上问题,现以下述生产场景为例,给出久章智能在工厂生产计划问题的场景化解决方案和求解展示。
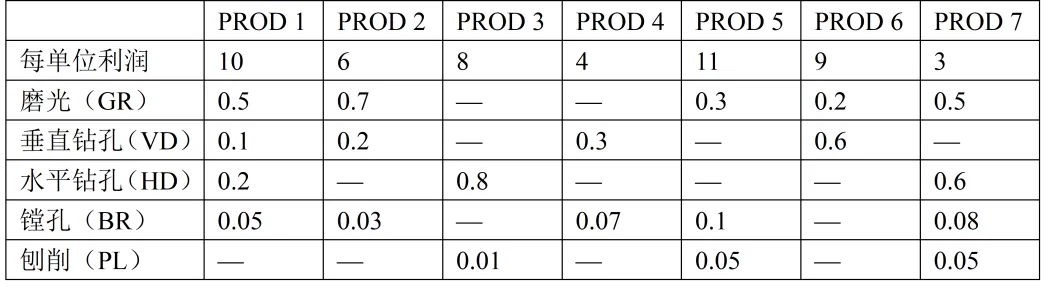
假设工厂生产7种产品(PROD 1至PROD 7),共有4台磨机(grinders,以下简称GR)、2台立钻(vertical drills,以下简称VD)、3台卧钻(horizontal drills,以下简称HD)、1台钻机(borer,以下简称BR)和1台刨机(planer,以下简称PL)。每种产品的单位利润(定义为单位销售价格减去原材料成本)以及每个工艺所需的生产机器、单位生产时间(小时)如下。
表1 每种产品的单位利润及每个工艺所需的单位加工时间
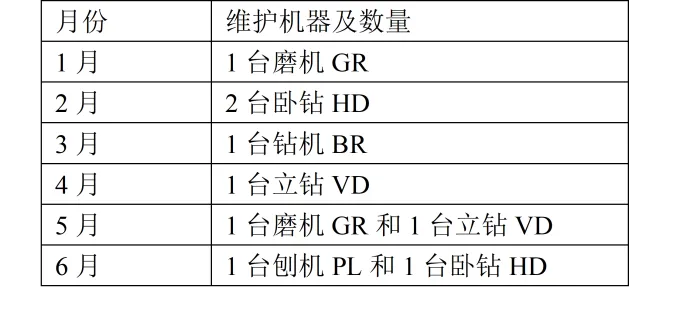
在本月(1月)和随后的五个月,某些机器将停机维护。这些机器的维护时间和数量计划表如下:
表2 机器维护计划表
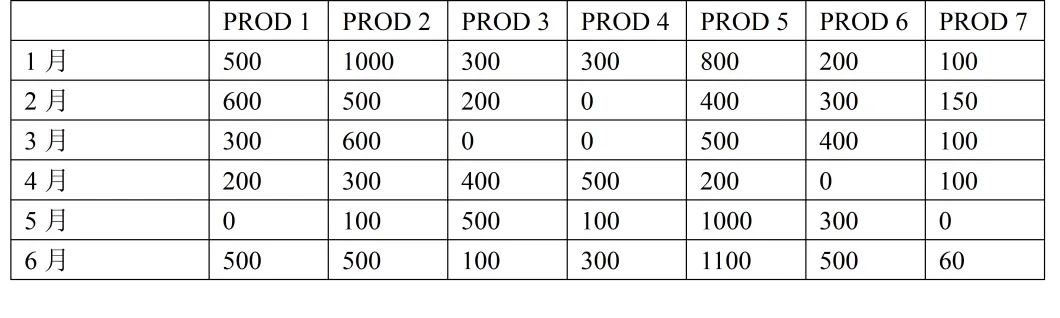
受到市场需求限制,每种产品每个月有最大可销售数量有限。如下表所示:
表3 每种产品每个月最大可销售数量限制
此外,还需考虑产成品库存容量限制、工作日历等约束:
库存容量限制:每个月每种产品最多100个单位存储量。计划期初没有库存,但希望在6月底每种产品都有50个单位的库存量。并且如果产品存放到仓库,每种产品每个月会在单位销售利润的基础上扣除单位库存持有成本为0.5元。
工作日历:工厂每周工作六天,可以假设每个月只有24个工作日,每个工作日两班8小时。
假设暂时不需要考虑任何排序问题。为了使总利润最大化,工厂应该何时生产多少数量的何种产品?
二、数学模型建立
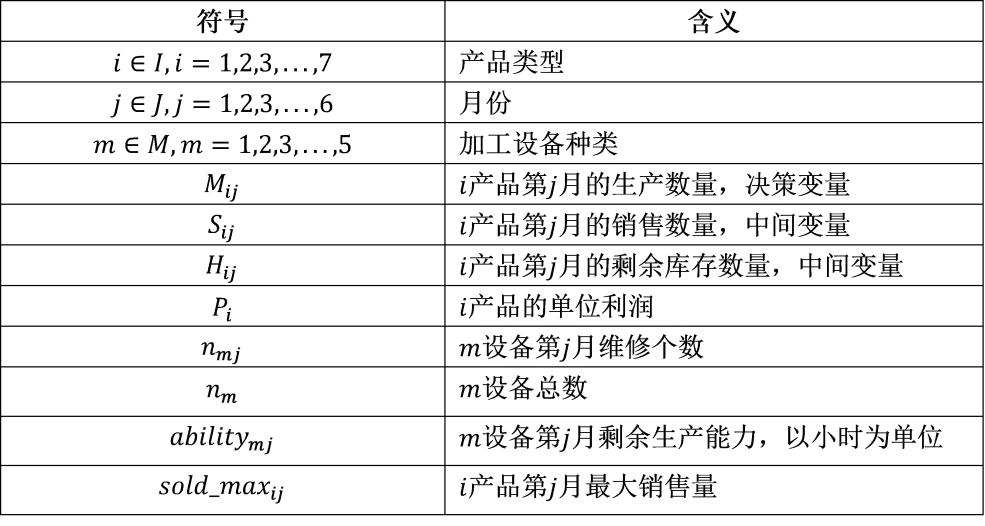
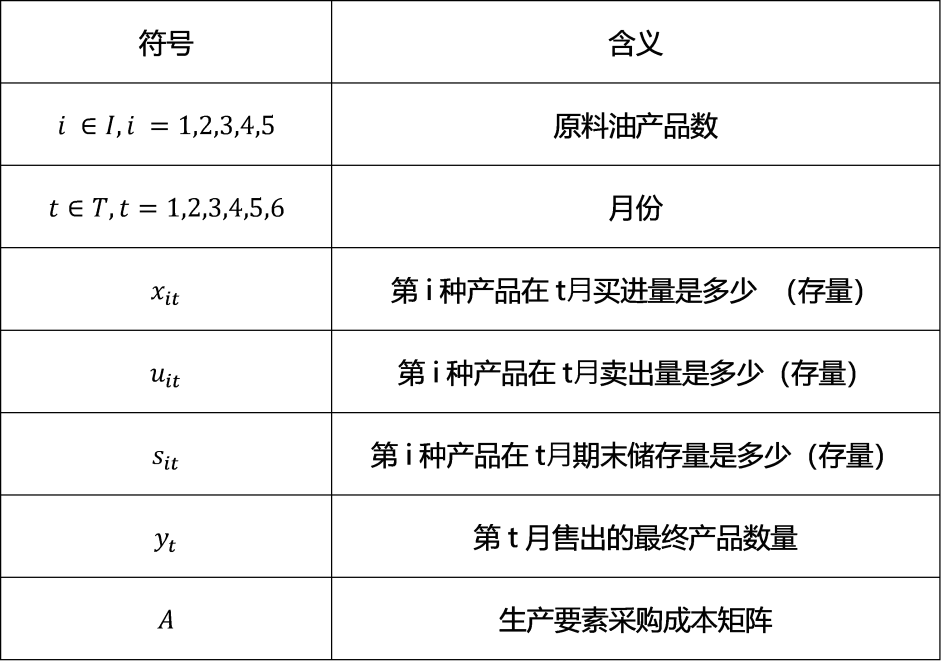
根据上述问题介绍,进行以下符号定义:
表4 数学模型的符号及含义
【约束条件】
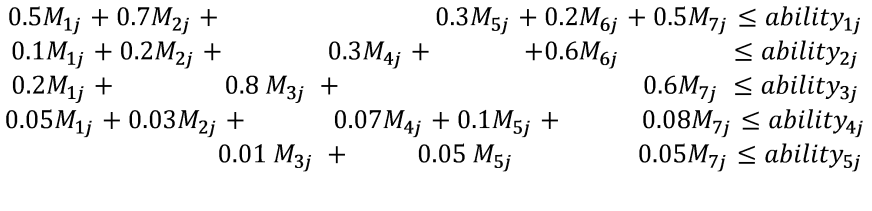
(1)生产能力约束:
由于设备维护和工作日历的限制,工厂内的设备生产能力每个月都不同。每种设备每个月的剩余生产能力可以由计算公式ability()(mj)=(n(m)-n(j))248*2得到。结合每种产品所需的设备占用加工时间就可以得到以下约束:
(2)库存约束:
每个月库存数量与上个月的库存结转、本月的销售数量、生产数量有关,每个月库存数量之间的递归关系根据H(ij-1)+M(ij)=S(ij)+H(ij)决定,且第1个月月初库存为0,第6个月月末库存为50,即生产计划周期初和周期末对每种产品的存储数量都有一定要求,则对于∀i∈I,都有以下约束:
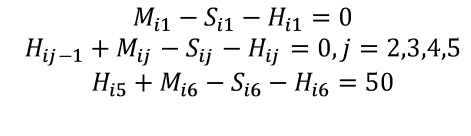
(3)其他变量约束:
所有变量不应该小于0,且M(ij)≤sold_max(ij)(,)()S(ij)≤sold_max(ij)(,)
每个月每种产品最多100个单位存储量,即H(ij)≤100
【目标函数】
假设我们生产的产品都可以卖出,即总销售数量=总生产数量,我们的求解目标是最大化总利润,可以由每个月的单位产品销售利润*生产数量,将6个月的总利润进行累加,再减去总库存持有成本得到,即:
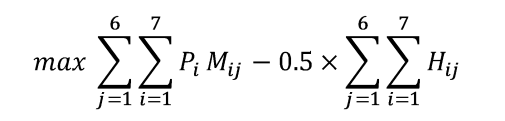
三、问题求解及应用展示
以上问题涉及到总共126个变量、72个约束,此外每个月,7种产品有市场销售界限和持有数量界限。这就给出了总共84个上界。我们对原问题进行求解,可在几秒钟内求出每种产品的生产计划时间、数量、对应的库存量以及最后最大化的总利润。如下图所示:
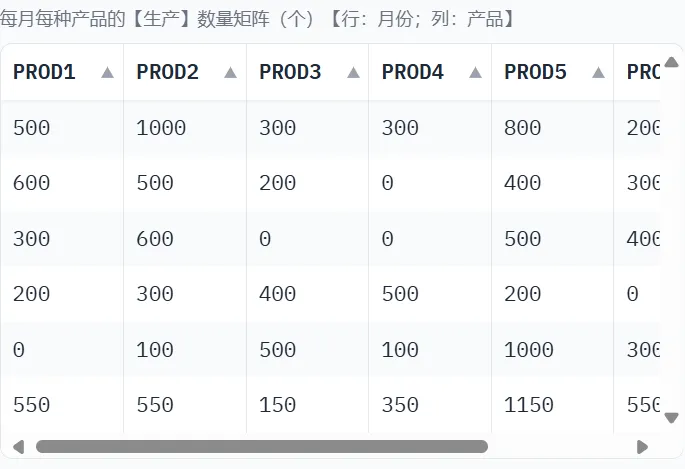
图1 每月每种产品应生产的数量
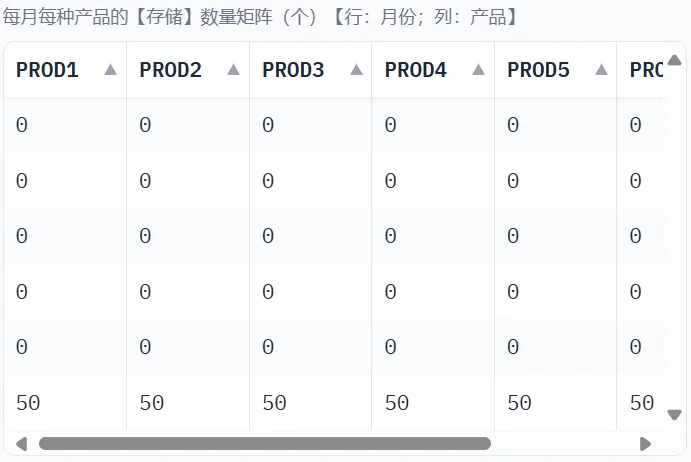
图2 每月每种产品应设库存量
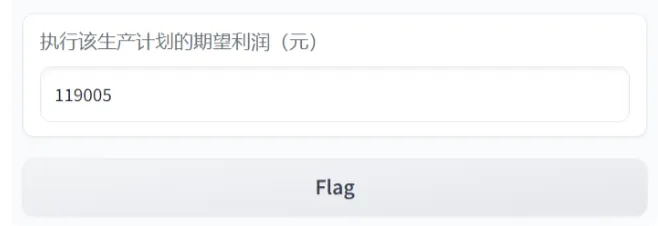
图3 执行该生产计划的期望利润
以下是我们开发的网页版求解器,可以导入其他数据,进行一键求解:
WeChat\_20240922221616\.mp4
3. 货物分配问题 Distribution1(2024.10.13)
一、问题介绍
在物流配送系统中,如何在工厂、仓库与客户之间规划合理的货物流动路径至关重要。该问题中的目标是优化配送模式,以最小化总成本,同时满足各客户的需求量。
假设某公司拥有两个工厂,分别位于利物浦(Liverpool)和布莱顿(Brighton),并且有四个带有储存设施的仓库,分别位于纽卡斯尔(Newcastle)、伯明翰(Birmingham)、伦敦(London)和埃克塞特(Exeter)。公司需要将产品分配给六个客户(C1, C2, ..., C6),客户可以直接从工厂或通过仓库供应。配送的具体信息如图1所示。
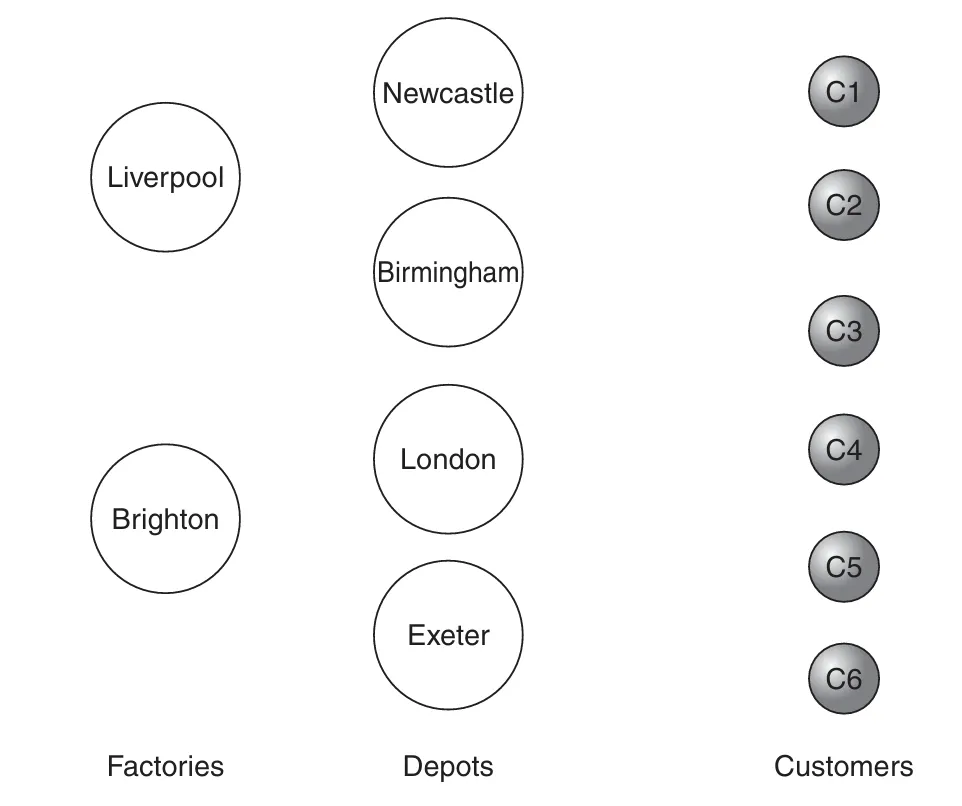
图1 工厂、仓库与客户之间的配送关系图
每个客户有固定的月度需求量,工厂和仓库也有相应的生产和吞吐能力限制。配送的成本如下表1所示,公司希望能够根据这些信息,确定一个能够最小化总配送成本的方案。
表1 配送成本(£/吨)
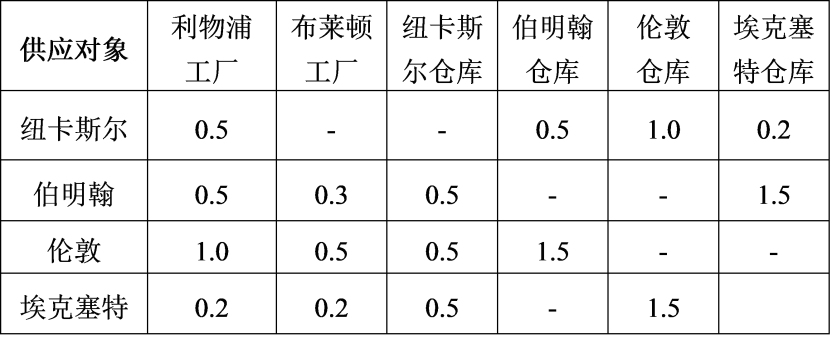
每个工厂和仓库都有月度生产和吞吐能力限制,具体如下:
表2 工厂与仓库的容量限制
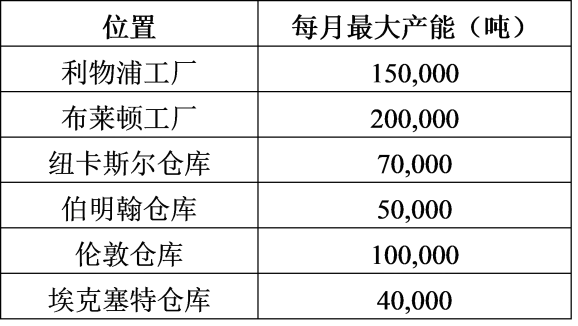
每个客户的月度需求如下:
表3客户的需求量
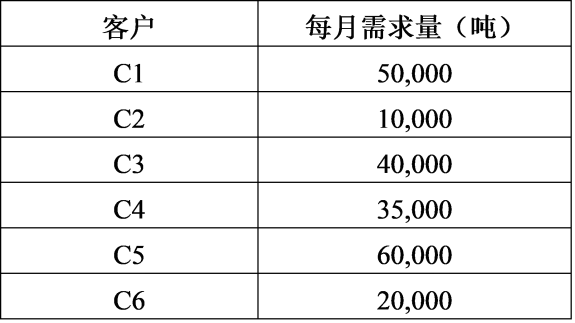
公司希望解决以下问题:
-
在满足客户需求的前提下,如何制定一个能够最小化总成本的配送方案?
-
如果提高工厂或仓库的容量,配送成本会如何变化?
-
若在成本、容量和需求上做出微小调整,对最优配送方案的影响是什么?
-
是否有可能完全满足客户的偏好供应来源?如果可以,所需增加的成本是多少?
二、数学模型建立
为了求解该问题,本文建立了一个网络流模型,将工厂、仓库和客户之间的货物流动用线性规划(LP)进行建模。定义以下决策变量:
x(ij):从工厂i向仓库j运送的货物量;
y(ik):从工厂i向客户k运送的货物量;
z(ik):从仓库j向客户k运送的货物量
此外,定义以下参数:
c(i):工厂i的产能,i=1,2;
p(j):仓库j的吞吐量,j=1,2,3,4;
c(k):客户k的需求量,k=1,2,...,6;
约束条件
(1)工厂容量约束:
每个工厂生产的货物总量不能超过其月度最大产能。
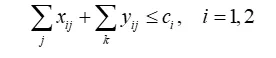
(2)仓库容量约束:
每个仓库的吞吐量不能超过其月度最大容量。
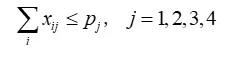
(3)客户需求约束:
每个客户的需求必须得到满足。
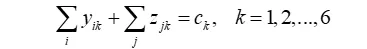
目标函数
目标函数是最小化总配送成本,包括从工厂到仓库、工厂到客户以及仓库到客户的运输成本,具体形式为:
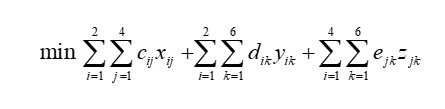
其中,c(ij)、d(ik)和e(jk)和分别表示从工厂到仓库、工厂到客户以及仓库到客户的单位运输成本。
三、问题求解及应用展示
通过求解该线性规划模型,可以得到最优的货物分配方案。该方案将在不超过工厂和仓库容量限制的前提下,最大限度地满足客户需求,同时实现总配送成本的最小化。
该问题可通过现有的线性规划求解算法(如单纯形法)来快速求解。结果将展示最优的工厂和仓库布局方案,以及如何分配货物以满足各客户的需求。
以下是我们开发的网页版求解器,可以导入其他数据,进行一键求解:
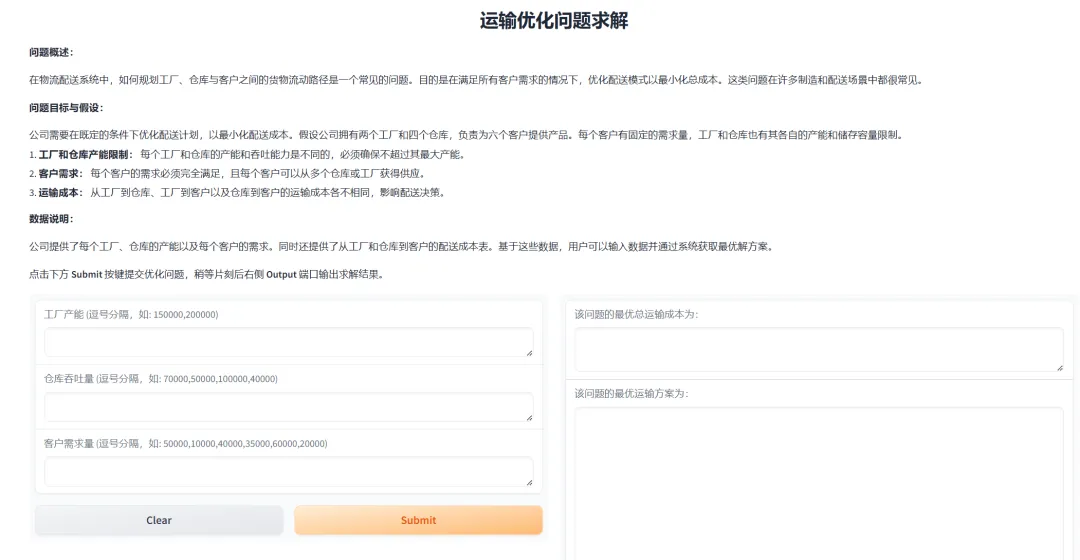
图1 求解器端口
如图2所示,求解器很快给出了最优结果:最优总运输成本为148000。
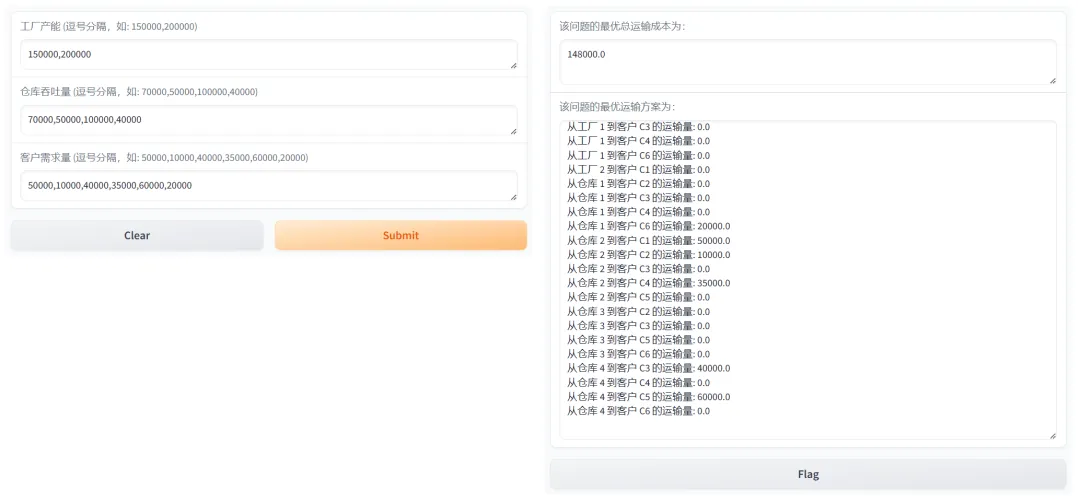
图2 求解器求解结果
以下是运输优化问题页面展示:
货物分配问题\.mp4
4. 仓库定位、扩建、关闭问题 Depot Location (Distribution 2)(2024.11.11)
一、问题描述
在现代物流配送网络中,仓库的选址、容量规划及关闭决策对于降低运营成本至关重要。为了帮助企业优化仓库布局和资源配置,本文以具体场景为例,探讨如何通过合理的仓库选址决策实现最小化总成本。
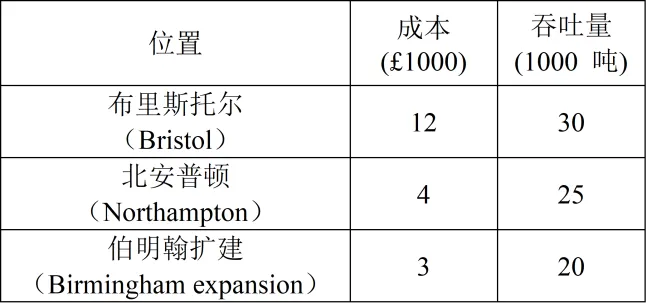
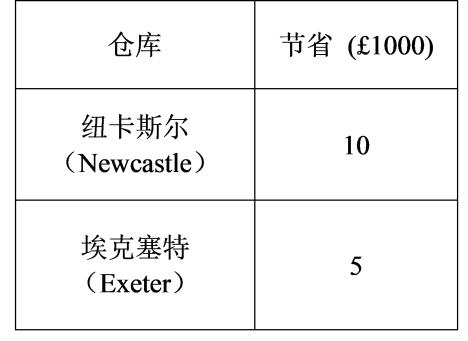
假设案例Distribution 1中的企业由于业务扩展(Distribution 1回顾链接:微信公众平台),考虑在布里斯托尔(Bristol)和北安普顿(Northampton)建设新的仓库,同时可能扩建现有的伯明翰(Birmingham)仓库。此外,还可以选择关闭现有的纽卡斯尔(Newcastle)和埃克塞特(Exeter)仓库。不同仓库的月度运营成本和相应的货物吞吐量如表1所示。
表1 仓库的运作成本与吞吐量
关闭现有的纽卡斯尔和埃克塞特仓库可以带来相应的成本节省,具体如下:
表2 关闭仓库的节省金额
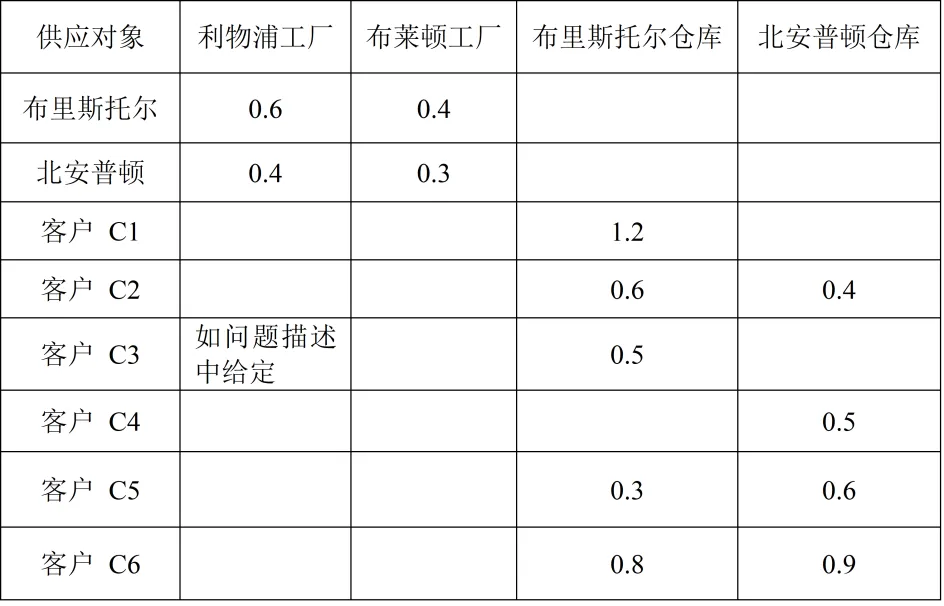
此外,不同仓库的配送成本(每吨货物的配送费用)如下所示:
表3 配送成本
问题:为了实现最低的配送成本:
-
企业应该在哪里建设新仓库?
-
伯明翰仓库是否应该扩建?
-
是否需要关闭纽卡斯尔或埃克塞特仓库?
二、数学模型建立
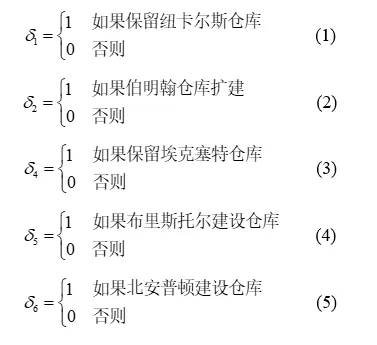
在Distribution 1线性规划问题的基础上,该配送问题可以扩展为混合整数模型,以解决是否建设或关闭仓库的额外决策。在Distribution 1基础上,引入额外的0-1整数变量δ(j),并根据以下解释进行定义:
此外,回顾一下Distribution 1中定义的决策变量与参数:
决策变量
-
x(ij):连续变量,从工厂i向仓库j运送的货物量;
-
y(ik):连续变量,从工厂i向客户k运送的货物量;
-
z(jk):连续变量,从仓库j向客户k运送的货物量;
参数
-
C(i):工厂i的产能,i=1,2;
-
P(j):仓库j的吞吐量,j=1,2,3,4;
-
R(k):客户k的需求量,k=1,2,...,6;
-
c(ij):从工厂i到仓库j的单位配送成本;
-
d(ik):从工厂i到客户k的单位配送成本;
-
e(jk):从仓库j到客户k的单位配送成本;
Distribution 1的约束
- 工厂容量约束:每个工厂生产的货物总量不能超过其月度最大产能。
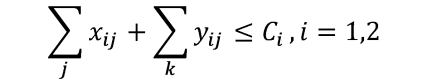
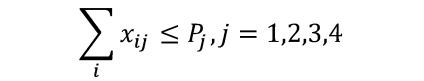
- 仓库容量约束:每个仓库的吞吐量不能超过其月度最大容量。
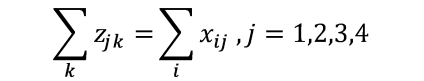
- 流量守恒约束:流出仓库的货物量之和要等于流入仓库的货物量之和。
- 客户需求约束:每个客户的需求必须得到满足。
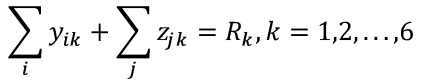
为解决Distribution 2的问题,引入额外的连续变量x(i5),x(i6),z(5k)和z(6k)来表示从新仓库布里斯托尔和北安普敦发出的和接收的货物量。并为Distribution 1的模型额外增加以下约束:
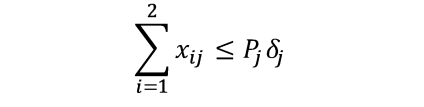
原伯明翰吞吐量为50,000吨,扩建后从伯明翰发出的货物量必须在其容量限制内:
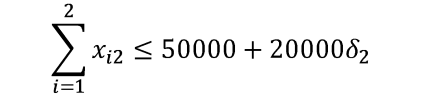
仓库数量限制为不超过四个(包括伯明翰和伦敦):
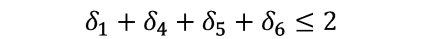
目标函数
新变量x(ij)和z(ij)被赋予相应的成本系数,将其添加入Distribution 1的目标函数中,则新目标函数为:
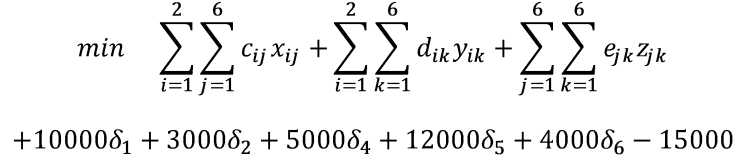
注意,由于仓库数量发生了变化,相应的求和项系数也发生了改变(j的系数增加了两个仓库)。
三、问题求解及应用展示
以下是我们开发的网页版求解器,可以导入其他数据,进行一键求解:
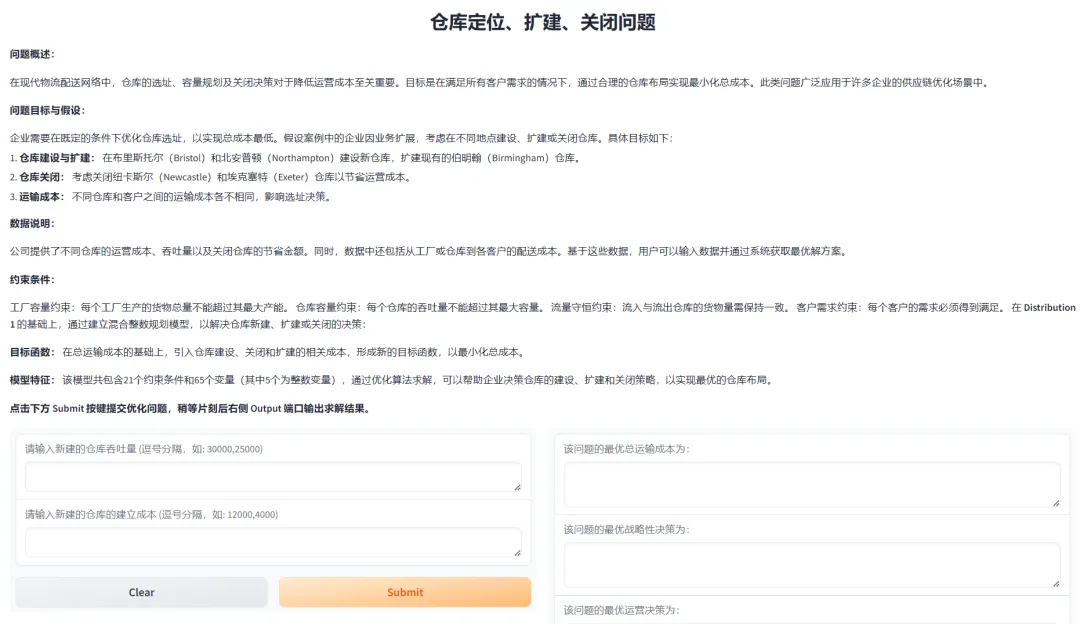
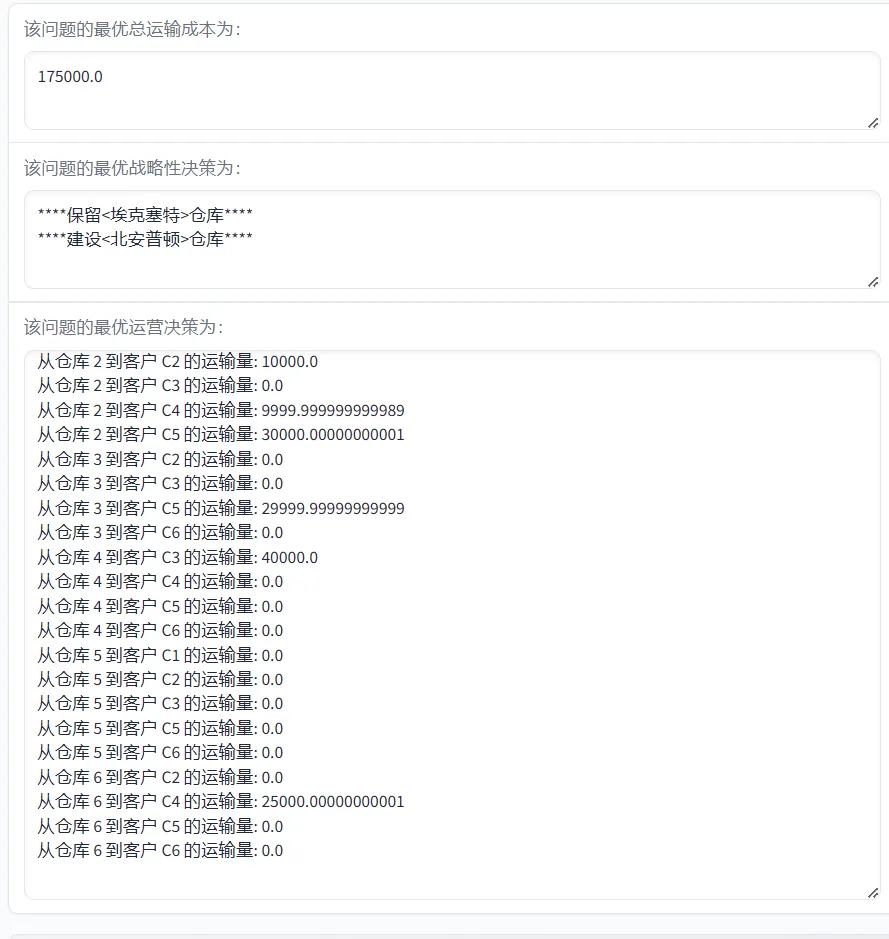
如下图所示,求解器很快给出了最优结果:最优总运输成本为175000,决策为保留埃克塞特仓库并建设北安普顿仓库。
应用展示视频如下:
仓库定位、扩建、关闭问题\.mp4
5. 人力资源规划问题Manpower Planning(2024.10.25)
一、情形描述
一家公司正在经历变革。新设备的安装对低水平工人的需求降低,对高水平工人的需求增加。未来3年,每年的贸易情形预测不同,对各类工人的需求也有差别。公司希望综合考虑招聘、培训、裁员、短时工作等情形,制定未来三年的政策,以达到最小裁员数,或最少开销。
- 后续3年劳动力需求
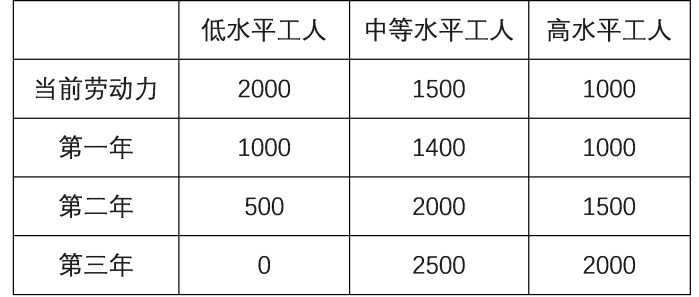
表1 后续3年劳动力需求
- 人员辞职
劳动力自然流失较大,许多员工在第一年内辞职,之后离职率显著降低。
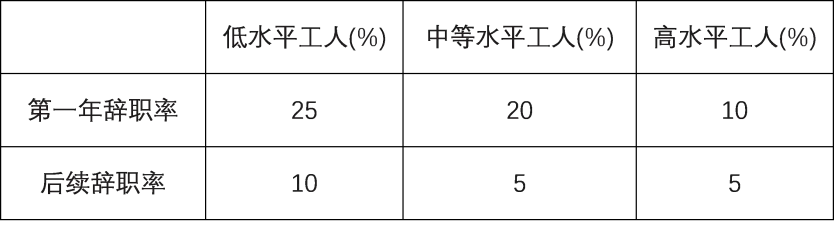
表2 辞职率
- 人员招募
每年可招募的人员数目有一定限制。
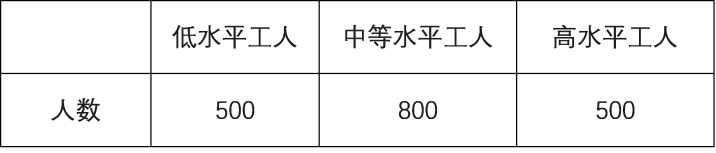
表3 每年可招募的最大人数
- 培训
通过培训,低水平与中等水平的工人能提高一个级别。
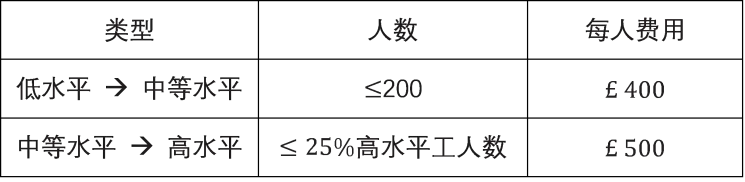
表格 4 培训类型、人数与费用
然而,也会存在降级现象,工人从较高水平降至较低水平。50%的降级工人会离开岗位(这部分人员没被算进表格2)。
- 裁员
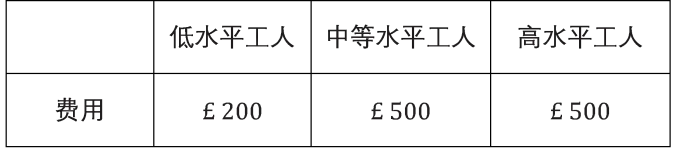
表5 裁员每人费用
- 人力过剩
公司最多可超额雇佣150名员工。
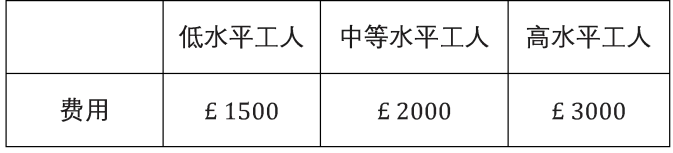
表6 过剩人员每年费用
- 缩短工时
每类人员中最多有50人可缩短工时。一名短时长员工只能满足全职员工50%的生产需求。
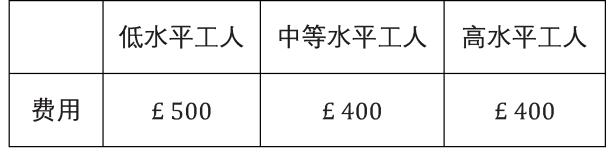
表7 短时长员工每人每年费用
二、模型建立
每年都会发生的人员变化:
-
新员工招募
-
工作1年以内的员工辞职
-
工作1年以上的员工辞职
-
员工培训或降级
-
裁员
-
过剩人员
-
短时长员工
变量
- 在职人员
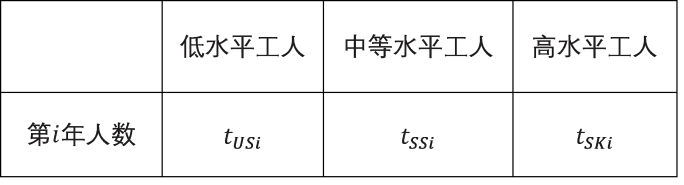
表8 第i年在职人数
- 招募人员
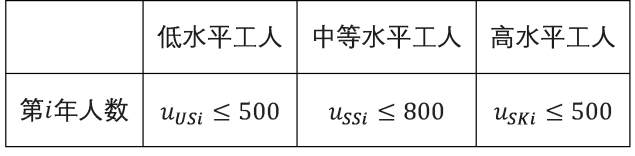
表9 第i年招募人数
- 培训人员
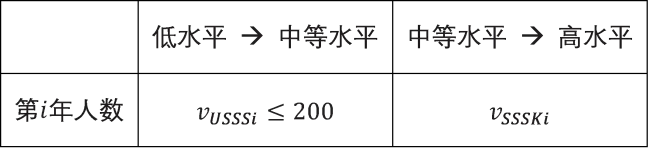
表10 第i年培训人数
- 降级人员
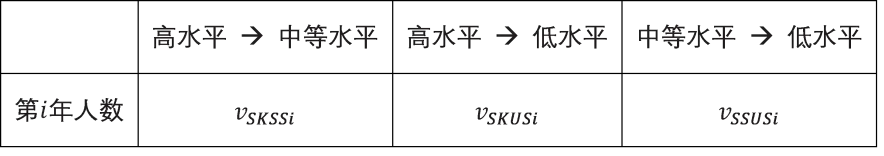
表11 第i年降级人数
- 裁员
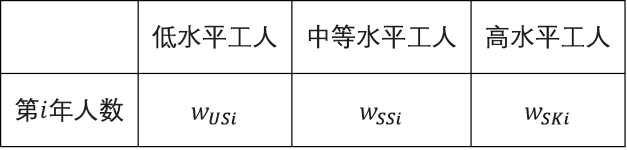
表12 第i年裁员人数
- 短时长人员
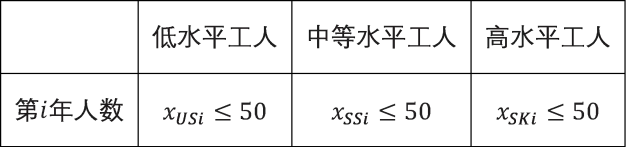
表13 第i年短时长人数
- 人力过剩
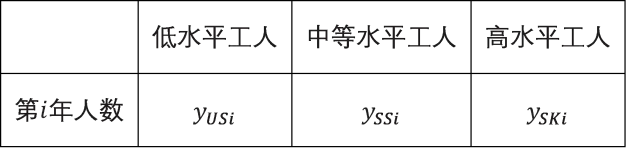
表14 第i年过剩人数
方程
- 初始条件
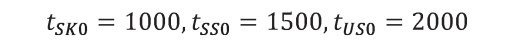
- 在职人数的两种表示
在职人数=去年未辞职人数+新招募且未辞职人数+培训且未辞职人数变动+降级且未辞职人数变动-裁员人数
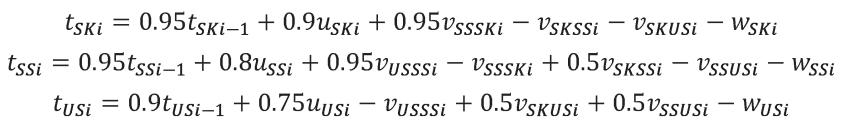
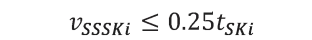
- 中等水平人员培训人数限制
- 过剩人数限制
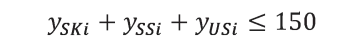
- 劳动力需求
劳动力需求=在职人数-过剩人力-短时长员工(根据劳动力)增加的人数
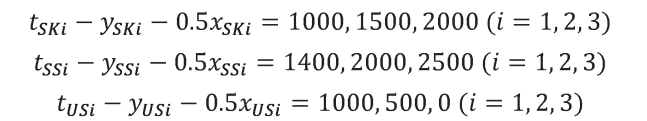
最少裁员
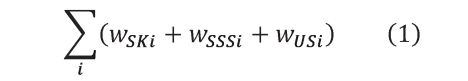
(1)式为总裁员人数,若要得到裁员最少的策略,需将其最小化。
最少花销
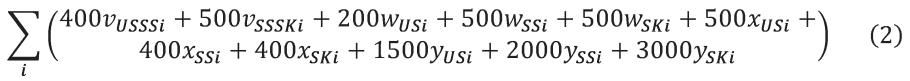
(2)式为花销总数,若要得到最少花销,需将其最小化。
三、程序流程
此处使用Python编程,运用Ortools求解模型。
-
输入并读取excel表格(含参数大小与变量范围)。
-
建立变量,并设置变量范围:招募人数u,培训人数v(up), 降级人数v(down), 裁员人数w, 短时长人数x, 人力过剩y。
-
添加限制条件,并计算在职人数。
-
设置目标优化函数。
-
求解模型,最终结果四舍五入(在求解过程中,会产生非常接近整数的浮点数)输出。
四、结果
最少裁员
- 招募人员
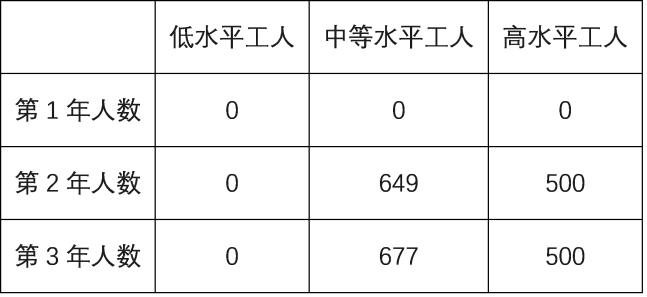
表15 (最少裁员)招募人数
- 培训人员
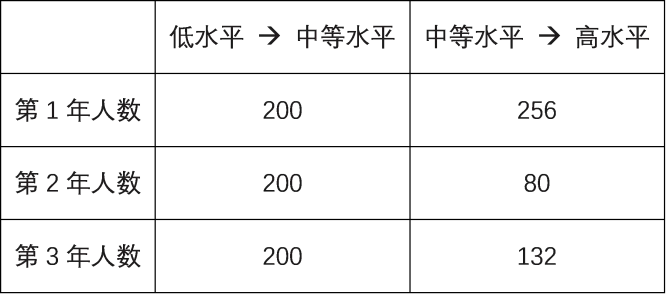
表16 (最少裁员)培训人数
- 降级人员
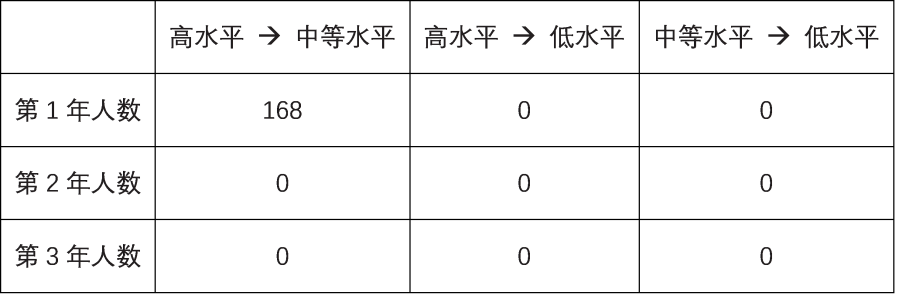
表17 (最少裁员)降级人数
- 裁员
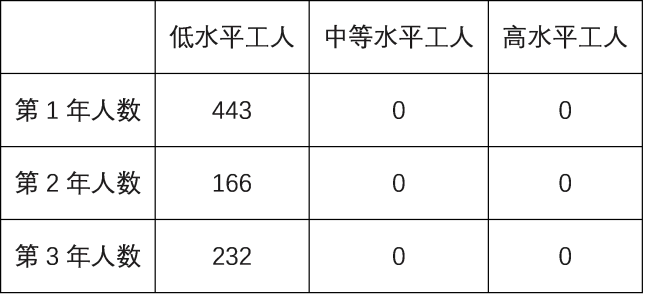
表18 (最少裁员)裁员人数
- 短时长人员
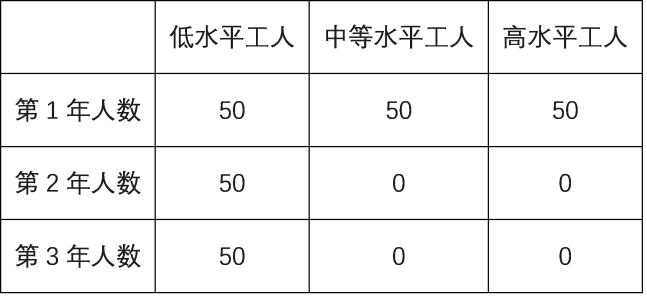
表19 (最少裁员)短时长人数
- 人力过剩
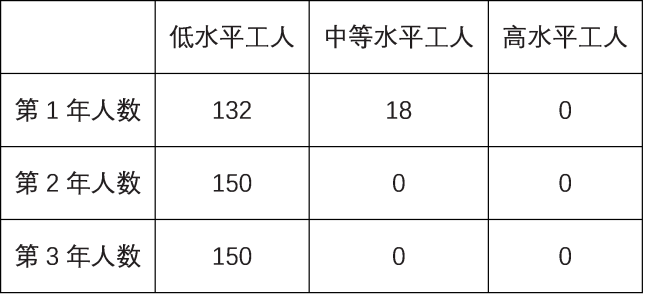
表20 (最少裁员)过剩人数
最少裁员人数为841,此时的花销为1441200。
最少花销
- 招募人员
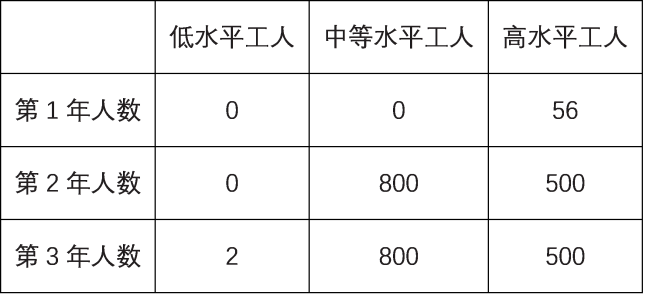
表21 (最少花销)招募人数
- 培训人员
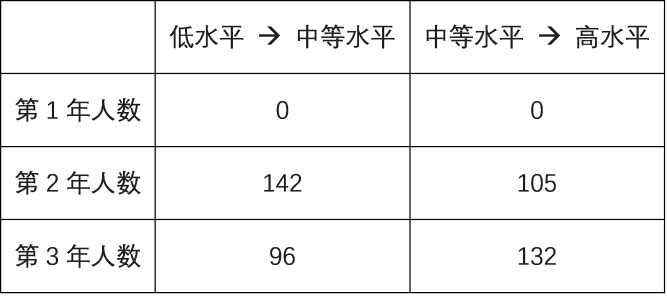
表22 (最少花销)培训人数
- 降级人员
表23(最少花销)降级人数
- 裁员
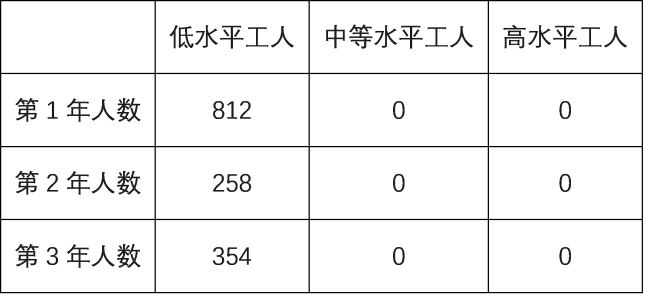
表24 (最少花销)裁员人数
- 短时长人员
表25 (最少花销)短时长人数
- 人力过剩
表26 (最少花销)过剩人数
最少开销为498500,此时的裁员人数为1424。相较最少裁员的情况,最少花销节省942700,裁员人数增加583。
五、视频展示
人力资源\.mp4
6. 食品加工企业生产计划 Food Manufacture(2024.10.26)
一、问题介绍
对于混合肥料生产、金属合金加工、食品生产等环节,考虑“最低成本”的初级生产要素投入是企业生产计划的重要考量。同时由于生产要素的可储存性,因此在企业年度、半年度、季度,生产计划时,需要同时考量市场采购成本、原料储藏成本等多个环节,从而实现最大利润。
为帮助制造企业更好地决策以上问题,久章智能现以油料食品加工厂半年期生产计划为例,给出久章智能在食品生产计划问题的场景化解决方案和求解展示。
首先,我们介绍在我们这个样例中的虚拟企业A所经营商品:假设食品加工厂出售两种最终商品来获取利润:混合植物油(例如橄榄油)和混合色拉油(例如大豆油),每一单位最终产品售价为¥150。
其次,我们给出虚拟企业A的生产技术,植物油需要两种原料植物油1:1混合生产(VEG1,VEG2),混合色拉油则需要三种非植物原料油(OIL1, OIL2, OIL3)1:1:1混合而成。不考虑混合时的油料损失,单位机器折旧也不考虑。
我们简化了一些现实问题,但为保证生产过程中的真实性,给与以下一些生产约束:
-
生产能力约束:植物油和非植物油精炼需要不同的生产线,任何一个月,植物油精炼量不会超过200吨,非植物油精炼量不会超过250吨,精炼过程中假设没有重量损失,精炼热成本和器械折旧忽略不计。
-
储存约束:企业没有采购相关昂贵设备,最终流体产品不能储存。
-
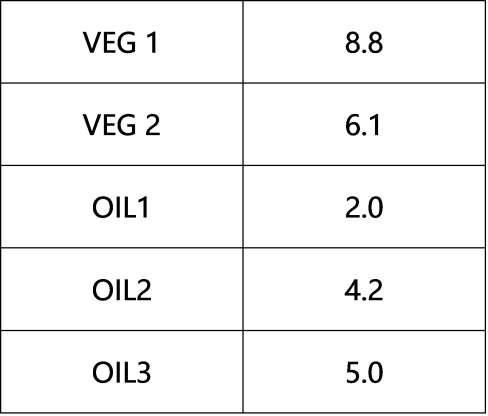
食品安全监管约束:同时最终产品的硬度存在技术限制。在测量硬度的单位中,硬度必须介于 3 和 6 之间。假设硬度呈线性混合,原料油的硬度为:
- 企业安全库存约束:计划开始时每种原油库存为 500 吨,要求在一期生产计划结束时,单位投入产品库存量一样,以防止投入要素的价格暴涨影响企业生产,即这些库存在 6 个月计划结束也存在。
在生产计划结束后,我们将补充考量采购和储藏成本的相关条件。
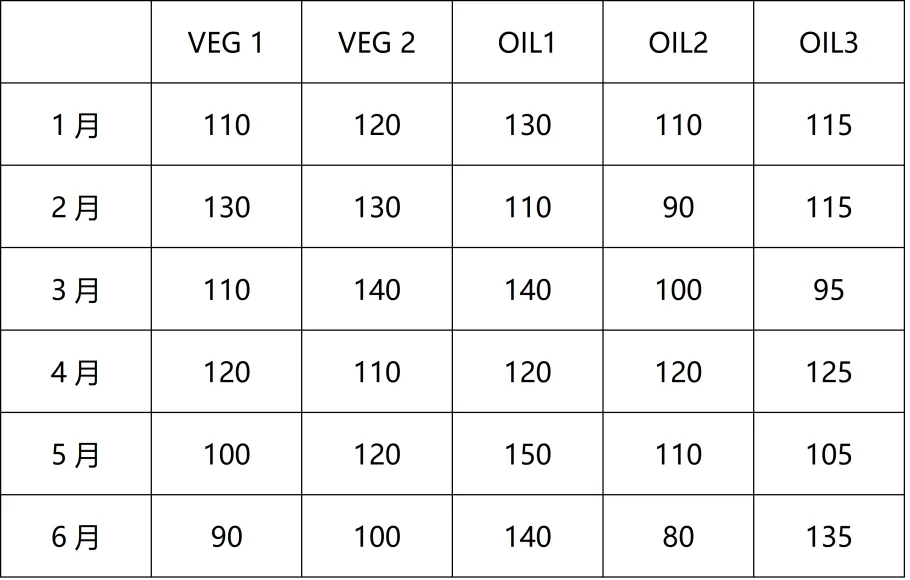
- 首先我们给出采购成本。每种生产要素都可以在每月初采购并投入生产,也可以在“期货市场”中购买,在指定月交付。在计划日当前,生产投入商品市场的价格如下(英镑/吨):
- 仓储约束:原料油最多可以储存 1000 吨以备后用。植物油和非植物油的储存成本为每吨每月 5 元。
为了实现利润最大化,公司应该采取什么样的生产计划策略?
二、数学模型建立
为了求解如上问题,本文建立一个跨期的生产决策的模型。
目标函数-净收益公式:
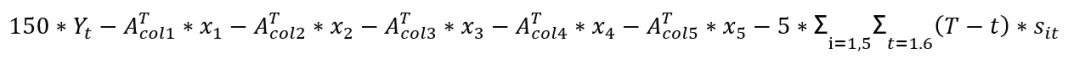
生产约束:
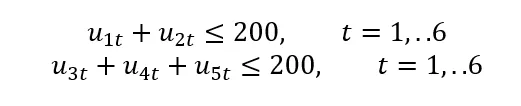
贮藏约束:
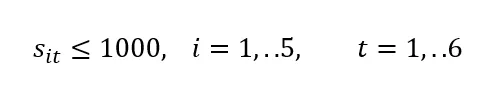
硬度约束:
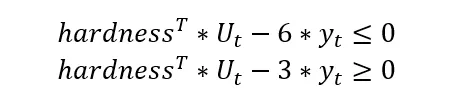
关系约束:
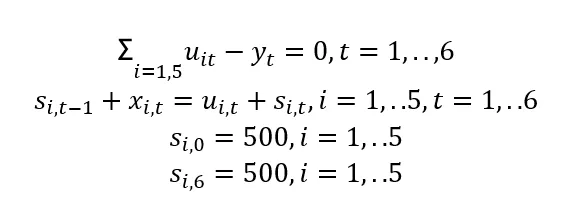
三、问题求解及应用展示
以下是我们开发的网页版求解器,可以导入其他数据,进行一键求解:
食品加工企业生产计划\.mkv
7. 火电机组发电申报边际电价和开停机建议研究 Tariff Rates (Power Generation)(2024.11.10)
一、问题描述
某集团企业A在某省内拥有多家发电厂拥有不同类型的发电机若干, 其签订了年度、季度、月、旬、日等合约合并后承诺在某天内不同时段满足下表1电力负荷需求。
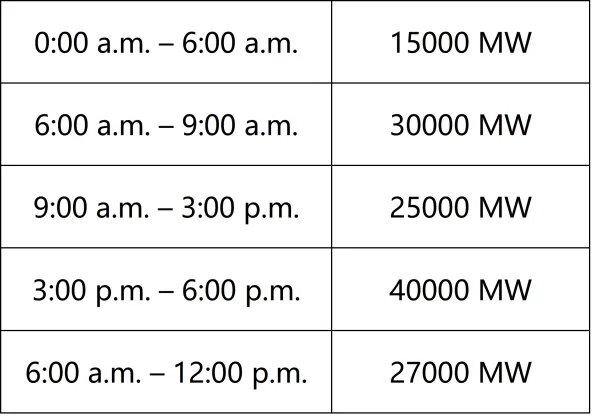
表1 某一天的电力需求
多家发电厂存在三种不同类型的发电机组若干,每组发电机组均存在热启动成本、最低运行出力、最高运行出力。如下表2:
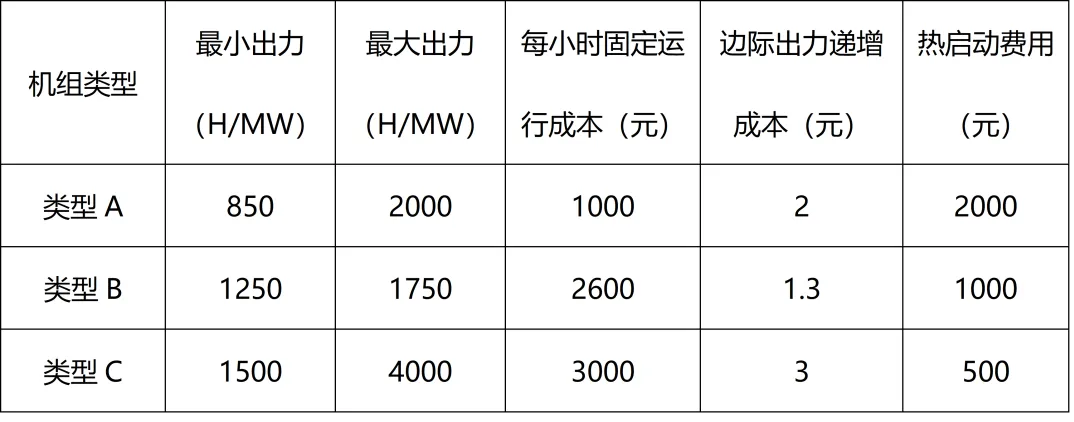
表2 发电机组出力
我们假设边际出力递增是随负荷增加的线性函数。
此外为保证用电出力安全,为防止某机组的突然故障,集团A规定在满足估计的负荷需求外,必须保证在每个时段开机的机组能满足临时高于15%估计负荷需求的增加。
为了满足用电需求的经济效益:
1)哪些机组应该在每天的什么时段开机,以使得总成本最小?
2)一天中每个时段电力生产的边际成本是多少?
3)15%的安全保障,需要增加多少费用?
二、数学模型建立
为了求解如上问题,本文建立一个跨期的生产决策的模型:
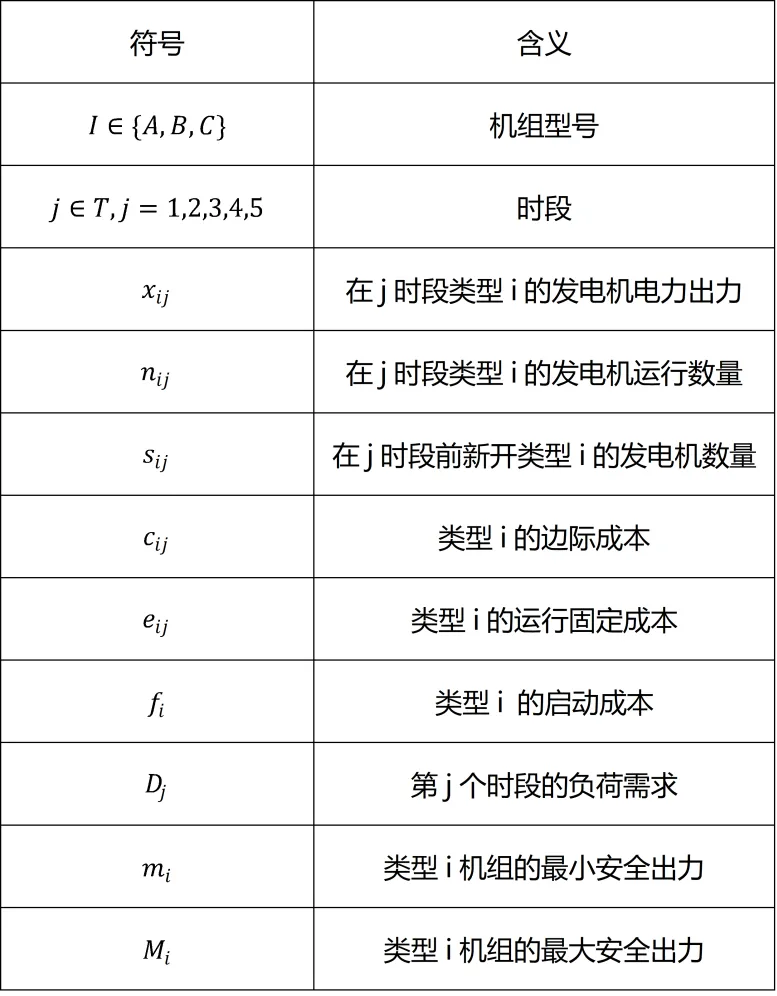
目标函数
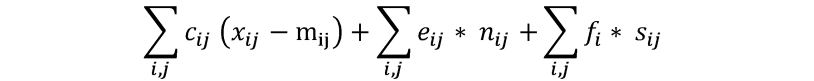
约束如下
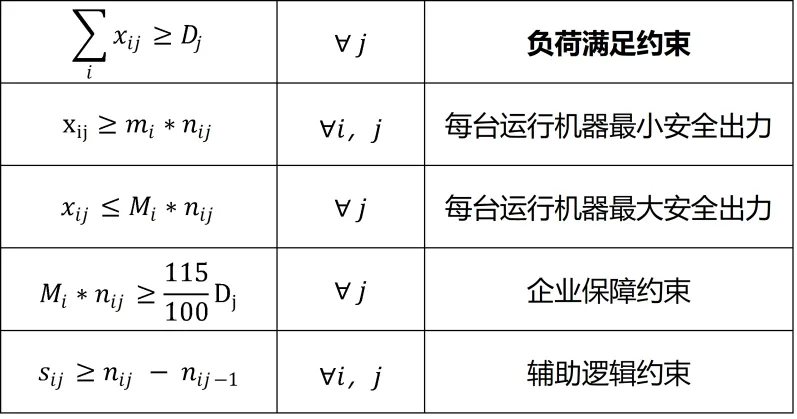
三、问题求解及应用展示
结果展示
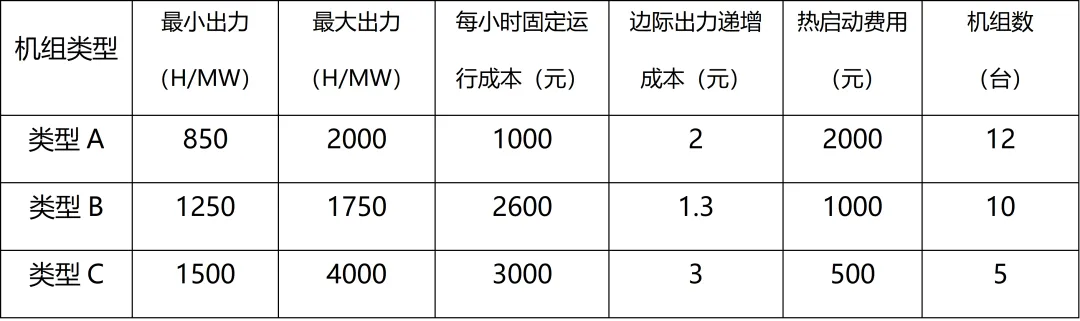
表3 机组资产
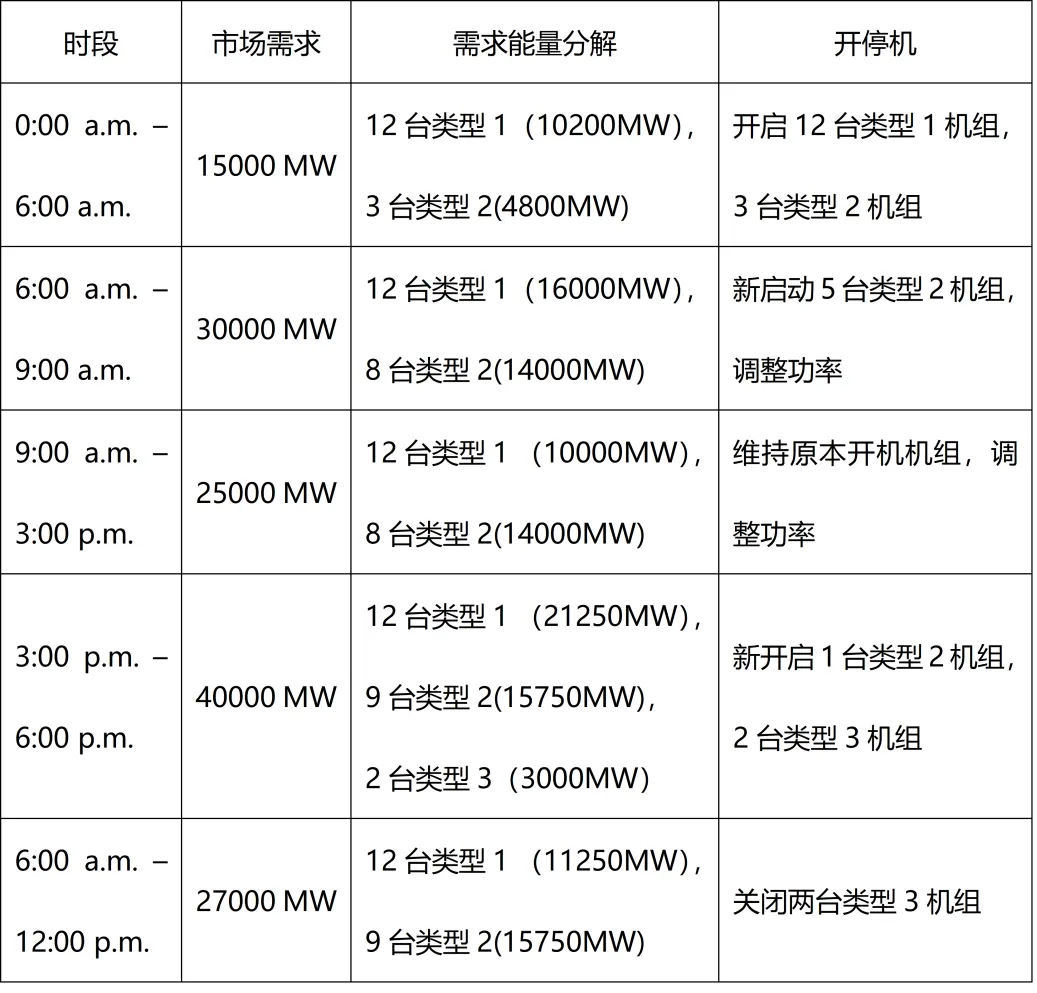
表4 机组出力与开停机建议
操作展示
火力发电厂发电机组调度\.mkv
8. 农产品定价问题 Agricultural Pricing(2024.12.26)
一、问题描述
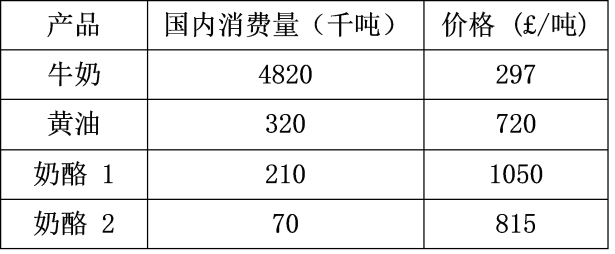
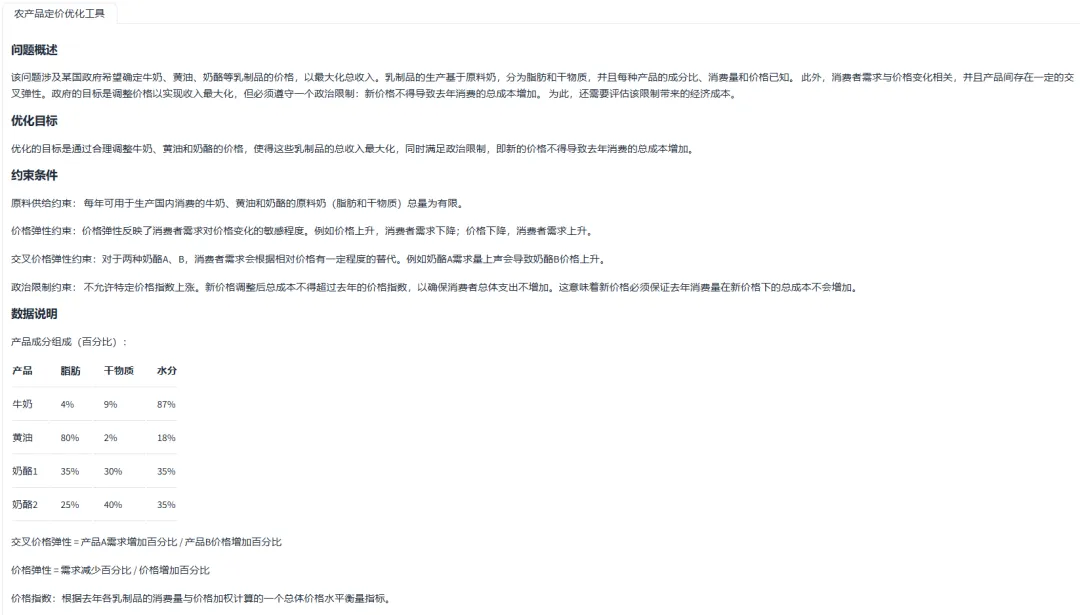
某国政府希望决定牛奶、黄油和奶酪等乳制品的价格。这些产品直接或间接来源于该国的原料奶生产。原料奶可以有效地分为两个成分:脂肪和干物质。在扣除用于出口或农场自用的脂肪和干物质后,每年总共可用于生产国内消费的牛奶、黄油和两种奶酪的原料是:600千吨脂肪和750千吨干物质。这些产品的成分百分比如表1所示。上一年,这些产品的国内消费量和价格如表2所示。
表1 某国乳制品的成分百分比
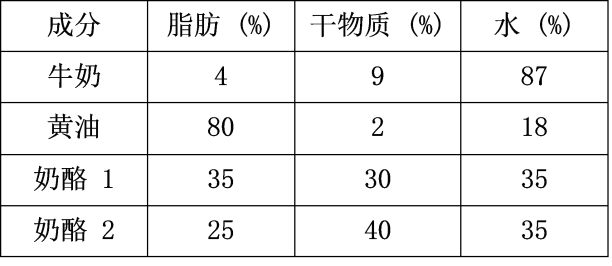
表2 某国乳制品的消费量和价格
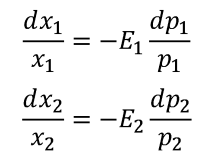
根据过去的统计数据,已计算出消费者需求与每种产品价格相关的需求价格弹性。产品的价格弹性E定义为:
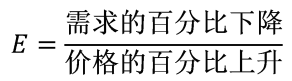
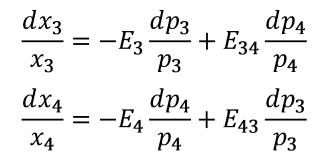
对于两种奶酪,当价格相对变化时,消费者需求之间会出现一定程度的替代关系。这种替代关系通过需求的交叉弹性来衡量。产品 A 对产品 B 的交叉弹性E(AB)定义为:
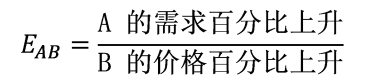
表3列出了各产品的弹性和交叉弹性数据。
表 3 各产品的弹性和交叉弹性
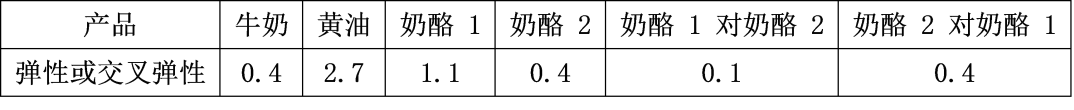
目标是确定价格及由此产生的需求,从而使总收入最大化。
然而,允许某个价格指数上升在政治上是不可接受的。由于该指数的计算方式,这一限制简单地要求新的价格必须确保去年消费的总成本不会增加。一个特别重要的附加要求是量化这一政治限制所带来的经济成本。
需要解决以下问题:
-
如何制定乳制品的价格,才能最大化总收入?
-
限制价格指数上升在政治上是不可接受的,如何量化这一政治限制所带来的经济成本?
-
若调整脂肪和干物质资源总量上限,最优定价方案会如何变化?
二、数学模型建立
为求解该问题,建立一个非线性规划问题。定义以下决策变量:
-
x(i):产品 i 的消费量(单位:千吨), i=1,2,3,4;
-
p(i):产品 i 的价格(单位:1000英镑/每吨);
此外,定义以下参数:
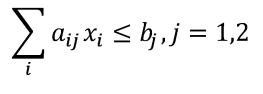
-
a(ij):产品 i 的第 j 种原料成分的占比, j=1,2;
-
b(j):第 j 种原料的最大供应量;
-
d(i):产品 i 去年的消费量(单位:千吨);
-
e(i):产品 i 去年的价格(单位:1000英镑/每吨);
-
P(c):价格指数,和去年的价格和消费量有关,P(c)=∑(i)d(i)e(i)/1000=1.939;
-
E(i):产品 i 的价格弹性;
-
E(AB):产品 A 对产品 B 的交叉弹性;
约束条件:
- 脂肪和干物质的有限供应约束:每种原料的总消耗量不能超过其最大供应量
- 价格指数的限制条件约束:新的价格必须确保去年消费的总成本不会增加
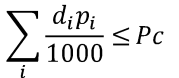
- 牛奶和黄油产品的弹性约束:产品的消费量和价格的关系
- 两类奶酪产品的交叉弹性约束:产品的消费量和价格、替代品的关系
目标函数:
目标函数是最大化总收入,即最大化每种产品的消费量和价格乘积的和,具体形式为:
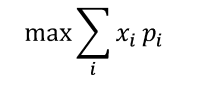
三、问题求解及应用展示
以下是我们开发的网页版求解器,可以调整参数,进行一键求解:
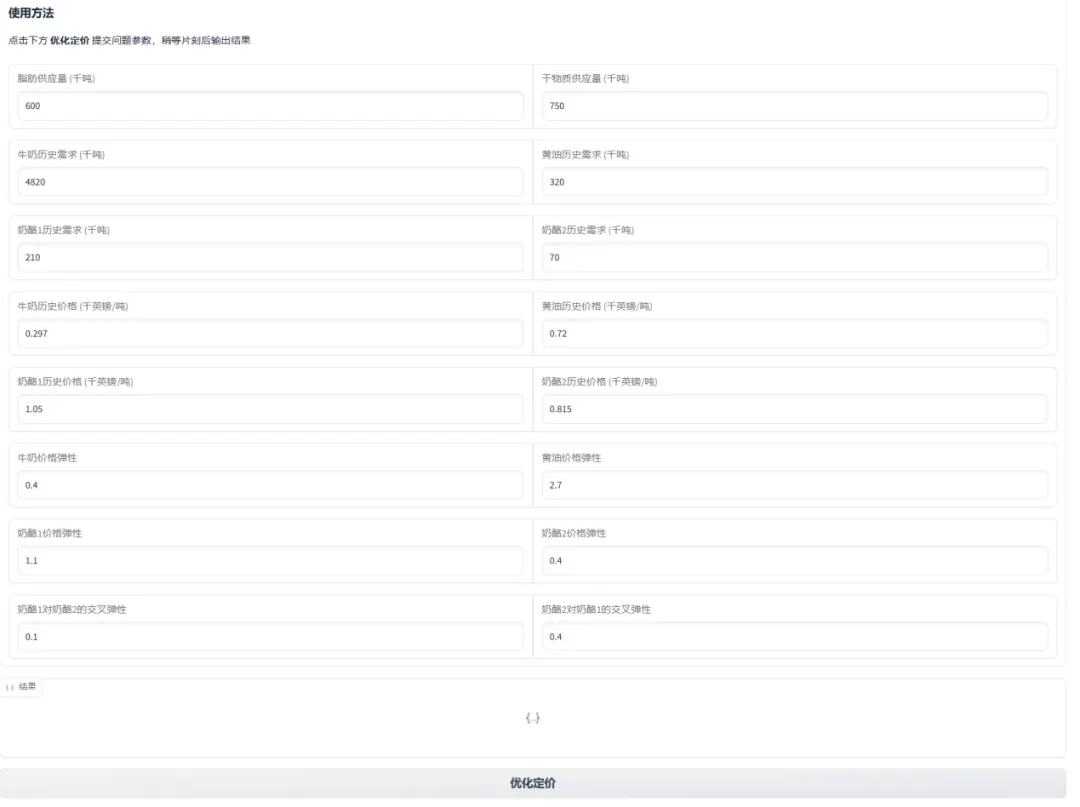
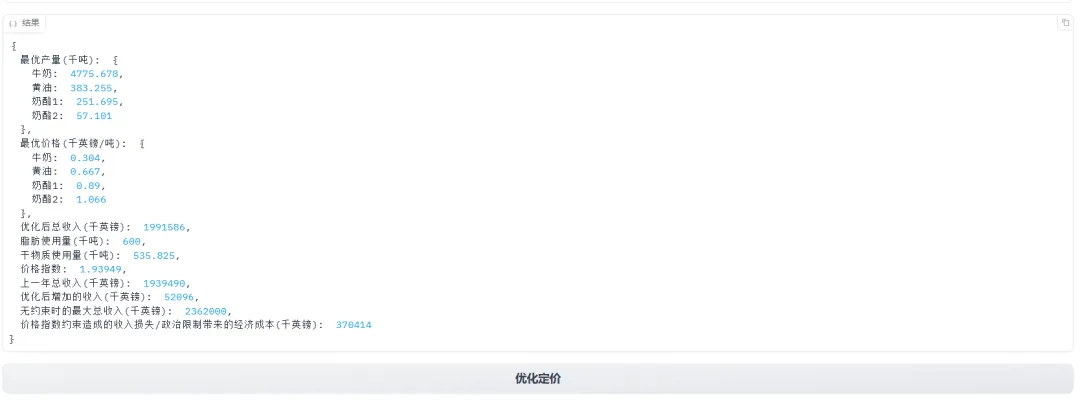
如下图所示,点击优化定价,求解器很快给出了最优结果:最优总收入为1991586千英镑,脂肪使用量为600千吨,干物质使用量为535千吨,比上一年增加的收入为52096千英镑。政治限制带来的经济成本为370414千英镑。
农产品定价\-Agricultural pricing\-演示视频\.mp4
农产品定价-Agricultural pricing-演示视频
9. 经济计划问题 Economic Planning(2025.1.5)
一、问题介绍
投入产出模型是一种广泛使用的经济规划模型,它反映了政府或企业不同产业或业务部门之间的经济相互关系。投入产出模型通常被认为是LP模型的一种特殊类型。
例如,一个经济体由三个产业组成:煤炭、钢铁和交通。每个产业的产出通常用于两个目的:
(1)直接消费,例如将煤炭出售给国内消费者;(外生需求)
(2)作为其他行业或经济部门的投入,例如为钢铁行业提供动力的煤炭。(内生需求)
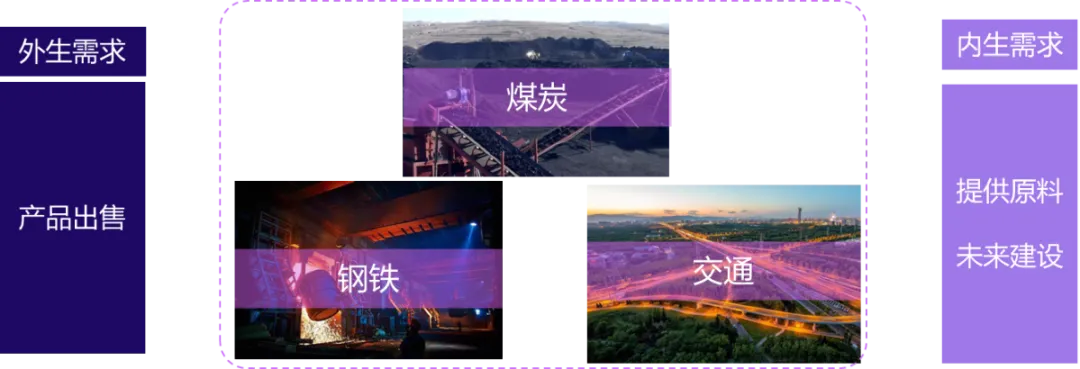
如何规划投入与产出量,以达到不同经济目的呢?我们展示一个简单案例。
煤炭、钢铁和交通的生产需要本身及其他产业的投入。如,生产钢铁的高炉需要煤,采煤的机器需要钢。假定投入产出成正比,投入量之间比例固定。由于经济中存在时滞,t+1年的产出需要t年投入。表1给出了单位(价值1英镑)产出所需的投入和人力需求。
表1 各产业单位产出所需的投入和人力需求
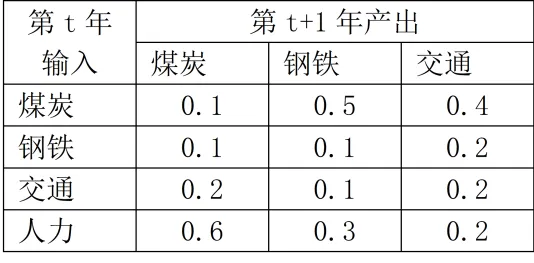
每个产业的产出也可用于未来几年为本身或其他产业扩大生产能力。t年某个行业的投入使得t+2年生产能力的永久增加。表2给出了增加单位(价值1英镑)生产能力所需的投入。
表2 增加单位生产能力所需的投入
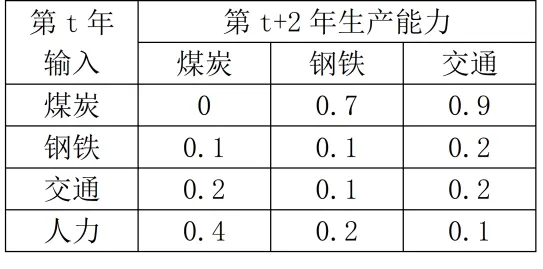
货物库存可以逐年持有。表3列出了目前(第0年)的库存和生产能力(每年)(单位:百万英镑)。每年的人力容量有限,为4.7亿英镑。
表3 目前(第0年)的库存和生产能力
希望调查未来五年经济可能的不同增长模式。特别是,希望了解追求以下目标将产生的增长模式:
(1)在五年结束时最大限度地提高总生产能力,同时满足每年6000万英镑的煤炭,6000万英镑的钢铁和3000万英镑的运输的外源消费要求(除了第0年)。
(2)在第四年和第五年最大化总产量(而不是生产能力),但忽略每年的外生需求。
(3)最大化总人力需求(忽略人力容量限制),同时满足(1)的年度外生需求。
在不同的优化目标下,我们需要给出以下决策:
直接决策:
• 各产业的每年产出量
• 每年各产业新增生产能力
间接决策:
• 每年期初库存水平
• 各产业用于第t+1年产业投入的产出量
• 各产业用于第t+2年产能扩大的产出量
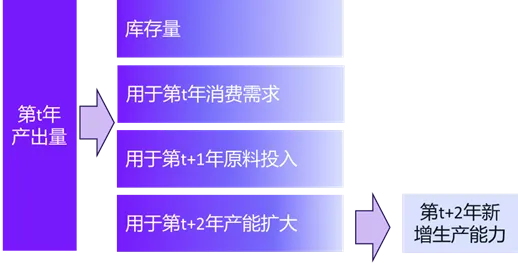
二、构建数学模型
- 决策变量
-
x(it)= t年第i个产业的总产量(i =C(煤),S(钢),T(运输),t =1,2,...,5)
-
s(it)= t年初第i个产业的库存水平(t =2,3,…,6)
-
y(it)=第i个产业在t年生效的额外生产能力(t =3,4,…,7)
其他符号:
-
e(i)表示第i个产业的消费需求,
-
c(ij)表示第t+1年j产业单位产出需要第t年的i产业投入,
-
d(ij)表示第t+2年j产业单位产出需要的第t年i产业投入
- 模型约束
(1)需求量与产出量平衡
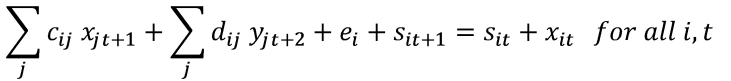
(2)人力能力限制
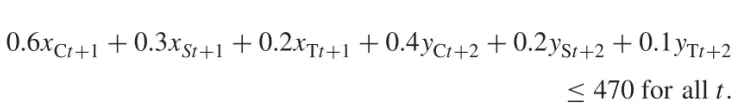
(3)生产能力限制
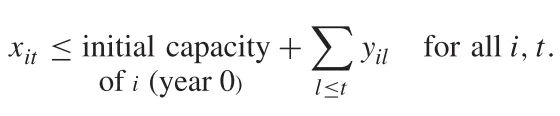
为了建立一个现实的模式,有必要考虑五年期结束后的情况。如果忽略第六年及以后年份的外生需求,将导致第五年没有投入。因此,我们假设外生需求在第5年之前和之后保持不变,库存水平保持不变,并且在第5年之后生产能力没有增加。
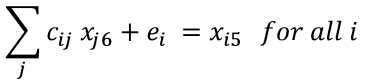
x(i5)是第5年及以后第i产业的(静态)产出。这组三个方程给出了变量的下限,
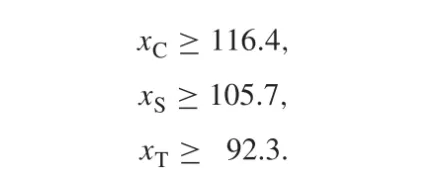
在上面的总输出约束中,对于t=5, x(i5)将被设置为大于或等于这些值。对于t≥6,y(it)将被设置为0, s(it)=s(i5)
- 目标函数
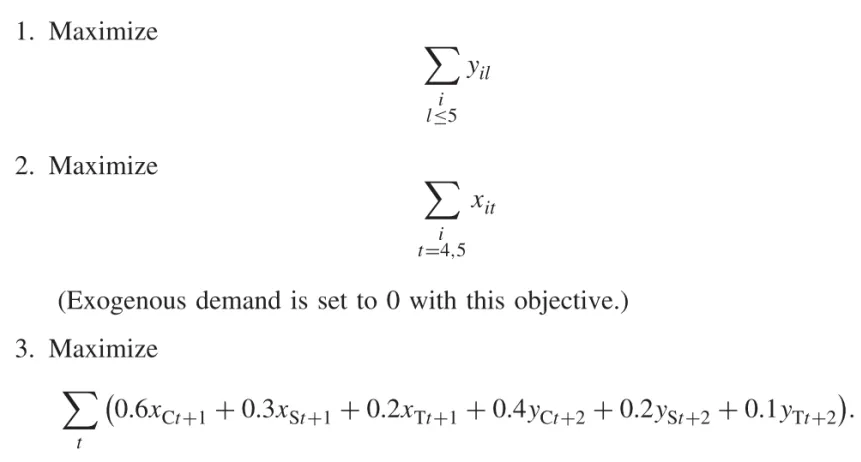
在这个目标下,人力限制被忽略。该模型有45个变量和42个约束条件。
三、求解结果
按照第一个目标(第5年总生产能力最大化),表4所示的增长模式使第5年的总生产能力达到21.42亿英镑。数量按百万英镑计算。
表4 目标1下的经济增长模式
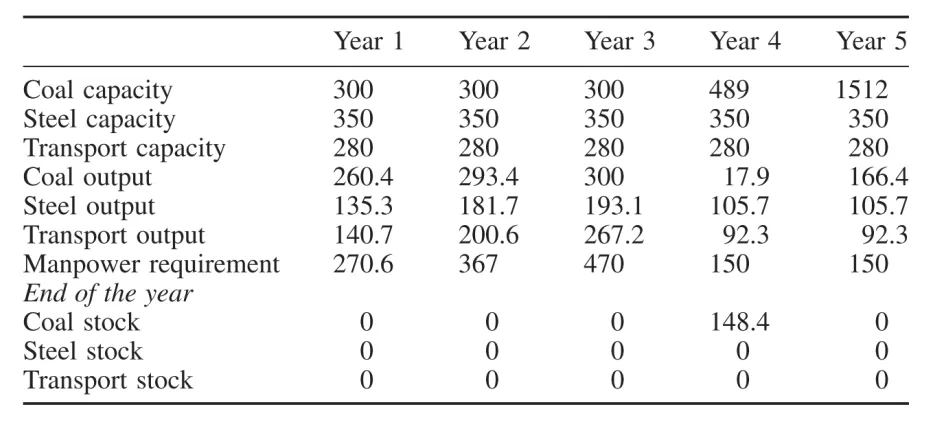
按照第二个目标(在第四年和第五年使总产量最大化),表5所示的增长模式使得这两年的总产量为26.19亿英镑。
表5 目标2下的增长模式
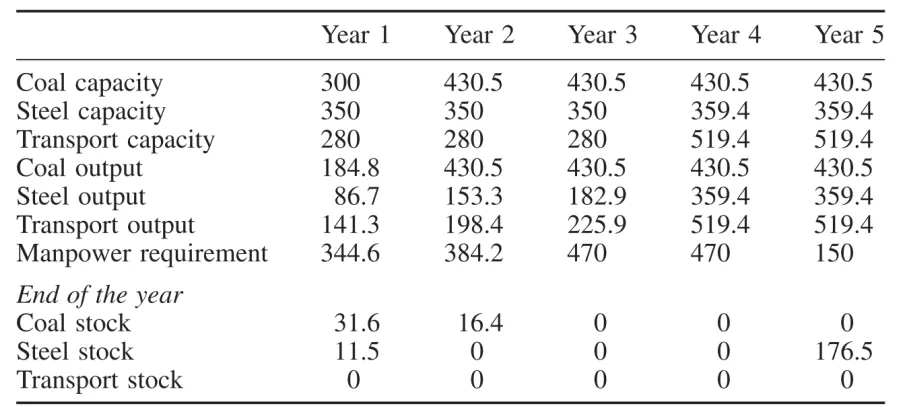
按照第三个目标(最大限度地提高人力需求),表6所示的增长模式导致总的人力使用量为24.5亿英镑。
表6 目标3下的增长模式
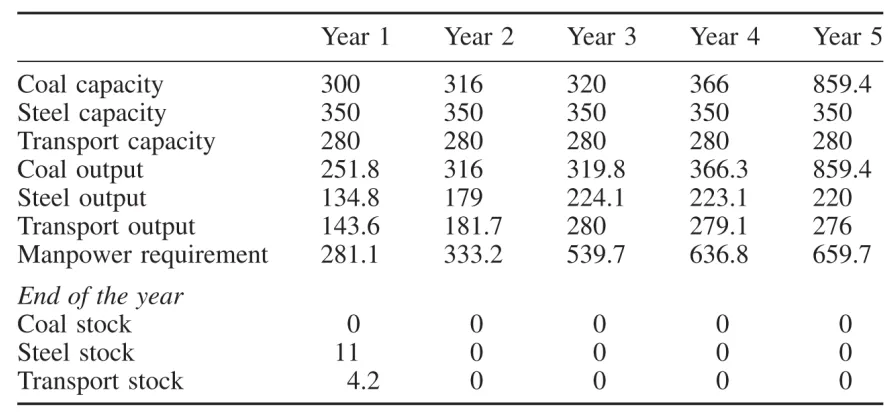
第一个目标显然导致集中努力建立煤炭工业的能力,这是因为额外的煤炭产能的生产使用了相对较少的其他产业的产出。第二个目标是在运输业方面多下工夫,部分原因是运输业比其他产业使用较少的人力。第三个目标下煤炭工业再次繁荣,是由于煤炭工业需要大量的人力。
四、试用展示
经济计划问题\.mp4
参考文献
[1] Williams, H. P. (2013). Model Building in Mathematical Programming (5th ed.). Wiley.
10. 精准预测+动态补货,久章智能DDMRP方案解决库存痛点(2025.4.18)
随着供应链管理复杂性的持续升级,企业面临的需求波动日益加剧、库存压力不断攀升,同时市场对响应速度的要求也不断增长,而传统的物料需求计划(Material Requirements Planning, MRP)因过度依赖历史数据预测,难以适应实时变化。需求驱动物料需求计划(Demand Driven Material Requirements Planning, DDMRP)作为一种创新的物料控制与补货方法,以实时需求信号为核心,结合动态缓冲库存管理,优化供应链的运作模式。传统MRP是“推动式”方法,指基于预测和历史数据提前计划生产和补货,将物料推向供应链下游,即使需求尚未明确;而DDMRP通过“拉动式”补货,根据实际需求信号触发补货,物料在供应链中被拉动,以更灵活地响应实时变化。DDMRP相比MRP能快速应对供应链中的不确定性与复杂性,为企业带来更灵活、更高效的解决方案。
DDMRP的核心在于其“布局、保护、拉动”三大流程:首先通过历史数据与需求预测识别关键物料位置和战略性商品,确保聚焦高价值的品类;其次结合预测模型与动态缓冲库存管理,保护关键品的可用性,防范需求波动的风险;最后基于实时需求信号和短期预测结果触发拉动式补货,并借助可视化系统监控和调整库存状态。这种方法将预测融入补货决策,降低了库存积压与缺货风险,显著提升了供应链效率,尤其适用于日用百货、生鲜食品等需求波动频繁的行业。
**DDMRP商品核心关键品预测方案 **
针对传统MRP预测滞后、库存效率低的问题,久章提出了基于DDMRP框架的商品核心关键品预测方案,解决了库存成本高、缺货响应慢、需求波动适应性差的问题,提升了核心品收益与客户满意度。
方案聚焦于商品核心关键品的管理,通过销量维度(畅销品)、利润贡献维度(高毛利商品)及供应链流动性维度(采购周期短、响应快)筛选高价值商品,并结合历史数据与短期预测模型构建针对性缓冲策略。同时,方案利用实时库存、销售模式和供应链信号,动态调整“绿/黄/红”缓冲区间,确保补货既及时又高效。
在技术层面,久章智能融合多种预测模型,包括时间序列模型(ARIMA/Prophet)捕捉长期趋势,机器学习方法(XGBoost/随机森林)精准预测短期需求,以及深度学习技术(LSTM/Transformer)分析复杂需求模式。在静态层面,方案基于历史数据设置初始缓冲区;在动态层面,则通过销售速度与库存周转率实时优化,确保库存管理与实际需求无缝衔接。
在实施步骤上,久章智能打通销售、库存、物流等动态数据源,采用分阶段试运行策略,从核心关键品类入手验证预测与补货的匹配度,逐步集成企业ERP、终端POS和供应链管理系统进行部署。
基于DDMRP框架的商品核心关键品预测方案的应用价值显著:
**· **在生鲜场景中,通过高频销售数据预测销量波动并定义缓冲区间,实现拉动式补货,避免积压与缺货。
· 在百货场景中,通过长期预测(补货提前周期)和短期调控(补货动态调整) ,优化商品的库存周转率与有效供应。
**· **在全渠道场景中,打通门店、仓库与线上平台的数据,实现同步库存管理。打通消费需求与供应链实时信息,通过DDMRP快速调整供应链计划。
在未来,久章智能计划通过引入AI与IoT技术实现实时库存监控,实现无缝动态调整。通过多频次循环分析与调整,方案形成预测-拉动闭环,不断优化模型参数和DDMRP策略,最终提升预测精度与运作效率。根据分区销售特性,方案还可扩展至全国多门店场景,实现可复制推广。
以下是久章智能既往的智能预测解决方案展示。
01 某国际著名电子企业动线项目物流需求预测
久章智能在某国际著名电子企业的项目物料需求预测项目中,展示了其在需求预测领域的深厚实力。该项目通过每日滚动更新数据,确保库存管理的高效性和准确性。客户每日发送的拣货单数据经清洗后,与物流历史需求数据一同输入算法平台,生成物料热度评分、关联度分析和未来需求预测。
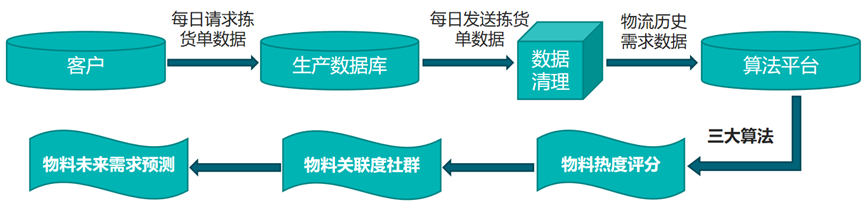
电子企业动线项目场景流程图
核心算法包括ARIMA模型,用于捕捉物料需求的趋势与季节性波动;热度评分算法识别高需求物料;关联度分析挖掘物料组合规律。
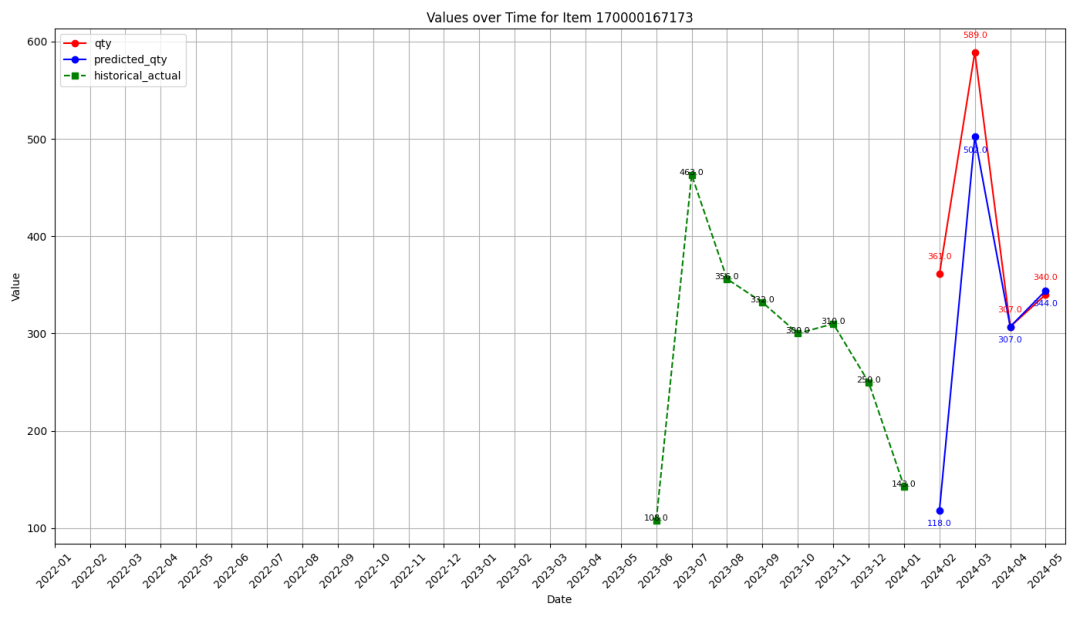
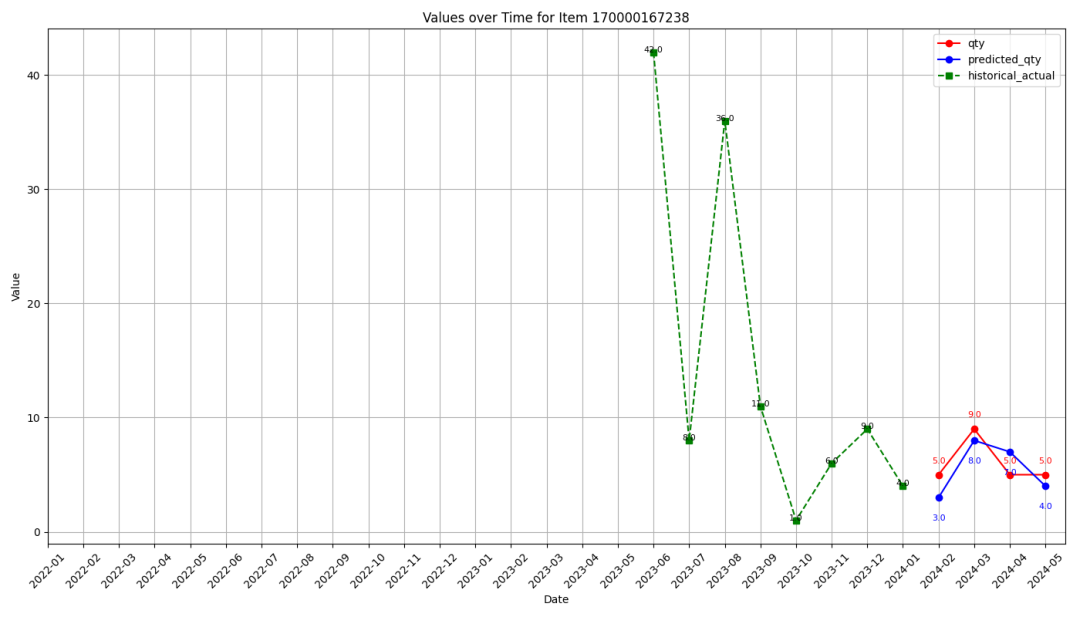
ARIMA模型效果图
使用2024年2月1日到2024年5月25日(共115天)的预测数据和实际需求数据进行对比,包含了仓库内2157个物料项目。测试结果如下。
物料未来需求预测效果表
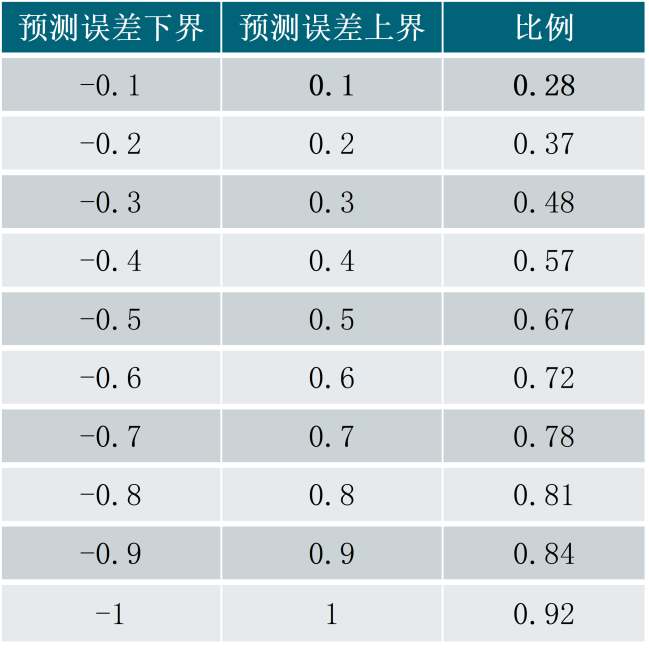
测试结果显示,该方案在覆盖2157个物料、115天预测周期中,预测误差大部分控制在±30%以内,库存管理效率显著提升。方案帮助某国际著名电子企业优化物料补货计划,降低库存积压与缺货风险。这一案例充分验证了久章智能在复杂供应链场景中提供精准预测与动态调整的能力。
02 某家电品牌冰箱多渠道销售预测
针对某家电品牌冰箱的多渠道销量预测项目,久章智能采用CatBoost模型,基于滞后特征的监督学习,助力优化库存、营销策略和生产计划。
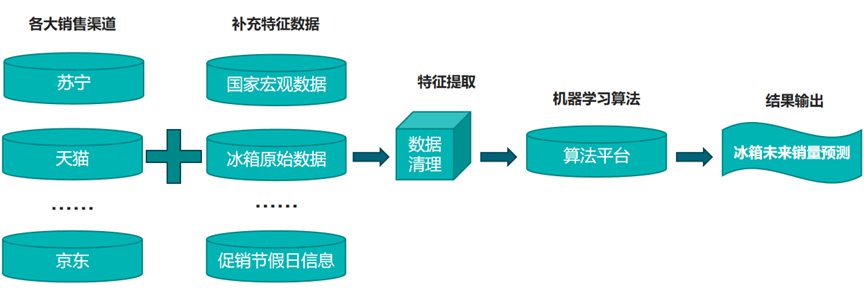
某家电品牌冰箱销量预测项目流程图
训练数据包括2021年3月至2024年4月的销售数据,涵盖京东、天猫、苏宁等渠道,以及促销节假日、国家宏观数据等多维特征。关键特征如折扣力度、月份、销售渠道和前月销量显著影响预测结果,反映了季节性波动与市场行为的复杂性。
冰箱销量预测效果表
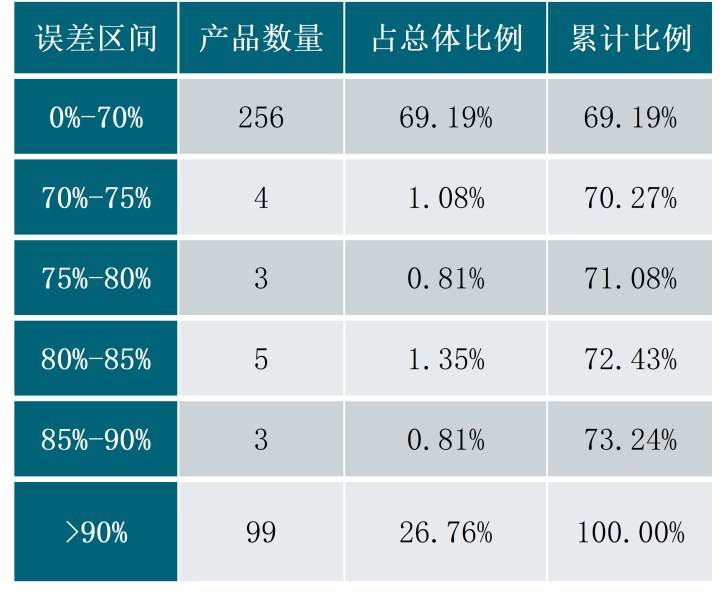
最佳预测案例表
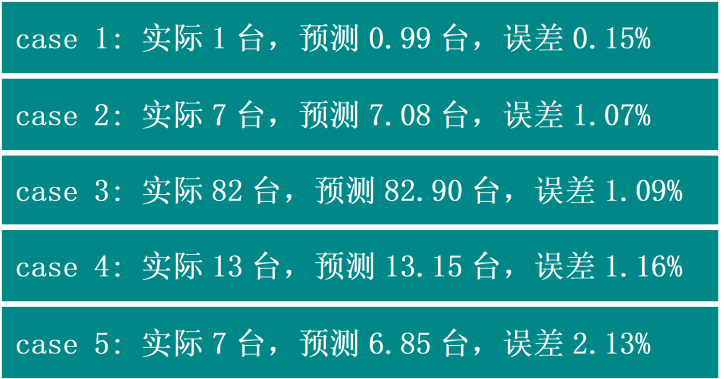
预测结果显示,超过70%的产品误差在70%以内,中位数误差仅0.07%,最佳案例如实际销量82台、预测82.90台(误差1.09%),展现了高精度预测能力。这一项目凸显了久章智能在多渠道预测中的技术优势。
总结
久章智能基于DDMRP框架的商品核心关键品预测方案,通过精准的需求预测与动态补货策略,为企业提供了应对供应链复杂性与不确定性的高效解决方案。从某国际著名电子企业智能动线项目到某家电品牌冰箱销量预测,久章智能凭借先进算法与实战验证,显著提升了库存管理效率、降低了运营风险,并助力企业实现收益与客户满意度的双赢。
未来,随着AI与IoT技术的深度融合,久章智能将继续优化预测-拉动闭环,为更多行业带来灵活、可扩展的供应链管理新范式。
11. 三维井字棋问题 Three-Demensional Noughts and Crosses(2025.9.9)
三维井字棋问题(Three-Demensional Noughts and Crosses)是一个经典的组合优化难题,本文内容涵盖了三维井字棋同色连线最少化问题的背景介绍、整数规划变量与约束建模、求解结果及最优布局展示。
一、问题描述
如下图所示,27个单元格按照的三维数组排列。
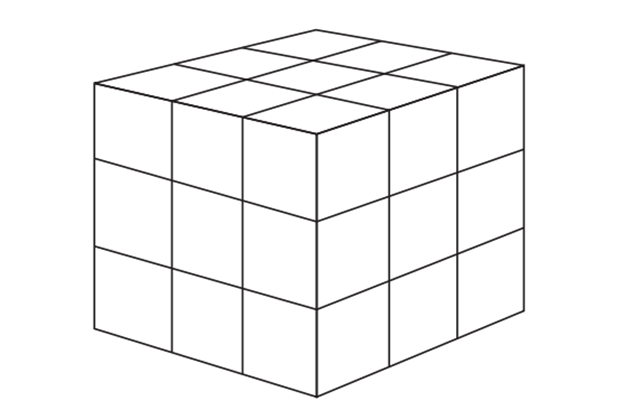
如果三个单元格在同一条水平线、垂直线或对角线上,则认为它们在同一直线上。每个水平面和垂直面上都存在对角线,连接着立方体的对角顶点(总共有49条线:横竖+面对角线+4对角线) 给定13个白球(圈)和14个黑球(叉),我们的目标是将它们全部放置到单元格中,使得同色球在同一直线上的数量最小化。
这个问题典型地代表了整数规划问题的组合特性。显然,在三维空间中排列棋子的方式存在无穷可能,这类问题作为整数规划模型求解往往极为困难。采用启发式解法可获显著优势:所得解可作为分支定界树搜索的阈值(详见8.3节)。Williams(1974)曾探讨该问题的两种建模思路,下文将介绍其中更优的方法。
- 变量
先按行再按照切面逐个对单元格进行顺序编号,编号为1到27。为每个单元格 j 引入一个 0-1 变量δ(j)。若δ(j)等于1,代表单元格内为黑球,若δ(j)等于0,代表单元格内为白球。
立方体中有49条可能的线。为每条线引入一个0-1变量γ(i),γ(i)等于1代表线内所有球的颜色相同,反之γ(i)等于0。
- 约束
定义每条线 i 的同色标识变量γ(i),通过以下约束确保其逻辑关系:
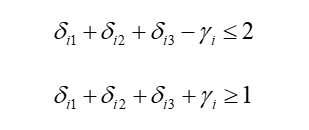
(i=1, 2, ..., 49,共49条线,每条线对应3个单元)
实际上,这些约束并不能确保如果γ(i) = 1,线中的所有球都是同一种颜色。当目标被公式化时,将清楚地看到这个条件将由最优性保证。
限制黑球总数:
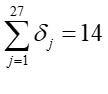
- 目标
最小化同色线的总数:
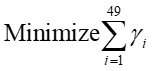
这个模型总共有99个约束和76个0-1变量。
- 结果
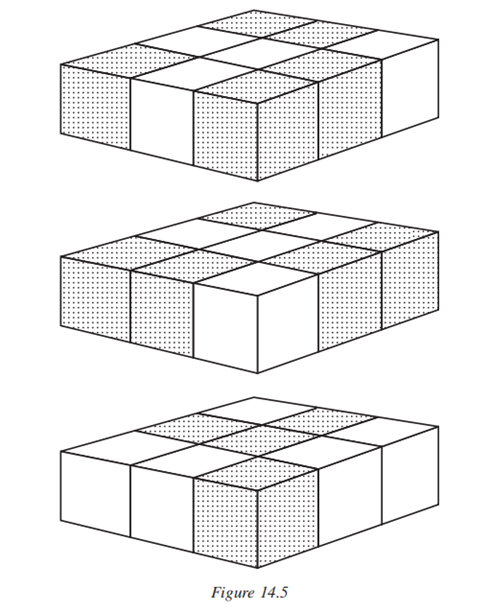
同色球连成直线的最小数量为四条。存在多种解法方案,图14.5展示了其中一种。
三、前沿技术
1. MAPF问题介绍(2024.10.20)
01 MAPF问题的背景
传统的车辆路径规划问题(Vehicle Routing Problem, VRP)是物流领域最常见的一类路径规划问题,要求在满足一定条件下为多个车辆设计路径,以最低成本完成任务,比如配送货物到多个客户点。VRP的复杂性主要源于全局任务分配、调度优化以及资源限制,是一类经典的组合优化问题,通常采用全局优化算法,如遗传算法、禁忌搜索、模拟退火、混合启发式等,寻找一个满足所有约束条件的最优解或近似最优解。
然而,随着物流自动化和智能机器人技术的不断发展,特别是无人驾驶车辆(AGV, Automated Guided Vehicle)的广泛应用,路径规划的挑战不再仅仅是全局任务的优化,而是如何在复杂、动态的环境中协调多个自主智能体的行动。这意味着,不仅要考虑车辆的最优路径,还要确保多个智能体在同一空间内移动时不会发生冲突,实时协作成为了新的难题。
正是在这样的背景下,一类更微观的路径规划问题走入我们的生活中:多智能体路径规划问题(Multi-Agent Path Finding, MAPF)。多智能体路径规划(MAPF)是一个在共享环境中为多个智能体规划无碰撞路径的问题,近年来,MAPF的研究蓬勃发展,其应用包括自动化仓库和自动驾驶车辆。智能体在共享空间中移动,每一个时间点、每一条路径都有可能与其他智能体或是静态障碍物产生碰撞,因此MAPF更多的是一类实时协调问题,关键约束是多个智能体同时沿着规划路径行进而不会发生冲突,其复杂性来自于时空维度的智能体协作,特别是在大规模智能体环境下,如何在有限的空间和时间内为每个智能体设计无冲突的路径,是其主要的难点。
02 MAPF问题的描述
具有k个智能体的经典MAPF问题的描述是:
定义一个元组 (G,s,t )。其中 G=(V,E) 是一个无向图,无向图中的节点 v ∈V 是智能体可以占据的位置,边 (n,n’) ∈ E 表示智能体从节点 n 移动到 n’ 的连线。s 是初始位置的集合,每个智能体都有一个起始位置 s(i )∈ s;t 是目标位置的集合,每个智能体都有一个目标位置 t(i) ∈ t 。假设时间和空间都被离散化为固定的步长和网格,同时假设智能体的动作也是离散的。在每个时间步长中,每个智能体位于图节点之一并可以执行一个动作,一般有五种类型的动作:向上、向下、向左、向右和等待,其中移动动作只能从当前节点 v 移动到图中的相邻节点 v’ ( ( v, v’ ) ∈ E),移动时不考虑智能体的运动速度以及体力消耗等影响因素。定义动作为函数 a : V → V,即 a(v)=v’ 表示如果智能体位于顶点 v 并执行动作 a,那么它将在下一个时间步中位于顶点 v’ 。一个单智能体的路径规划是从起始位置到目标位置一系列动作的集合 π= (a(1), a(2), ... , a(n) ),k 个智能体的路径规划问题就是 k 条路径的集合 Π={π(1),π(2), ... ,π(k)},其中第 i 个智能体对应路径π(i)。
03 MAPF的冲突类型
当且仅当任何两个单智能体的路径规划之间不存在冲突时,MAPF的求解方案才称为有效。经典MAPF问题中常见的冲突类型有:
边冲突:π(i )和 π(j )之间发生边冲突,当且仅当智能体i和智能体j在相同时间步沿相同方向遍历相同的边。
顶点冲突:π(i )和 π(j )之间发生顶点冲突,当且仅当智能体i和智能体j在同一时间步占据同一顶点。
跟随冲突:如果一个智能体计划占据前一个时间步中另一个智能体占据的顶点,则 π(i )和 π(j )之间会发生跟随冲突。
循环冲突:一组单智能体路径 π(i),π(i+1), ... ,π(j) 之间发生循环冲突,当且仅当每个智能体移动到前一个时间步中被另一个智能体占据的顶点并形成“旋转循环”模式。
交换冲突:π(i )和 π(j) 之间发生交换冲突,当且仅当智能体i和智能体j在单个时间步内交换位置。
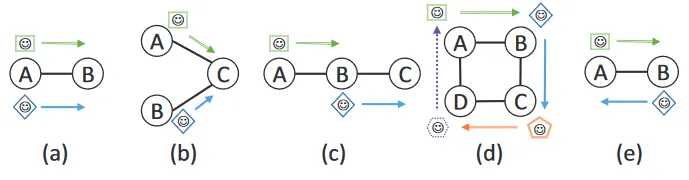
图 1:常见冲突类型的说明。从左到右:边冲突、顶点冲突、跟随冲突、循环冲突、交换冲突。
04 MAPF的类型
在经典MAPF问题中,每个智能体根据分配的任务已知起点和目标终点。按照任务分配的不同,经典MAPF问题可以拓展为以下三类:
匿名MAPF:在此MAPF变体中,目标是将智能体移动到一组目标顶点,但哪个智能体到达哪个目标并不重要,即其中每个智能体都可以分配给任何目标,但它必须满足智能体和目标之间一对一映射的关系。类似于滴滴打车场景。
分组MAPF:在此MAPF变体中,智能体被分组为团队,每个团队都有一组目标顶点,需要将每个团队中的智能体移动到他们的目标顶点,其中每个智能体只能从为其团队指定的目标顶点集中分配到目标。类似于外卖分区域性派单场景。
动态MAPF:在此MAPF变体中,智能体在到达目标顶点时接收新任务,并且随着时间的推移图中可以出现新的智能体,所有智能体会不断接收新的任务并持续行动,规划不仅仅是针对单次任务,而是终生优化。
05 MAPF求解算法的类型
按照规划方式不同,MAPF算法分为集中式规划算法和分布式规划算法。集中式规划算法需要获悉所有智能体的起始位置、目标位置以及障碍物位置等信息,在集中调度中,地图信息由与每台智能体通信的中央服务器存储,中央服务器掌握所有智能体的状态与路径信息,负责将任务分配给各台智能体、下达任务指令并为每台智能体规划无碰撞的最优路径。集中式规划算法可以分为基于A*搜索、基于冲突搜索(Conflict Based Search, CBS)、基于代价增长树和基于规约四类,其在求解过程中更注重解的质量。后续我们将会为大家详细介绍基于A*搜索和基于冲突搜索的两种多智能体路径规划算法。
分布式规划算法是人工智能领域兴起的基于强化学习的MAPF算法,其采用去中心化的思想,在智能体与环境交互过程中,每台智能体均可以与一定范围内的其他智能体通信,前提假设每台智能体只掌握了视野内智能体和障碍物的位置等信息,智能体根据当前策略不断和环境进行交互,获取环境下一个时刻的状态并更新其动作策略。分布式规划算法按照改进技术不同可以分为专家演示型、改进通信型和任务分解型三类,其适用于高密度和动态的部分可观察的环境,能高效解决实时再规划的问题。
参考文献
[1] R. Stern et al., “Multi-Agent Pathfinding: Definitions, Variants, and Benchmarks,” SOCS, vol. 10, no. 1, pp. 151–158, Sep. 2021, doi: 10.1609/socs.v10i1.18510.
2. CBS算法介绍(2024.10.20)
CBS(Conflict-Based Search,冲突基搜索)是一种用于多智能体路径规划问题的分支限界法,它的主要目标是让多个智能体在共享环境中找到最优的无碰撞路径。CBS的特点是采用分层结构,分为高层冲突解决和低层路径规划,将路径冲突检测与冲突解决分开考虑,从而在搜索效率和解的质量之间取得平衡。
01 高层冲突解决
高层冲突解决主要负责检测多个智能体之间的冲突,并通过为冲突智能体生成不同的约束条件,将问题分解为更小的子问题。每当检测到冲突时,CBS会为冲突的智能体创建约束,避免它们在同一时刻出现在同一位置。通过递归地分解冲突并优先处理路径代价较低的解,直到找到所有智能体无冲突的路径为止。
步骤:
-
初始状态:假设每个智能体A(i)都有一个初始的最短路径P(i),这是在不考虑冲突情况下的最优路径。
-
冲突检测:算法会检查所有路径P(1),P(2),...P(n),找到冲突。例如,如果两个智能体A(i)和A(j)在同一时刻t出现在相同位置(x, y),这就是一个冲突,记为(A(i), A(j), (x, y), t)。
-
冲突分解:对于每个冲突(A(i), A(j), (x, y), t), CBS生成两个子节点,每个子节点对应一个智能体的约束:
(1)子节点1:为智能体A(i)添加约束,限制其在时间t不能进入位置(x, y),记为C(i)=(x, y, t)。
(2)子节点2:为智能体A(j)添加类似约束C(j)=(x, y, t)。
通过这种方式,CBS将冲突分解成两个可能的路径规划问题,其中至少有一个智能体必须改变其路径以避免冲突。
4. 优先队列:将这两个子节点存入优先队列,按总代价(如路径总长度)排序,每次选择总代价最小的解进行处理。代价可以表示为cost(P(1), P(2), ..., P(n)),即所有智能体路径的总长度。
5.** **迭代:从优先队列中取出当前总代价最小的节点,重复冲突检测和分解,直到找到一个无冲突的解。
通过这种方式,高层只负责约束生成和冲突管理,不断通过生成约束来缩小解的空间。
02 低层路径规划
低层路径规划则专注于为单个智能体计算在满足高层约束下的最优路径。每当高层生成新的约束时,低层会针对受约束的智能体重新规划路径,确保其避开冲突点。低层使用经典的路径搜索算法(如A*算法)计算智能体的最短路径,并在局部调整智能体路径的同时保持整体搜索效率。
步骤:
- 单智能体路径规划:当高层为某个智能体A(i)生成了约束C(i)(如在时间t避免位置(x, y)),低层会使用路径搜索算法(如A*算法)A(i)为计算新的路径Pi,满足以下条件:
-
路径P(i)避开所有高层约束C(i),即P(i)不包含任何被禁止的状态,如(x, y, t)。
-
路径P(i)在满足约束的前提下尽可能短。
- 路径搜索:假设智能体A(i)当前路径起点为s(i),目标为g(i),其路径规划的任务是找到一条从s(i)到g(i)的最短路径P(i),使得:
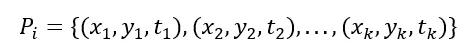
且在所有时间t满足约束条件C(i)(即A(i)不会在约束的时间和位置出现)。
-
局部更新:低层只会为受约束的智能体重新计算路径,其他未受约束的智能体保持其原始路径不变,这大大减少了计算开销。
-
反馈高层:当低层为智能体规划出新路径P(i)后,会将其反馈给高层。如果低层路径计算没有违反新的约束且无冲突,则算法终止;如果仍有冲突,则高层继续生成新的约束并递归分解。
总结
高层冲突解决:管理约束生成和冲突检测,每当发现冲突时生成约束并将问题分解为子问题,直到找到无冲突解。其核心在于分支限界法和冲突递归分解。
低层路径规划:基于高层的约束条件,为受影响的智能体重新规划最短路径,确保路径符合约束。它采用经典的路径搜索算法,独立计算单个智能体的路径。
CBS算法已有基于Python的库,通过运行“pip install cbs-mapf”安装这个库,即可在Python项目中使用它。
参考文献
[1] Sharon G, Stern R, Felner A, et al. Conflict-based search for optimal multi-agent pathfinding[J]. Artificial intelligence, 2015, 219: 40-66.
[2] Hönig W, Kiesel S, Tinka A, et al. Conflict-based search with optimal task assignment[C]//Proceedings of the International Joint Conference on Autonomous Agents and Multiagent Systems. 2018.
[3] Huang T, Koenig S, Dilkina B. Learning to resolve conflicts for multi-agent path finding with conflict-based search[C]//Proceedings of the AAAI conference on artificial intelligence. 2021, 35(13): 11246-11253.
[4] CBS算法Python库网站:https://pypi.org/project/cbs-mapf/
3. Space-time A*算法介绍(2024.10.20)
A*搜索用于查找每个智能体到达目的地的最短路径,但是这种搜索忽略了其他智能体的存在,或者可能将它们视为固定障碍物。在运动过程中,如果智能体检测到碰撞即将发生,相关智能体将重新搜索并选择新路径。合作寻路(Cooperative pathfinding)试图让智能体了解彼此的意图,在合作寻路中,A*搜索仍在使用,但增加了对其他智能体的移动的考量。
本文假设您熟悉A*搜索算法的基本思想和术语。
01 增加第三维度
为了解决协作寻路问题,搜索算法需要充分了解障碍物和智能体。当智能体四处移动时,无法在二维地图上表示智能体随时间变化的路线,为了克服这个问题,David Silver扩展了地图的第三个维度:时间,并将新的扩展地图称为时空图。时空图由三维单元网格组成:Cell(x, y, t)。在时空图中,假设执行单个动作的时间成本均为1,向上移动的动作相当于将一个智能体从 Cell(x, y, t) 移动到 Cell(x, y + 1, t + 1)。类似地,等待的动作将一个智能体从 Cell(x, y, t) 移动到 Cell(x, y, t + 1)。如果目标位置没有障碍物,并且没有其他智能体占用,则动作是可行的。现在在时空图上继续使用A*搜索,用到达目标位置所需的动作数量作为该条路径的成本,目标是找到智能体从当前点到其目标位置的最小成本路径。David Silver将这个搜索过程称为时空A*(space-time A*),以区别于一般的A*搜索。
02 构造预约表
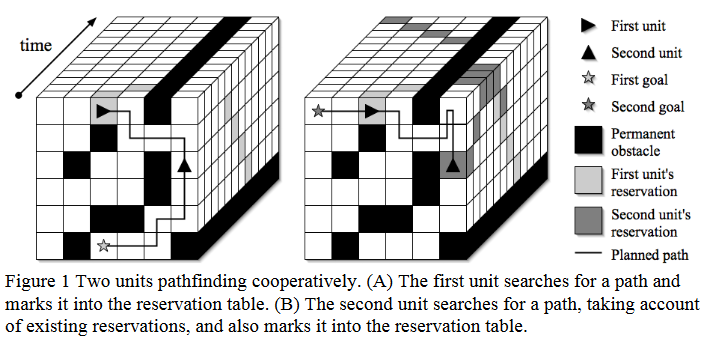
一个智能体选择了一条路径后,需要确保其他智能体寻路时能避开其路径上的单元格,可以通过构造一个揭示每个单元格是否可用的预约表来满足这一约束。预约表是一个简单的数据结构,包含时空图中每个单元格的一个条目,用来指定相应的单元格是可用的还是已经被预约了。时空图里的单元格数目通常很多,但在每个时间步上预约的条目数应该大致等于图中智能体的数量,很多单元格在大多数时间步上是未被占用的,如果直接存储每个单元格的状态(可用/已被占用)会造成大量的空间浪费。为了优化空间使用,可以通过哈希表来存储已占用的时空单元格:使用 (x, y, t) 作为哈希表的键,表示一个具体的单元格在某个时刻的状态。如果一个单元格在特定时间步没有被占用,那么它就不需要在哈希表中记录。一旦一个单元格被预约了,任何其他智能体都不能移入该单元格。智能体在时空图中使用A*搜索路径,寻路到目标位置后将该路径标记到预约表中,后续智能体寻路时将避开所有已经被预约的单元格,从而保证多智能体间不会发生同时占用同一个单元格的冲突(如图1所示)。
此外,还需要避免可能发生的边冲突,比如,如果一个智能体的路径预约了 Cell(x, y, t) 和 Cell(x + 1, y, t + 1),则需要阻止其他智能体在规划路径时预约 Cell(x + 1, y, t) 和 Cell(x, y, t + 1)。解决方案一是可以为动作中涉及的每个位置预约两个时间步,一个在时间 t,一个在时间 t+1;解决方案二是可以规划路径时明确地识别边冲突并将其标记为不可行的动作。
03 选择启发式函数
A*搜索的性能取决于启发式函数的选择,当启发式函数对距离的估算值小于等于从该点到目标位置的真实距离时,A*搜索保证一定能找到最短路径,且启发式函数的估计距离与真实距离越接近时,搜索速度越快。在时空A*中,随着搜索空间扩展一个额外的维度,启发式函数的选择变得更加重要。基于网格的地图通常使用曼哈顿距离作为启发式函数,它是到目标位置的 Δx 和 Δy 距离之和。如果到达目标位置的最短路径是迂回的,那么曼哈顿距离就是对真实距离糟糕的估计。当选择曼哈顿距离作为启发式函数时,时空图上许多位置的 f 值可能小于到目标位置的真实距离,启发式函数估计的值越小,算法就会遍历越多的单元格,导致搜索速度变慢。因此,需要选择一种更准确的启发式函数。
A*搜索过程中,一旦将某个节点放入了close list中,从起点到该节点的最短距离就已知,这个距离为g。为了更有效地估计时空A*中某个点到目标位置的真实距离,可以采用向后搜索的方法:以目标位置为起点,源头位置为终点,只考虑地图中的静态障碍物,使用A*在二维地图中从目标位置向源头位置搜寻最短路,搜索完一遍后,对于加入到close list中的那些点,就已知了从目标位置到该位置的避开静态障碍物的最短距离。换句话说,close list中每个节点的g值正好为二维地图上该点到目标位置的真实距离。在一次向后搜索完成后,可能无法获得地图上所有点到目标位置的真实距离,此时如果有需要,可以继续使用A*向后搜索,直至搜索完需要的点为止。使用向后搜索得到的距离更接近时空图上到目标位置的真实距离,我们使用这个距离作为A*搜索的h值,提高搜索效率。
基于以上,在时空A*中并列运行两个搜索,主搜索为时空A*寻找从智能体的当前位置到目标位置最短路径的搜索过程,辅助搜索为A*从智能体的目标位置向当前位置的向后搜索过程。主搜索在探索每个位置时都需要真实距离的启发式估计值,此时使用辅助搜索来得到这个估计值。如果主搜索探索的当前位置在辅助搜索的close list中,则立刻返回其g值;如果不在close list中,则继续向后搜索,直到将请求的位置放入到close list中,并返回其g值。
04 处理不同移动行为的智能体
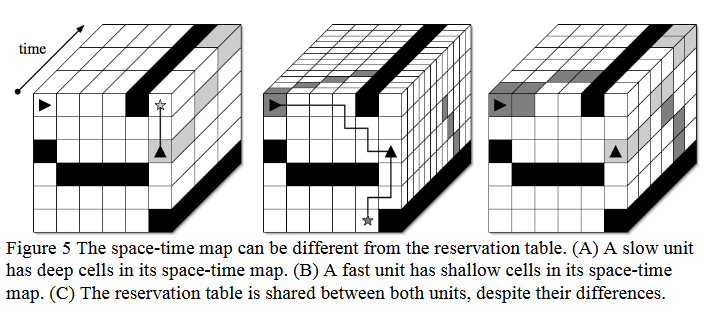
到目前为止,我们假设每个智能体的移动速度都是相同的:在一个时间步长内可以执行一个动作——向左、右、上、下移动一个单元格,或是在当前的单元格等待。时空A*搜索的路径包含的单元格和预约表的条目之间存在一一对应的关系。然而,每个智能体都可以以最适合自己的方式搜索时空,比如一个以缓慢速度移动的智能体需要两个时间步长才能向四周移动一个单元格,则这个智能体需要具有更长时间步长的时空网格(如图5A所示);同理,以更快速度移动的智能体的时间步长更短(如图5B所示)。我们可以给不同智能体构建不同大小的时空网格,但预约表有固定的结构,预约表每个条目所对应的每个单元格都具有固定大小并在所有智能体之间共享(如图5C所示)。
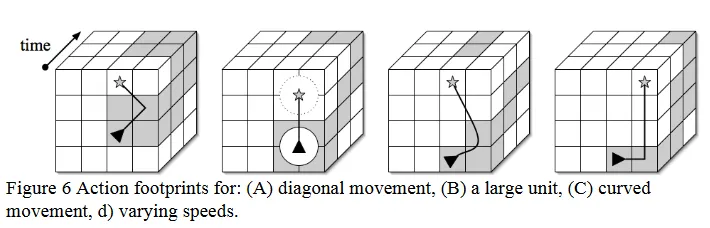
智能体动作的足迹决定了需要在预约表中预约的条目集合。例如,对角线移动的足迹可能包括一个由八个单元格组成的立方体(如图6A所示)。大型智能体在每个时间步都会有更广泛的足迹(如图6B所示)。缓慢的移动将产生持续更多时间步长的足迹(如图5A所示)。曲线移动将占用该动作穿过的所有时空单元格(如图6C所示)。预约表的粒度可以被初始化为任何值,这取决于寻路要求。
总结
在时空A*算法中,通过提前规划时间和空间,智能体可以避开彼此的路径,避免出现冲突的路线。许多对A*搜索算法的改进思路也可以应用于时空A*,增加的时间维度为寻路算法提供了更多的探索机会。值得一提的是,时空A*算法已有基于Python的库,通过运行“pip install space-time-astar”安装这个库,即可在Python项目中使用它。
参考文献
[1] Silver, “Cooperative Pathfinding,” AIIDE, vol. 1, no. 1, pp. 117–122, Sep. 2021, doi: 10.1609/aiide.v1i1.18726.
[2] Space-Time A*算法Python库网站:https://pypi.org/project/space-time-astar/
4. 无人机航线规划问题(2024.10.21)
01 UAV路径规划问题的独特性
随着无人机(UAV)技术的迅速发展,其应用范围不断扩大,从军事侦察、环境监测到商业配送,无人机正在各个领域发挥着越来越重要的作用。然而,随着应用场景的复杂化和任务要求的提高,无人自主导航能力成为制约无人机进一步发展的关键因素。路径规划作为自主导航的核心组成部分,其重要性日益凸显。相比于传统的地面机器人路径规划,无人机路径规划面临着独特的挑战。
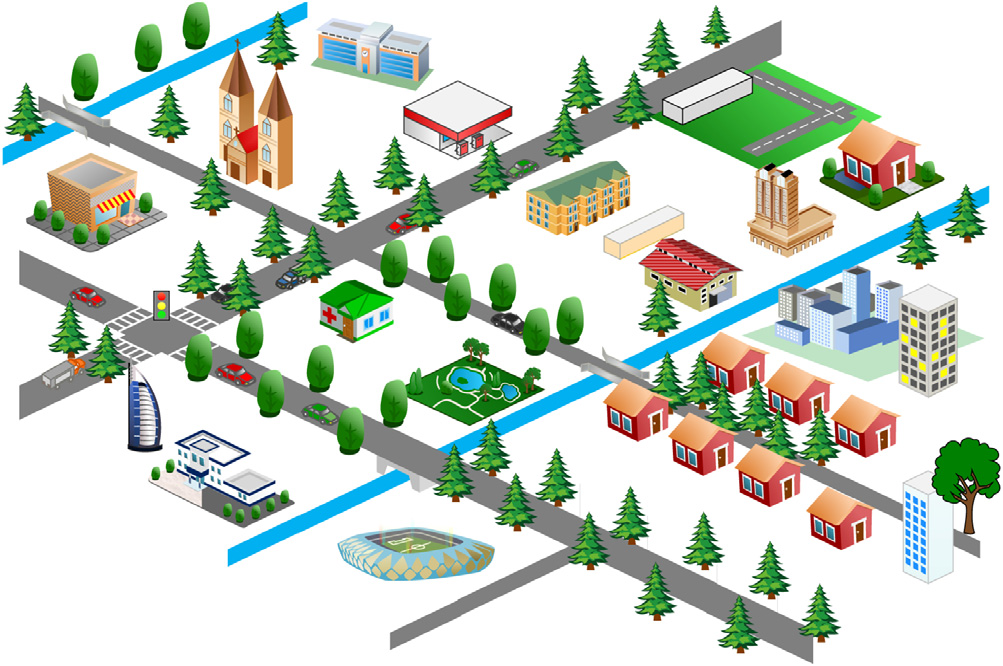
首先,UAV在三维空间中运动,如图所示,无人机可以改变高度,这增加了自由度,使得规划问题比传统的二维地面机器人更为复杂。这种额外的维度不仅扩展了可能的任务范围,还要求算法能够有效处理高度变化带来的能耗和气流影响。
其次,某些UAV(如固定翼)由于其空气动力学特性,无法像多旋翼飞行器那样悬停,需要保持恒定的巡航速度。这一速度约束给路径规划带来了额外的复杂性,因为算法需要考虑转弯半径、攀升率等因素,确保生成的路径符合飞行器的物理限制。
这些特点使得UAV路径规划在算法设计和实现上面临着独特的挑战。
02 问题定义
UAV路径规划本质上是一个复杂的优化问题,其目标是在特定约束条件下生成从初始位置到目的地的安全、高效路径。在数学上,这个问题可以形式化表述如下:对于在三维(D(3))环境中含静态障碍物的路径规划问题,设O={O1, O2, ..., On}⊂D(3)表示障碍物集合,路径需要从起点P(s)到终点P(t)。假设无障碍物的间隙空间表示为W(free,)那么对三维环境的路径规划问题(P(s), P(t), W(free))可以定义以下函数:δ(0)=P(s)表示初始时刻,δ(T)=P(t)表示目标时刻,对所有的β∈[0, T],存在φ=δ(β)∈W(free),这里φ被称为无人机(UAVs)的路径规划。这个数学模型不仅需要考虑空间约束,还要考虑UAV的动力学特性、能源限制、任务需求等多个因素。路径规划算法的目标是在这些复杂的约束条件下,找到一条最优或近似最优的路径,以满足特定的性能指标,如最短距离、最小能耗、最高安全性等。
03 路径规划类型
根据应用场景和任务需求,UAV路径规划可以分为几个主要类型,每种类型都有其特定的目标和挑战。
信息路径规划(IPP)旨在最大化数据收集的效用,这在环境监测、灾害评估等任务中尤为重要。IPP算法需要在有限的资源(如飞行时间、能源)约束下,优化UAV的路径以获取最有价值的信息。
覆盖路径规划(CPP)的目标是确定一条能够经过所有兴趣区域的路径,同时避开障碍物。这种规划在农业监测、搜索救援等场景中广泛应用,要求算法能够有效平衡覆盖完整性和路径效率。
协作路径规划涉及多架UAV的协同工作,需要为每架UAV生成互相协调的任务路径。这种规划不仅要考虑单个UAV的约束,还要处理UAV之间的通信、任务分配、冲突避免等复杂问题。
反应性路径规划则强调路径的实时调整能力,以应对动态变化的环境或突发情况。这种规划方法要求算法具有快速响应和决策能力,能够在保证安全的同时维持任务的连续性。
04 求解算法
无人机路径规划问题的求解方法大致可以分为三类:经典方法、软计算方法和混合方法。每种方法都有其特点和适用场景,下面我们将详细介绍这些方法。
(1) 经典方法
环境表示方法:主要包括路线图法和单元分解法。路线图法将自由空间缩减到一维线段网络,常见的有Voronoi图和可视性图。Voronoi图通过构建等距线将空间划分,适用于生成最大间隙路径;可视性图则连接所有可互见的顶点,适合寻找最短路径。单元分解法将无障碍空间分解为不重叠的凸多边形,然后构建连通性图。这种方法可以有效处理复杂环境,但可能会在高维空间中面临计算挑战。这些环境表示方法为后续的路径搜索奠定了基础,能够显著减少搜索空间,提高算法效率。
搜索算法:是经典方法中的核心组成部分,包括数学规划法、图搜索法、势场法和基于采样的方法。数学规划法使用数学模型和概率预测,如线性规划和动态规划,适用于有明确数学模型的问题。图搜索法中,Dijkstra算法基于动态规划,使用单一启发式方法,而A*算法是Dijkstra的改进版,结合了最佳优先搜索,在许多情况下能更快地找到最优路径。深度优先搜索(DFS)和广度优先搜索(BFS)也是常用的图搜索策略,分别适用于深度探索和广度探索。势场法通过为障碍物分配排斥力,为目标分配吸引力,构建一个虚拟力场来引导无人机运动,这种方法计算简单,适合实时应用,但可能陷入局部最小值。基于采样的方法如概率路线图(PRM)和快速探索随机树(RRT)在配置空间中随机取样或快速扩展适用于高维空间的路径规划,但可能难以保证最优性。这些搜索算法各有特点,需要根据具体问题选择合适的算法。
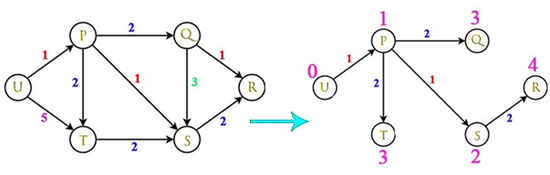
Dijkstra 算法示意图
(2) 软计算方法
软计算方法模拟人脑的推理和适应能力,适用于处理复杂、不确定的问题。这类方法通常具有较强的自适应性和鲁棒性,能够在不完全信息或动态环境中表现良好。
机器学习方法:包括监督学习、无监督学习、强化学习和深度学习,广泛应用于路径规划、碰撞避免等任务。监督学习可用于预测最优路径,无监督学习可帮助识别环境特征,强化学习能够通过与环境交互来学习最优策略,而深度学习则可以处理高维输入数据,如图像或点云数据。这些方法的优势在于能够从大量数据中学习,随着经验的积累不断改善性能。例如,深度强化学习算法如Deep Q-Network (DQN)已被成功应用于复杂环境中的无人机导航任务。机器学习方法的一个重要优势是其泛化能力,能够适应新的、未见过的情况。
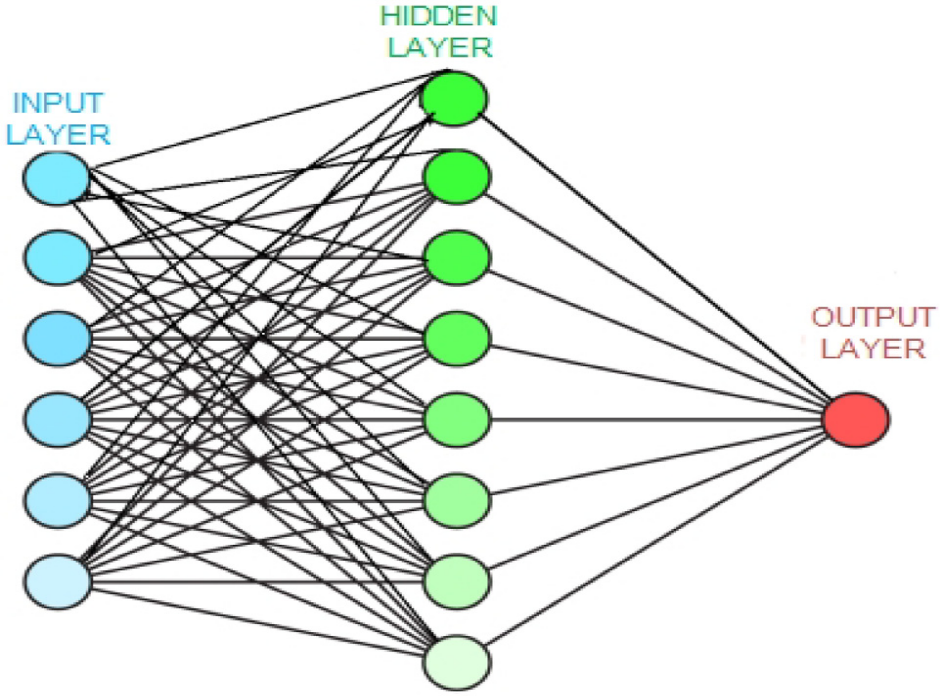
人工神经网络示意图
模糊推理系统:使用“如果-那么”规则处理不确定性,特别适用于障碍规避问题。这种方法能够处理模糊、不精确的信息,模拟人类专家的决策过程。在无人机路径规划中,模糊逻辑可以用于处理传感器数据的不确定性,评估路径的安全性和效率,以及在复杂环境中做出实时决策。模糊系统的一个主要优势是其可解释性,决策过程可以用人类可理解的语言规则表示。然而,设计有效的模糊规则和成员函数可能需要大量的专业知识和调试工作。
元启发式方法:是一类受自然现象启发的优化算法,包括模拟退火(SA)、遗传算法(GA)、蚁群优化(ACO)、粒子群优化(PSO)和差分进化(DE)等。模拟退火算法模拟金属冷却过程,通过在搜索过程中允许一定概率的“上山”移动来避免陷入局部最优。遗传算法基于自然选择机制,通过模拟进化过程优化解的种群,适用于复杂的多目标优化问题。蚁群优化算法模拟蚂蚁群体行为,通过信息素机制搜索最短路径,特别适合解决离散优化问题。粒子群优化算法模拟鸟群或鱼群行为,通过个体间的信息共享来优化全局和局部解,计算效率高且易于实现。差分进化算法类似遗传算法,但具有更好的收敛性和实现简便性,适用于连续空间的优化问题。这些元启发式方法在无人机路径规划中表现出色,能够有效处理多目标、高维度的复杂优化问题,但可能需要针对具体问题进行参数调整以获得最佳性能。
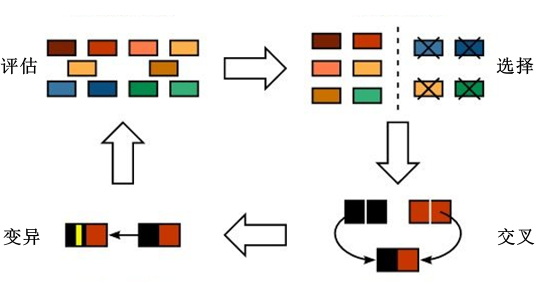
遗传算法示意图
(3) 混合方法
混合方法结合不同技术的优点,以克服单一方法的局限性,在复杂的无人机路径规划问题中显示出强大的性能。
常见的组合包括不同软计算方法的组合,如灰狼优化算法与强化学习的结合,可以在保持全局搜索能力的同时提高局部优化效率;经典方法与软计算技术的结合,如人工势场法与RRT-Connect算法的混合,能够在保证快速响应的同时提高路径的全局最优性;经典方法与软计算方法的结合,如RRT与灰狼优化算法的组合,可以在快速生成可行路径的基础上进行进一步的优化。
尽管混合方法可能增加算法的复杂性,但它们通常能够在各种挑战性的无人机路径规划场景中提供更好的性能和更高的鲁棒性。
结语
本文综述了无人机路径规划领域的经典方法、软计算方法和混合方法,这些方法在推动无人机自主导航技术发展方面发挥了重要作用。然而,应用场景的日益复杂化带来了诸如动态环境适应、多无人机协同和高难度任务等挑战,这些挑战正驱动着算法优化和技术创新。展望未来,深度学习等先进技术与传统方法的融合有望为无人机应用开辟新的研究途径。无人机路径规划已超越单一技术领域,发展为一个跨学科研究热点。该领域的进步正为环境监测、灾害救援等应用带来技术革新,为应对复杂社会问题提供了创新解决方案。
参考文献
[1] Quan L, Han L, Zhou B, et al. Survey of UAV motion planning[J]. IET Cyber‐systems and Robotics, 2020, 2(1): 14-21.
[2] Aggarwal S, Kumar N. Path planning techniques for unmanned aerial vehicles: A review, solutions, and challenges[J]. Computer communications, 2020, 149: 270-299.
[3] Ghambari S, Golabi M, Jourdan L, et al. UAV path planning techniques: a survey[J]. RAIRO-Operations Research, 2024, 58(4): 2951-2989.
5. 无人机编队系统的路径规划(2024.10.21)
一、无人机在互联网中的应用
无人机(UAV)凭借其灵活性和机动性,逐渐成为物联网(IoT)中重要的组成部分,尤其是在应对通信拥堵和网络覆盖不足的场景中。随着设备数量的爆炸式增长,物联网中产生的数据量越来越大,传统的地面基础设施难以处理如此巨大的数据负荷。无人机(UAV)因其灵活性、机动性和低成本,被广泛应用于提升物联网网络的性能。UAV不仅能够在缺乏地面网络的情况下提供无线接入,还能够执行如视频监控、货物运输、数据收集等多种任务,极大地增强了物联网网络的灵活性和适应性。然而,UAV辅助的IoT网络由于其高动态性、异构性和复杂性,存在诸多挑战,例如通信资源管理、能量管理和飞行控制问题([1])。下面我们就飞行控制问题进行详细阐述。
二、四旋翼飞行器的自主导航与运动规划
四旋翼飞行器凭借其高机动性和灵活性,已经广泛应用于空中机器人领域,尤其是在诸如空中摄影、搜索与救援、环境监测和货物运输等任务中。然而,为了在复杂环境中高效执行这些任务,四旋翼飞行器必须具备完全的自主导航能力。这意味着它们不仅要能够感知周围的环境,还需要自主规划飞行路径并实时调整以避开障碍物,确保任务的顺利完成。自主导航的关键在于运动规划模块,该模块负责整体系统的协调,并根据环境和任务需求进行决策([2])。四旋翼飞行器的运动规划系统通常可以分为两个主要阶段:
- 前端路径规划(Path Planning)
路径规划是自主导航中的首要任务,旨在找到一条从起始点到目标点的安全路径,避免与障碍物发生碰撞。路径规划方法主要分为两大类:采样基方法和搜索基方法。
(1)采样基方法
采样基路径规划方法如概率路标法(PRM)和快速扩展随机树(RRT)通过从自由配置空间中随机采样点生成路径([3])。PRM通过连接随机采样点生成图模型,并通过图搜索算法寻找路径。而RRT则从起始位置开始生长一棵树,每个节点代表一个可行的自由空间配置,树的生长通过随机配置和其最近邻节点的连接,直到找到目标配置。
这些方法的优势在于可以快速生成可行路径,适用于动态环境。然而,RRT方法的渐进最优性不足,改进版本如 RRT* 通过局部重新连接树节点,提高了路径的最优性。采样基方法在处理复杂、非线性环境时表现出色,但对于路径优化则相对较弱。
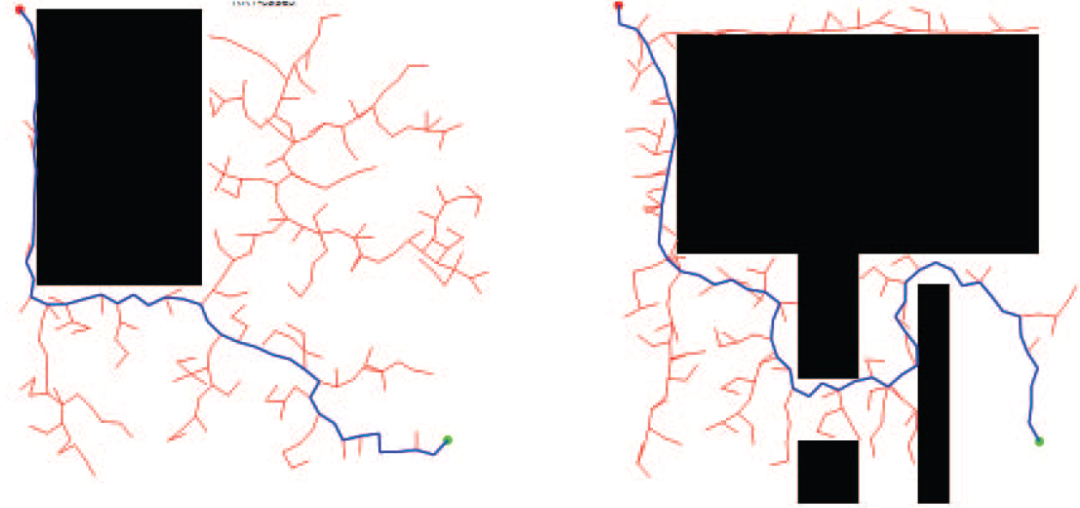
基于RRT算法的路径规划
(2)搜索基方法
搜索基路径规划方法如A*和Dijkstra算法则通过对配置空间进行离散化,使用图搜索算法寻找最优路径([4]。)A*算法引入了启发式函数,通过在搜索过程中评估当前路径代价和到目标点的估计代价,确保找到一条最优路径。Dijkstra算法则通过逐步选择当前未访问节点中距离最短的节点,更新邻居节点的距离,最终找到最短路径。
搜索基方法在路径最优性方面表现优异,尤其是在静态或已知环境中。然而,在动态或复杂环境中,其搜索效率可能受到启发式函数设计的影响,导致较大的计算开销。
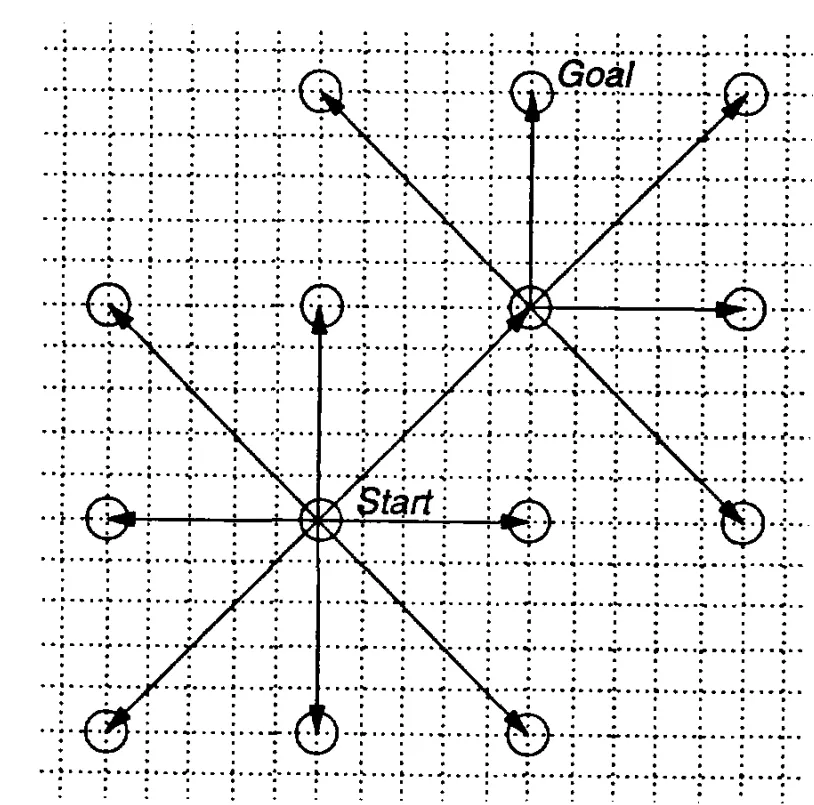
A*路径规划算法([10])
- 后端轨迹优化(Trajectory Optimization)
轨迹优化是确保路径不仅在几何上可行,还在动态上可执行的关键步骤。路径规划通常只生成几何路径,而为了确保四旋翼飞行器的动态可行性,需要将几何路径参数化为时间,并生成动态可行的轨迹。这一过程通常通过最小化控制代价或其他优化目标函数,并在满足安全性和动态约束的条件下进行优化。轨迹优化方法可以分为两类:硬约束方法和软约束方法。
(1)硬约束方法
硬约束方法严格要求轨迹在整个优化过程中满足特定约束。典型的硬约束方法是最小弹性轨迹生成算法(Minimum-Snap Trajectory Generation),该算法利用四旋翼飞行器的 差分平坦性 特性,将飞行器的状态空间简化为3D位置和偏航角,并通过分段多项式表示轨迹([5])。通过求解二次规划问题,该算法能够生成平滑、连续的轨迹,确保轨迹的加速度、速度和位置衍生约束得到满足。
这种方法特别适合需要精确控制的任务,如高精度飞行或复杂的避障环境。然而,在处理动态和不可预知的环境时,硬约束方法可能需要多次迭代以确保轨迹的可行性。
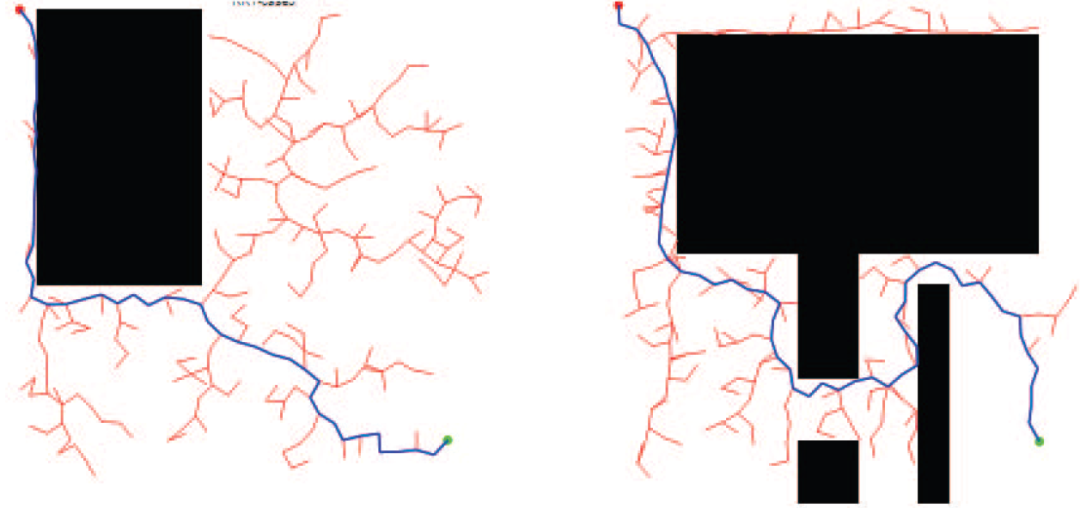
飞行走廊约束下Minimum-Snap的算法结果([5])
(2)软约束方法
软约束方法通过在目标函数中引入惩罚项来处理违反约束的部分。典型的软约束方法包括 CHOMP(Covariant Hamiltonian Optimization for Motion Planning)和STOMP(Stochastic Trajectory Optimization for Motion Planning)([6])。CHOMP通过最小化平滑性和碰撞代价的局部目标函数,生成轨迹,而STOMP则基于无梯度优化方法,通过候选轨迹的组合生成最优路径。软约束方法在处理复杂环境时具备一定的灵活性,能够更好地应对动态场景。然而,软约束方法容易陷入局部最优解,且在碰撞密集的环境中成功率较低。
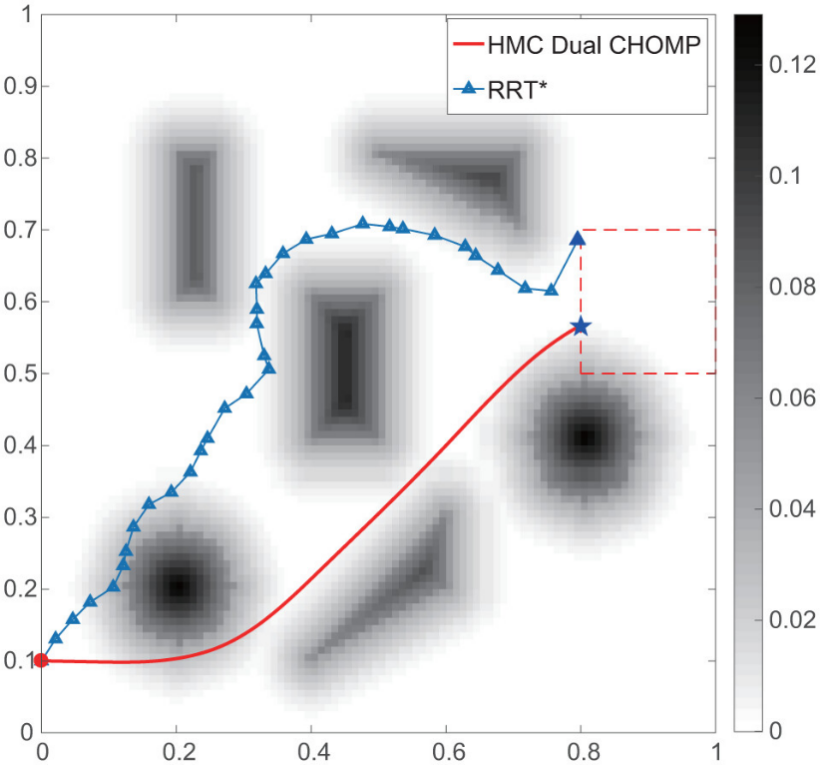
HMC dual CHOMP 和 RRT* 在相同路径规划问题中的结果([6])
为了进一步提高轨迹优化的效率和精度,许多新技术已经被提出。例如,基于B样条的轨迹表示方法能够生成平滑且局部约束更少的轨迹,使其在局部重规划时效率更高。同时,通过结合基于多面体安全飞行走廊或基于点云地图的采样方法,可以显著提高轨迹优化的计算效率,特别是在复杂环境中。
三、编队飞行系统中的轨迹优化与挑战
编队飞行系统中的轨迹优化与挑战是无人机群体飞行研究的重要组成部分。随着无人机群体在搜索救援、农业监测、城市管理等领域的应用不断增加,如何有效地进行轨迹优化,确保无人机群体在复杂环境中保持队形、避开障碍物并执行任务,是一个极具挑战性的问题。以下是详细阐述这一领域中的核心问题、优化方法以及当前面临的挑战。
- 编队飞行系统中的核心挑战
编队飞行的目标是让多架无人机在协调一致的情况下进行任务,保持预定的队形,并应对外界的动态变化([7])。以下是编队飞行中最具挑战的几个方面:
(1)编队维护与避障的冲突
在编队飞行中,无人机需要彼此保持一定的队形(如线形、矩形、环形等),以完成特定的任务。然而,保持编队形态与避免障碍物之间的冲突往往难以调和。当环境中出现障碍物时,无人机既需要调整飞行路径以避开障碍物,又要尽量保持原有的编队结构不被破坏。
(2)动态环境中的应对
编队飞行系统必须能够实时应对动态环境,如移动的障碍物、突发的环境变化或任务要求的调整。传统的静态路径规划方法无法应对这些快速变化的情况,要求编队飞行系统具备高度的灵活性和自适应能力,以便在飞行过程中根据环境变化实时调整轨迹。
(3)规模编队的可扩展性
当编队规模较小时(例如几架无人机),轨迹优化的计算量较小且较易管理。然而,随着编队规模的增加,轨迹优化的计算复杂性和通信开销急剧增加。特别是,当编队中的无人机数量达到数十甚至数百时,如何在保证每架无人机安全飞行的前提下维持全局编队的协调,是一个极大的挑战。
(4)编队恢复与重组能力
在编队飞行中,外界条件(如强风、障碍物)或系统内部故障可能导致编队结构被破坏。在这种情况下,系统需要具备快速重组编队的能力,使其尽快恢复到原有队形或重新规划新的队形,继续执行任务。这需要编队系统具备高度的弹性和恢复能力。
- 编队飞行中的轨迹优化方法
轨迹优化是确保编队飞行系统在复杂环境中高效运行的核心。轨迹优化不仅需要保证路径的可行性,还要最大程度地降低能耗,并保持无人机之间的协调。以下是几种常见的轨迹优化方法。
(1)分布式轨迹优化
分布式轨迹优化通过将轨迹规划任务分配给各个无人机,使每架无人机能够独立进行路径优化,同时确保编队整体的协调一致性。分布式优化的优势在于可以降低全局优化的计算复杂度,使其更适用于大规模无人机编队。
· 分布式模型预测控制(Distributed Model Predictive Control, DMPC)
DMPC通过在预测时间段内对每架无人机的轨迹进行优化,确保其轨迹在未来一段时间内是可行的,并与其他无人机的轨迹保持一致。这种方法使每架无人机能够根据局部信息做出决策,同时考虑整体编队的目标([8])。
· 基于博弈理论的分布式优化
在这种方法中,每架无人机被视为一个博弈玩家,通过与周围无人机的交互不断调整自身轨迹。博弈论方法的优点是,它能够在无人机之间建立自适应的协作机制,实现分布式的轨迹优化([9])。
(2)动态避障与实时重规划
在编队飞行中,动态避障是一个关键问题,特别是在环境中存在移动障碍物或其他飞行器时。为了解决这一问题,实时重规划方法应运而生:
· 动态窗口法(Dynamic Window Approach, DWA)
DWA是一种基于局部感知的避障方法。每架无人机根据其传感器获取的环境信息,动态调整飞行速度和方向,以避免与障碍物碰撞。该方法适用于处理实时变化的环境。
· 局部规划与全局路径结合
局部路径规划用于在短期内进行避障调整,而全局路径规划负责维持整个编队的长期任务目标。通过将局部和全局规划相结合,编队可以在复杂环境中保持高效运行。
(3)编队形态调整与弹性规划
在狭窄走廊或受限空间中,固定编队形态可能导致无人机无法通过或效率低下。为此,编队系统需要具备弹性调整能力,使无人机能够根据环境动态调整队形。
· 变形编队(Deformable Formation)
变形编队方法允许无人机根据环境的限制(如障碍物或任务需求)调整编队的形态、规模或间距。例如,在通过狭窄通道时,编队可以从矩形变为线形,以确保每架无人机能够顺利通过。
· 任务重组与任务分配优化
在复杂任务中,某些无人机可能会承担更重要的角色,如担任编队领导者或执行特定任务。在这种情况下,通过对任务进行重组和优化分配,可以进一步提升编队的整体效率和灵活性。
参考文献
[1] N. Cheng等, 《AI for UAV-Assisted IoT Applications: A Comprehensive Review》, IEEE Internet Things J., 卷 10, 期 16, 页 14438–14461, 8月 2023, doi: 10.1109/JIOT.2023.3268316.
[2] L. Quan, L. Han, B. Zhou, S. Shen和F. Gao, 《Survey of UAV motion planning》, IET Cyber-Syst. Robot., 卷 2, 期 1, 页 14–21, 3月 2020, doi: 10.1049/iet-csr.2020.0004.
[3] Y. Guo, X. Liu, Q. Jia, X. Liu和W. Zhang, 《HPO-RRT*: a sampling-based algorithm for UAV real-time path planning in a dynamic environment》, Complex Intell. Syst., 卷 9, 期 6, 页 7133–7153, 12月 2023, doi: 10.1007/s40747-023-01115-2.
[4] Y. Du, 《Multi-UAV Search and Rescue with Enhanced A ∗ Algorithm Path Planning in 3D Environment》, Int. J. Aerosp. Eng., 卷 2023, 页 1–18, 2月 2023, doi: 10.1155/2023/8614117.
[5] B. Shi等, 《UAV Trajectory Generation Based on Integration of RRT and Minimum Snap Algorithms》, 收入 2020 Chinese Automation Congress (CAC), Shanghai, China: IEEE, 11月 2020, 页 4227–4232. doi: 10.1109/CAC51589.2020.9326562.
[6] 《A new local path planning approach based on improved dual covariant Hamiltonian optimization for motion planning method - Bo You, Zhi Li, Liang Ding, Haibo Gao, Jiazhong Xu, 2019》. 见于: 2024年10月12日. [在线]. 载于: https://journals.sagepub.com/doi/full/10.1177/1687814019851007
[7] H. Do等, 《Formation Control Algorithms for Multiple-UAVs: A Comprehensive Survey》, EAI Endorsed Trans. Ind. Netw. Intell. Syst., 卷 8, 期 27, 页 170230, 6月 2021, doi: 10.4108/eai.10-6-2021.170230.
[8] Z. Cai, L. Wang, J. Zhao, K. Wu和Y. Wang, 《Virtual target guidance-based distributed model predictive control for formation control of multiple UAVs》, Chin. J. Aeronaut., 卷 33, 期 3, 页 1037–1056, 3月 2020, doi: 10.1016/j.cja.2019.07.016.
[9] C. Han, A. Liu, K. An, G. Zheng和X. Tong, 《Distributed UAV Deployment in Hostile Environment: A Game-Theoretic Approach》, IEEE Wirel. Commun. Lett., 卷 11, 期 1, 页 126–130, 1月 2022, doi: 10.1109/LWC.2021.3122127.
[10] C. W. Warren, 《Fast path planning using modified A* method》, 收入 [1993] Proceedings IEEE International Conference on Robotics and Automation, Atlanta, GA, USA: IEEE Comput. Soc. Press, 1993, 页 662–667. doi: 10.1109/ROBOT.1993.291883.
6. IBM Granite3.0 调研报告(2024.11.28)
IBM Granite 3.0文档内容说明
1.1 文档内容描述
本文档主要对IBM最新推出的Granite 3.0进行调研与试用,形成了调研报告和使用过程的指导,方便读者了解和试用最新推出的Granite 3.0模型和学习寻找Granite 3.0相关的资源。
1.2 撰写文档的目的
撰写本文档的目的在于记录当调研Granite 3.0的工作内容和使用方法,以及过程中涉及到的相关开源资源与文档的整理。
遵循本文档的指导,可以快速有效地了解Granite 3.0模型,通过文档指导可以将Granite 3.0模型快速在本地部署使用。将其作为Granite 3.0相关工作的参考资料。
Granite 3.0模型简介
2.1 Granite 3.0模型的内容
IBM的Granite 3.0家族系列包括:
- 通用/语言模型:Granite 3.0 8B Instruct,
Granite 3.0 2B Instruct,
Granite 3.0 8B Base,
Granite 3.0 2B Base
- 护栏与安全模型:Granite Guardian 3.0 8B,
Granite Guardian 3.0 2B
- 专家混合模型:Granite 3.0 3B-A800M Instruct,
Granite 3.0 1B-A400M Instruct,
Granite 3.0 3B-A800M Base,
Granite 3.0 1B-A400M Base
通用/语言模型主要用于自然语言理解和生成任务,适用于广泛的场景,如文本生成、问答系统、对话系统等。
-
Granite 3.0 8B Instruct是一个大型的语言模型,参数量为80亿。它经过指令调优,适合处理复杂的任务,如生成详细的回答、编写文章、翻译等。
-
Granite 3.0 2B Instruct是一个中等规模的语言模型,参数量为20亿。同样经过指令调优,适用于中等复杂度的任务,如简单的文本生成、问答等。
-
Granite 3.0 8B Base是一个大型的基础语言模型,参数量为80亿。它没有经过特定任务的调优,适用于需要大量参数的通用任务。
-
Granite 3.0 2B Base是一个中等规模的基础语言模型,参数量为20亿。同样没有经过特定任务的调优,适用于中等规模的通用任务。
护栏与安全模型是专门设计用于提高模型的安全性和可靠性,防止生成有害或不当的内容。
-
Granite Guardian 3.0 8B是一个大型的安全模型,参数量为80亿。它经过专门的训练,以识别和过滤有害内容,确保生成的内容是安全和合适的。
-
Granite Guardian 3.0 2B是一个中等规模的安全模型,参数量为20亿。同样经过专门的训练,适用于需要中等规模安全保护的场景。
专家混合模型结合了不同领域的专业知识,适用于特定领域的任务,如金融、医疗、法律等。
-
Granite 3.0 3B-A800M Instruct是一个中等规模的混合模型,参数量为30亿,附加了8亿参数的专业知识模块。经过指令调优,适用于需要专业知识的任务,如金融分析、法律咨询等。
-
Granite 3.0 1B-A400M Instruct是一个较小规模的混合模型,参数量为10亿,附加了4亿参数的专业知识模块。同样经过指令调优,适用于需要中等专业知识的任务。
-
Granite 3.0 3B-A800M Base是一个中等规模的基础混合模型,参数量为30亿,附加了8亿参数的专业知识模块。没有经过特定任务的调优,适用于需要大量参数和专业知识的通用任务。
-
Granite 3.0 1B-A400M Base是一个较小规模的基础混合模型,参数量为10亿,附加了4亿参数的专业知识模块。同样没有经过特定任务的调优,适用于需要中等参数和专业知识的通用任务。
2.2 Granite 3.0模型的优势
·原始性能方面
Granite 3.0 语言模型在原始性能上展示出良好的结果。
在 Hugging Face 的 OpenLLM 排行榜定义的标准学术基准测试中,Granite 3.0 8B Instruct 模型的整体性能平均领先于 Meta 和 Mistral 中类似大小的开源模型的最先进性能。在 IBM 的先进 AttaQ 安全基准测试中,Granite 3.0 8B Instruct 模型在所有测量的安全维度上均领先于 Meta 和 Mistral 的模型。
在检索增强生成(RAG)、工具使用和网络安全领域的核心企业任务中,Granite 3.0 8B Instruct 模型的平均表现优于Mistral 和 Meta 中类似规模的开源模型。
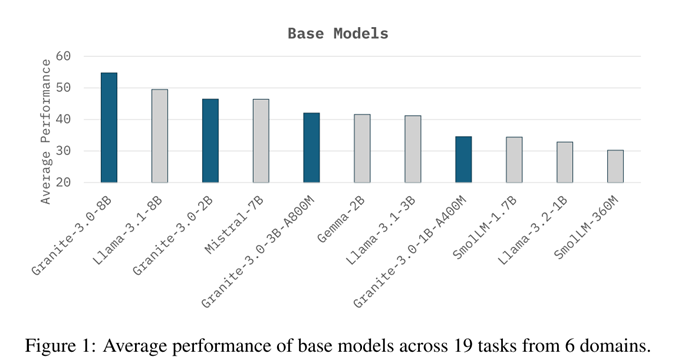
图:基础模型在6个域的19个任务中的平均性能
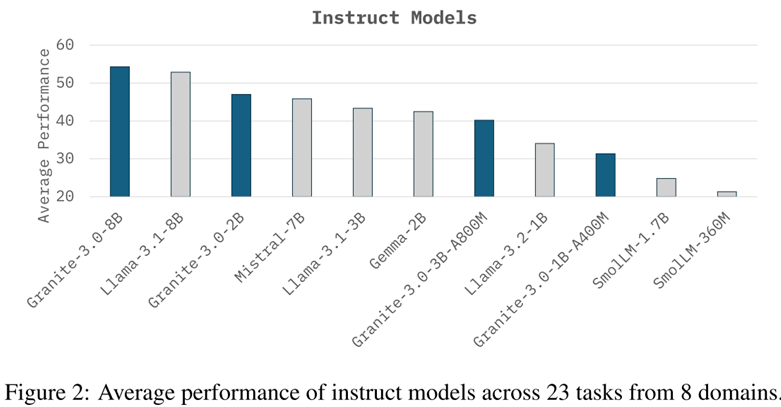
图:指令模型在8个域的23个任务中的平均性能
·训练数据集方面
Granite 3.0 模型是在超过 12 万亿个标记上进行训练的,这些数据来自 12 种不同的自然语言和 116 种不同的编程语言,采用了一种新颖的两阶段训练方法,利用了数千个旨在优化数据质量、数据选择和训练参数的实验结果。到今年年底,预计 3.0 8B 和 2B 语言模型将支持扩展的 128K 上下文窗口和多模态文档理解能力。
·推理成本方面
IBM 展示了性能和推理成本的完美平衡,提供了其 Granite 专家混合(MoE)机构模型,Granite 3.0 1B-A400M 和 Granite 3.0 3B-A800M,这些较小且轻量级的模型可用于低延迟应用程序以及基于 CPU 的部署。
IBM 还宣布了其预训练 Granite 时间序列模型的更新版本,早期版本于今年早些时候发布。这些新模型在 3 倍的数据上进行训练,在所有三个主要时间序列基准测试中表现出色,超越了来自 Google、Alibaba 等公司 10 倍更大模型的性能。更新后的模型还提供了更大的建模灵活性,支持外部变量和滚动预测。
Granite 3.0模型试用
3.1 如何使用Granite 3.0模型
-
打开您的网络浏览器并导航到 Hugging Face 网站(国内中文镜像网站链接:https://hf-mirror.com/ )。
-
安装 Hugging Face Transformers Library,该库提供了使用 LLMs。
-
在页面顶部的搜索栏中,键入“Granite 3.0”,然后按 Enter。这将显示可用 Granite 3.0 型号的列表。
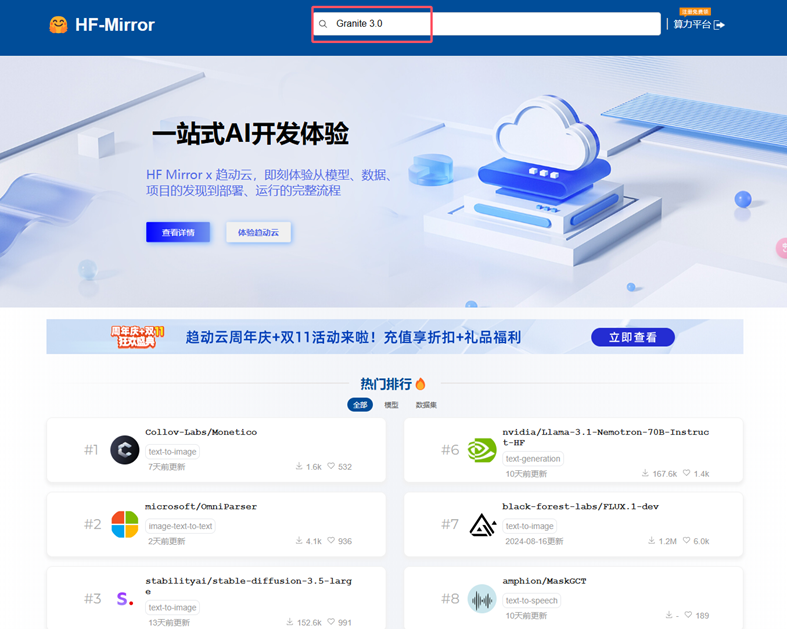
-
选择要下载的 Granite 3.0 模型。
-
单击模型的名称以转到其页面。
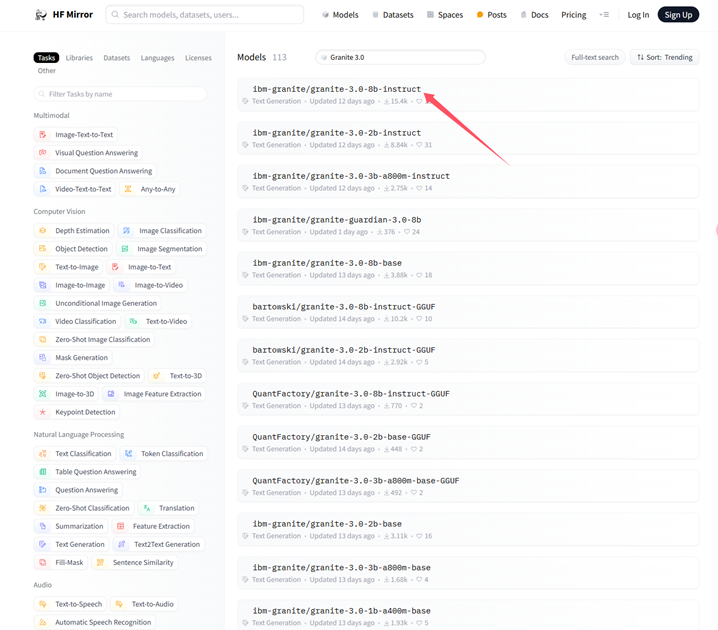
这里选择Granite 3.0 8B Instruct进行试用。
- 单击“使用此模型”并下载到相应的库。
下载官方已经训练好模型的参数。(模型参数地址:
https://hf-mirror.com/ibm-granite/granite-3.0-8b-instruct/tree/main)
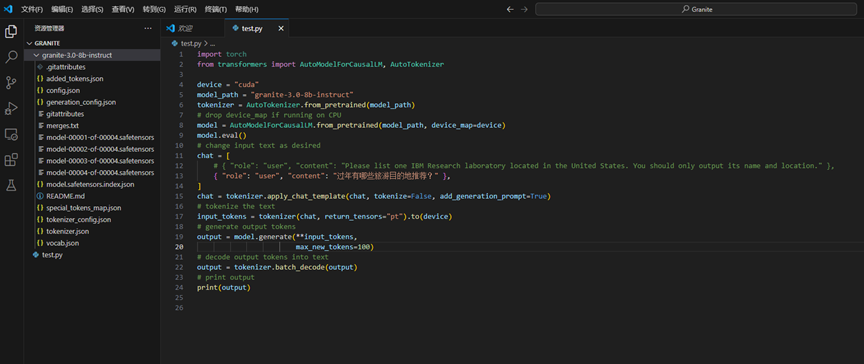
将模型在本地运行。(模型使用教程链接:
https://hf-mirror.com/ibm-granite/granite-3.0-8b-instruct)
另外Granite 3.0支持的语言有:英语、德语、西班牙语、法语、日语、葡萄牙语、阿拉伯语、捷克语、意大利语、韩语、荷兰语和中文。用户可以针对这 12 种语言以外的语言微调 Granite 3.0 模型。
- 运行示例1:Please list one IBM Research laboratory located in the United States. You should only output its name and location.
答: IBM Almaden Research Center - San Jose, California

- 运行示例2:过年有哪些旅游目的地推荐?
答:过年是中国最重要的传统节日,各地都有独特的旅游目的地推荐。例如,北京的天坛、上海的长城、广州的清真寺等都是很受欢迎的旅游景点。

7. 选择与您的开发环境兼容的格式。
8. 将文件保存到您的计算机。
Granite 3.0模型的潜在助力
4.1 Granite 3.0模型对企业的帮助
通用语言模型:
Granite 3.0语言模型提供了不同规模的语言模型,有参数量为80亿的大型语言模型和参数量为20亿的中等规模的语言模型,企业可以针对实际业务需求选择大型或者中等规模的模型投入实际运用。
另外,Granite 3.0 8B Base参数量为80亿,没有经过特定任务的调优,适合大型企业或有特殊需求的企业进行深度定制,开发出符合自己业务特点的应用程序。Granite 3.0 2B Base相较于8B Base,2B Base的成本更低,更适合预算有限的企业,虽然参数量较少,但在常见的文本处理任务上表现依然优秀,能够满足大多数企业的基本需求。
护栏与安全模型:
护栏与安全模型不仅保护企业免受潜在的安全威胁,还确保企业在使用先进技术和数据处理过程中遵守相关法律法规。利用护栏与安全模型可以提供核心的加密、访问控制和审计的功能,提供全面的安全防护和合规支持。综上,Granite 3.0的安全模型可以为企业的数据安全提供强有力的保障,可以以Granite 3.0的安全模型为基础进一步开发高价值的收费产品。
专家混合模型:
专家混合模型(Mixture of Experts, MoE)是一种通过组合多个专家模型来提高整体模型性能的技术。这种模型在处理大规模数据和复杂任务时表现出色,能够显著提升预测准确性和计算效率。
专家混合模型适用于需要专业知识的任务,如金融分析、法律咨询等,用可以针对特定企业用户的业务需求投入专业数据进行训练。
4.2 Granite 3.0模型落地企业的部署步骤
(1)明确需求:
确定企业希望通过部署Granite 3.0解决的具体问题或达成的目标,如提高数据处理效率、增强安全性、优化客户体验等。评估现有的硬件和软件资源,确定是否需要额外的投资或升级。
(2)选择合适的版本
通过上述需求从通用语言模型、护栏与安全模型、专家混合模型中选取适合的模型,并且需要根据实际的数据规模选择合适的模型参数量。
(3)硬件资源与环境准备
企业需要确保有足够的计算资源(如CPU、GPU、内存)来运行Granite 3.0模型。确保网络带宽和稳定性,特别是对于分布式部署和远程访问的情况。
确保服务器运行的操作系统兼容Granite 3.0的要求。安装必要的依赖库和工具,如Python、TensorFlow等。
(4)模型部署与集成
从Hugging Face官方渠道下载选定的Granite 3.0模型。按照官方文档进行模型的安装和配置,用业务对应的数据完成对模型的训练或者微调。将Granite 3.0的API与现有的业务系统进行对接,确保数据流畅传输。
(5)测试与验证
结束集成后,需要对对每个功能模块进行单元测试,确保其按预期工作。测试模型的性能指标,如响应时间、吞吐量等。进行端到端的集成测试,确保各个模块协同工作,没有兼容性问题。
Granite 3.0模型与其他模型对比
5.1 模型架构方面
·Granite 3.0
架构类型:Granite 3.0 是一个基于 Transformer 的大规模语言模型。Transformer 架构通过自注意力机制(self-attention)有效地处理长依赖关系,使得模型在处理长文本时表现优异。
参数量:Granite 3.0 有多个版本,其中 Granite-3.0-8B 拥有80亿参数,是一个非常大的模型。此外,还有 Granite-3.0密集 版本,通过优化模型结构和训练方法,提高了性能。
优化技术:Granite 3.0 引入了多种优化技术,如稀疏注意力机制、混合精度训练等,以提高训练效率和模型性能。
其他模型:
·BERT:基于 Transformer 的双向编码器表示,主要用于自然语言理解任务。参数量通常较小,如 BERT-base 有1.1亿参数,BERT-large 有3.4亿参数。
·GPT:基于 Transformer 的自回归语言模型,主要用于文本生成任务。GPT-3 拥有1750亿参数,是目前最大的公开语言模型之一。
·RoBERTa:改进版的 BERT,通过更多的训练数据和更长的训练时间提高了性能。
·T5:基于 Transformer 的预训练模型,使用前缀条件化(prefix conditioning)技术,支持多种自然语言处理任务。
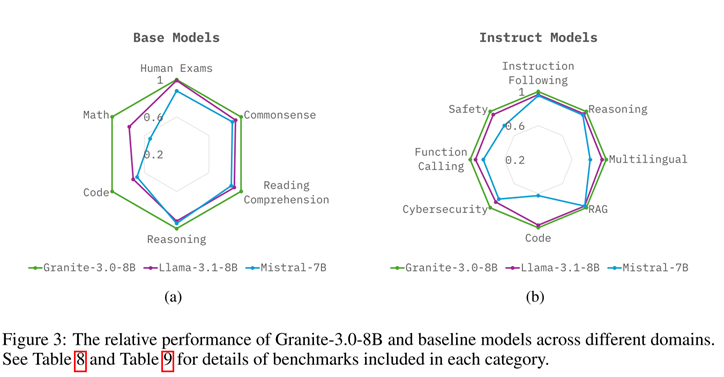
图:Granite-3.0-8B和基线模型在不同领域的相对性能
5.2 训练数据方面
·Granite 3.0
数据量:Granite 3.0 使用了大量的高质量训练数据,涵盖了广泛的领域和主题。高质量的数据有助于模型学习到更丰富的语言模式和知识。
数据多样性:训练数据包括文本、代码、对话等多种类型,使得模型在多种任务中表现出色。
其他模型
·BERT:训练数据主要来自 Wikipedia 和 BookCorpus,总共有16GB的文本数据。
·GPT:训练数据来自Internet,包括网页、书籍、新闻等多种来源,数据量更大。
·RoBERTa:使用了更大的训练数据集,包括 Common Crawl 和其他来源,数据量约为160GB。
·T5:训练数据来自 C4 数据集,这是一个从 Common Crawl 清洗后的数据集,数据量也非常大。
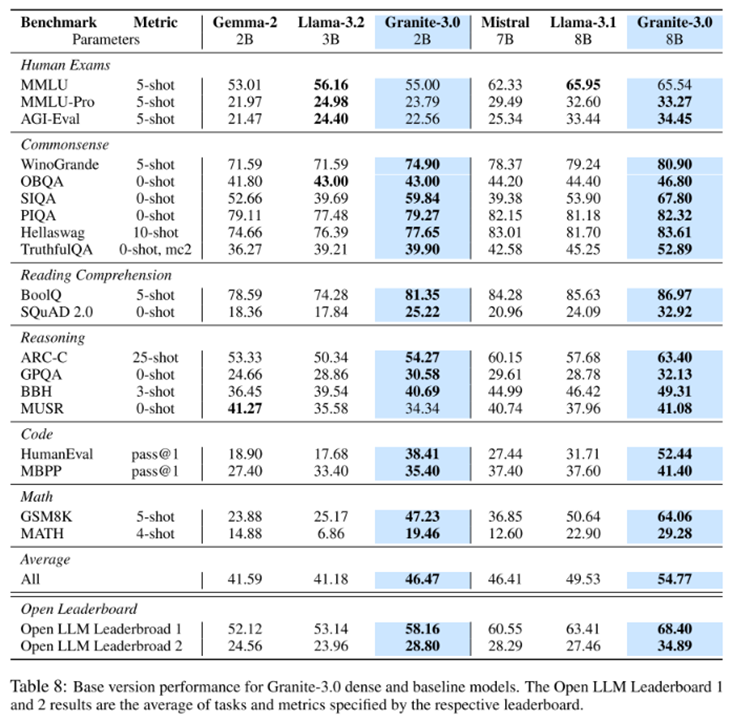
图:Granite-3.0密集和基线模型的基本版本性能
5.3 应用场景方面
·Granite 3.0适用于:
1.内容创作:适用于文章生成、创意写作等任务。
2.智能客服:适用于构建对话系统和智能客服。
3.机器翻译:适用于跨语言文本翻译。
4.情感分析:适用于社交媒体监控、用户评论分析等。
其他模型
·BERT:适用于自然语言理解任务,如情感分析、命名实体识别等。
·GPT:适用于文本生成任务,如文章生成、创意写作等。
·RoBERTa:适用于自然语言理解任务,特别是在需要高精度的任务中。
·T5:适用于多种自然语言处理任务,特别是在需要多任务学习的场景中。
5.4 对Granite 3.0模型分析的总结
Granite-3.0 模型,无论是 8B 版本还是密集版本,都在多个任务和领域中展示了卓越的性能。特别是 8B 版本,凭借其大规模参数和高质量训练数据,能够在复杂任务中取得显著优势。而密集版本则在相同的参数量下,通过优化结构和训练方法,提高了模型的效率和性能,适合需要高性能和快速响应的应用场景。
Granite-3.0 模型在多个方面超越了基线模型,为自然语言处理任务提供了更强大的工具和支持。
Granite 3.0 模型在多个方面展现了其优越性,特别是在大规模参数、高质量训练数据、优化技术和多任务性能方面。与传统模型相比,Granite 3.0 在复杂任务和多样化数据中表现出更强的适应性和更高的性能。然而,这也带来了更高的计算资源需求。
6. 参考文献与资源链接
[1]IBM 推出 Granite 3.0:专为企业打造的高性能AI模型.文章链接:https://china.newsroom.ibm.com/2024-10-22-IBM-Granite-3-0-AI
[2]IBM Granite 3.0体验.文章链接:https://www.ibm.com/granite
[3]Huggingface的国内官方镜像网站.资源链接:https://hf-mirror.com/
[4]IBM Granite 3.0官方训练完成后的模型参数下载地址.资源链接:
https://hf-mirror.com/ibm-granite/granite-3.0-8b-instruct/tree/main
[5]IBM Granite 3.0模型使用教程.资源链接:
https://hf-mirror.com/ibm-granite/granite-3.0-8b-instruct
- Granite 3.0的论文链接.资源链接:
https://github.com/ibm-granite/granite-3.0-language-models/blob/main/paper.pdf
7. 旅行商问题(TSP)及开源代码(2024.12.20)
一、旅行商问题介绍
旅行商问题(Traveling Salesman Problem, TSP)是一个经典的优化问题,描述如何在访问一组地点、每个地点仅访问一次后返回起点的情况下,规划出总距离或时间最短的路径。
随着地点数量的增加,路径组合呈指数级增长,令求解变得困难。TSP 广泛应用于旅游规划、物流配送、城市交通、制造调度等领域,通过算法如遗传算法和模拟退火快速找到最优或接近最优的解,是现实中路径优化和资源分配的重要工具。
二、TSP典型场景
- 物流配送与快递场景
物流行业的配送员、货车或无人机经常需要将物品送到多个目的地。在实际操作中,问题通常涉及数百甚至数千个地址,这使得路线规划变得极其复杂。配送人员的目标是找到一条最短的路径,确保所有地址都被访问,同时还要考虑时间窗口、交通拥堵和车辆负载等因素。
如何在有限时间内完成所有配送任务?如何最小化行驶里程、时间和燃料消耗?
通过TSP算法,可以帮助物流公司找到最优路线,显著降低成本并提高效率。例如,UPS通过优化配送路径每年节省数百万美元的燃料成本。
- 制造业中的路径优化
制造业中,生产线上的设备(如钻孔机、激光切割机或机械臂)需要在多个预定位置完成任务。例如,在印刷电路板(PCB)制造过程中,机器必须在电路板上钻孔,钻孔的位置数量可能高达数千个。如果机器的移动路径没有经过优化,将导致大量时间浪费,进而降低生产效率。
如何优化机器的移动路径,减少空闲时间?如何在高强度工作环境下提升设备的寿命?
通过将所有任务点视为TSP中的节点,可以找到设备移动的最短路径,从而缩短加工时间,提高生产效率。例如,在PCB工厂中,TSP算法帮助优化钻孔机的操作路径,使得生产速度提升10%-20%。
- 交通与航班调度
在航空业、城市交通或公共服务中,经常需要规划多站点的访问路径。例如,航空业领域中,一架飞机需要飞往多个城市,如何规划一条既节省燃油又符合航班时刻表的路径?垃圾回收方面,一辆垃圾车需要按照一定顺序访问城市中的多个垃圾站,如何找到最短路线以节约时间和燃油?
路径需要考虑地理分布、交通流量和时间窗口等现实因素。路径优化需要在短时间内完成,尤其是在航班调度或实时交通规划中。
通过TSP算法,可以在复杂的交通网络中找到一条高效的访问路径。例如,纽约市垃圾回收部门通过路径优化,每年减少数十万公里的行驶里程。
- 自动化与机器人路径规划
在自动化设备中,路径规划是关键问题。例如,在无人机送货场景中,无人机需要在多个客户地址之间高效移动,找到最短路径可以延长电池寿命、提高送货效率;对于扫地机器人而言,一台扫地机器人需要覆盖整个房间,但房间内存在障碍物,如何规划一条路径,确保最短时间内清扫完毕?
在动态环境中,机器人需要实时调整路径。需要平衡路径长度与任务执行时间。
TSP为无人机或机器人提供最优路径方案,减少任务完成时间。例如,亚马逊的无人机送货项目通过路径优化实现高效投递。
三、常见的TSP求解方法
- 穷举法
穷举法是解决 TSP 最直观的方法,它通过列举所有可能的路径组合,计算每条路径的总距离,最终选出最短路径作为最优解。尽管这种方法可以找到最优解,但它的计算量会随着城市数量的增加呈现指数级增长。
具体来说,若有n个城市,则路径组合的数量为 n!(即 n 的阶乘)。例如,访问 10 个城市时,可能路径多达 3,628,800 条,因此,穷举法仅适用于非常小规模的问题。它的计算复杂度为 O(n!),是所有算法中最耗时的,但对小规模问题来说,依然是一个可靠的选择。
- 动态规划法
动态规划(Held-Karp 算法)是优化 TSP 的经典方法之一,通过分解问题,将计算量从指数级降为 O(n(2)·2(n))。Held-Karp 算法是动态规划在 TSP 中的一个实现,它基于递归思想,记录中间计算结果以避免重复运算。其核心是从一个起点开始,动态计算从起点到不同城市的最短路径,直到遍历所有城市后返回起点。
相比穷举法,动态规划法显著提升了计算效率,但在城市数量较多时,仍然容易受到内存和时间的限制。
- 启发式算法
启发式算法通过规则或策略快速生成一个可行解,尽管无法保证是最优解,但适合快速求解接近最优的结果。例如:
最近邻算法:从起始城市开始,每次选择与当前城市距离最近的城市继续访问。这种方法简单易行,但可能因过于贪心而导致全局路径较差。
贪心算法:优先选择距离最短的路径,逐步形成整个解。这种算法在直观上类似于构建拼图,但可能存在路径不闭合的问题。
启发式算法计算简单,速度快,适合解决 TSP 的大规模近似解。
- 元启发式算法
元启发式算法通过模拟自然现象或社会行为寻找最优解,具有广泛的适用性。
遗传算法:遗传算法通过模拟生物遗传与进化的过程,使用选择、交叉和变异三种机制迭代优化路径。初始种群生成后,算法会评估每条路径的总长度(适应度),优胜劣汰生成下一代,经过多次迭代后,输出的路径接近最优。它灵活高效,适用于复杂的大规模 TSP。
模拟退火算法:模拟退火算法借鉴物理退火的过程,通过随机搜索并在初期接受次优解,逐步找到全局最优解。它在降低路径长度的同时避免陷入局部最优,非常适合需要高精度解的场景。
蚁群算法:模仿蚂蚁觅食行为,蚂蚁在路径上释放“信息素”,路径越短,信息素越浓,吸引更多蚂蚁选择,从而迭代优化路径。蚁群算法在求解 TSP 和路径规划问题上表现出色。
粒子群优化算法:模拟鸟群或鱼群的行为,通过个体与群体的合作找到最优路径,特别适合连续优化问题。
元启发式算法的共同特点是灵活高效,但需要通过调整参数来适应不同规模的问题。
四、TSP案例及求解结果展示
在长三角地区,四十个知名景点如珍珠般散落,吸引着无数游客的目光。为了解决旅行者在规划路线时的困扰,我们采用元启发式算法进行了一次创新实践。
本次案例中,我们将这四十个景点的经纬度坐标作为输入数据,通过算法模块的处理,旨在找出一条最优的旅行路线。这一路线不仅能够最大化游览效率,还能在保证旅行体验的同时,优化行程中的时间和经济成本。通过本次案例,我们展示了如何利用先进算法为旅游规划提供智能化解决方案。
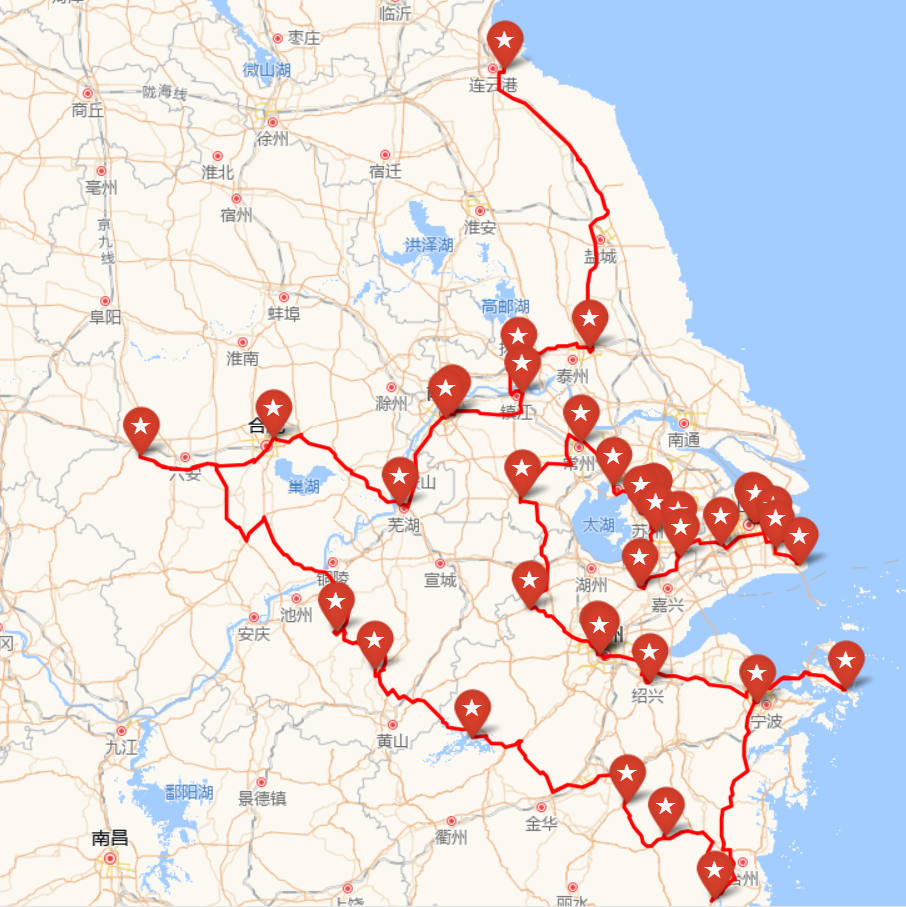
长三角旅游规划的tsp求解结果图
五、TSP开源代码
为了让更多开发者和研究者深入了解并应用路径规划算法,我们推出了单车路径规划(TSP)的开源版本。项目旨在解决旅行商问题(Traveling Salesman Problem, TSP),通过给定的订单、车辆和仓库信息,计算出最优的配送路线。项目使用 Python 语言开发,利用了 haversine 库来计算地理坐标之间的距离,以及 flask 框架来提供一个简单的 web 服务接口。
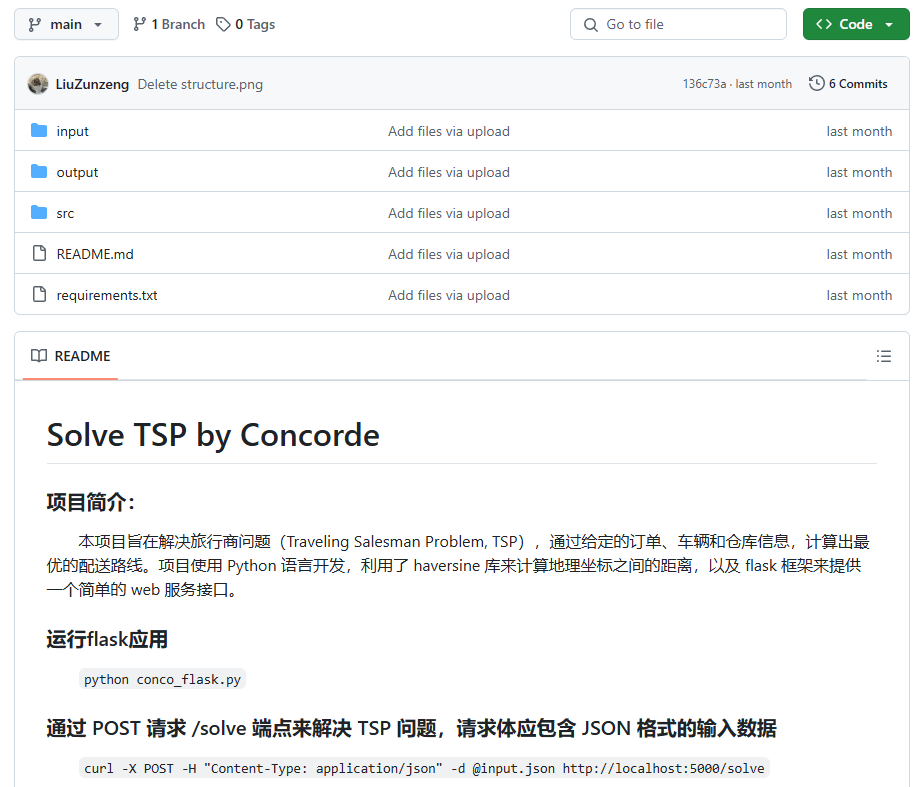
我们希望 TSP 的开源版本能够推动路径规划技术的广泛应用,帮助开发者和研究者在物流、交通、外卖等实际场景中快速找到优化方案,同时降低学习和开发门槛,让更多人参与到算法创新和改进中。
欢迎关注并私信“久章智能”公众号后台,发送关键词“TSP开源代码”即可获取!
8. CEC 2025年随机作业到达的柔性流水车间动态调度竞赛(2024.12.24)
随机到达柔性流水车间调度问题(FFSROA)是一个复杂的动态优化问题。首先,由于作业选择和机器分配这两个离散子问题的耦合,使得搜索可行解和最优调度解空间变得复杂,这两个子问题是不可分割、相互交织的。其次,由于存在大量的调度方案,即多模态调度方案,因此可以实现局部最优。该问题的非凸性导致没有明确的优化梯度,从而使优化过程更加复杂。最后,由于作业随机到达,因此需要实时动态优化调度。该算法需要能够在不中断的情况下重新评估和优化操作,这对时间效率提出了更高的挑战。此外,在实际调度场景中,随机到达的订单数量往往达到数千个,因此大规模的特性加剧了FFSROA动态调度问题的复杂性。因此,在解决这些问题时,同时考虑时间效率和搜索效率是至关重要的,这将弥合复杂的现实世界优化挑战和高级优化算法之间的差距。
FFSROA的动态调度问题是一个在实际场景中广泛遇到的具有挑战性的优化问题,其中进化算法在解决FFSROA.调度问题方面具有很大的潜力。这是SFFSROA近年来在CEC会议上的首次竞赛,将推动进化计算方法在现实世界问题中的应用。
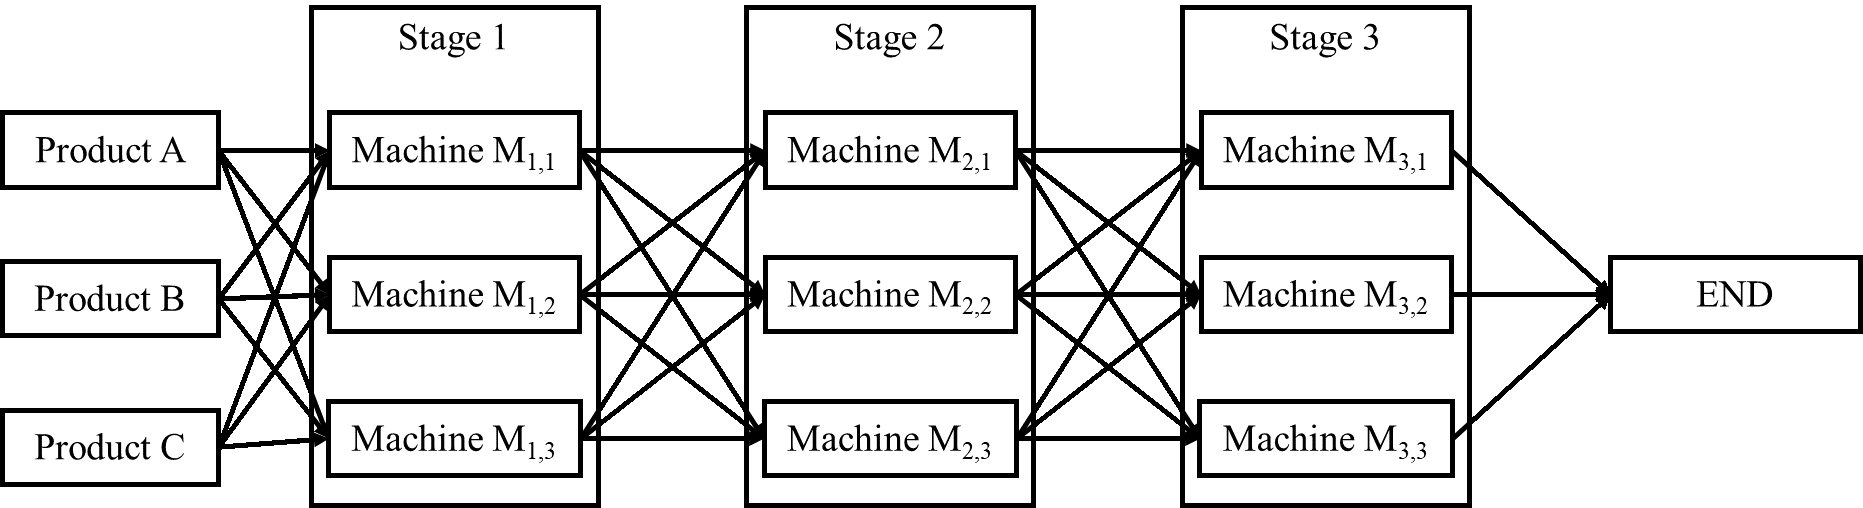
Figure 1 The flexible flow shop scenario.
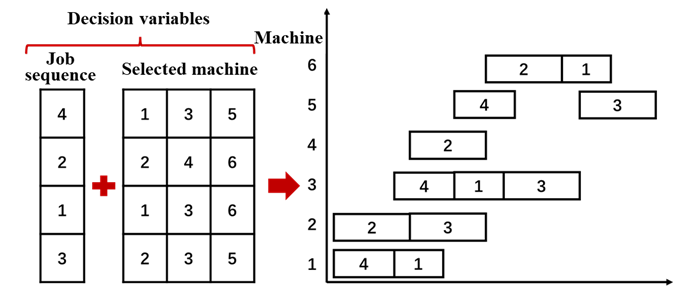
Figure 2 The diagram of decision variables.
在本次竞赛中,我们仔细选择了三种具有代表性的柔性流水车间方案。如图1所示,每个场景由不同的产品、处理阶段和每个处理阶段中的多个并行机构建。通常,决策变量包括作业的处理顺序和每个阶段并行机的选择,以作业的准时交付率为目标,如图2所示。过期订单将被停止处理。本次竞赛将呈现具有随机作业到达的柔性流水车间的三个规模的动态调度问题:1000个订单、5000个订单和10000个订单(详细规格将在竞赛网站上提供)。作为柔性流水车间动态调度问题的扩展,本次竞赛旨在推进生产调度的研究,提出优化算法,探索动态优化的潜在研究方向。
参与者需要开发一种算法来有效地解决这个复杂的调度问题。参与者需要提交完整的源代码。此外,应提供简要介绍代码的结构、功能和变量的代码文档,以便于组织者快速理解。评估将在相同的计算资源下进行,包括计算能力和时间,在三个灵活的flow shop场景中的所有问题实例中进行。将比较参与者算法在计算时间到期之前输出的最优调度解。在所有实例中获得最多最优解决方案的参与者将被加冕为冠军。在性能相同的情况下,将考虑进一步的指标,如次优解的数量和平均计算时间。
参与者应通过指定的电子邮件提交其源代码和文档([email protected])并允许在截止日期前多次提交。组织者将在截止日期后开始评估提交的材料,并在评估完成后宣布结果。参与者可以通过提供的联系信息寻求支持和反馈。我们估计这次比赛将有大约20人参加。
竞赛题目请见:https://github.com/SIA-aps/CEC2025-DFFSP-competition
CEC2025官网:https://www.cec2025.org/
CEC组织者:
刘昶
所属单位:中国科学院沈阳自动化研究所,沈阳,中国
电子邮件:[email protected]
长期从事复杂制造过程建模、生产调度和智能优化的理论和应用研究。她承担了多项国家级科技项目,包括863计划、国家重大科技项目和自然科学基金。她的团队在复杂制造系统生产调度和智能优化以及基于数据和知识双驱动的生产调度闭环优化方面积累了丰富的理论和应用研究经验,形成了全面深入的方法体系。发表学术论文50余篇,专利和软件著作权20余项,获省部级科技进步一等奖、发明专利奖、科研成果5项。在她的领导下开发的“中科云翼智能排产系统”,已经在离散和半流程行业中得到了实际应用。
王瑞
所属单位:中国科学院沈阳自动化研究所,沈阳,中国
电子邮件:[email protected]
简介: 2020年获得东北大学软件学院硕士学位。目前,他是中国科学院沈阳自动化研究所的工程师。他的研究领域包括多目标进化优化、流水作业调度和进化深度强化学习。
师长伟
所属单位:中国科学院沈阳自动化研究所,沈阳,中国
电子邮件:[email protected]
简介:2023年获得哈尔滨工程大学动力与能源工程学院硕士学位。他目前是中国科学院沈阳自动化研究所的助理工程师。他的研究兴趣包括车间调度优化和进化算法的应用。
**张新杰 **
附属公司:上海久章智能科技有限公司,中国上海200437
电子邮件:[email protected]
简介:张新杰毕业于复旦大学,拥有20多年IT行业IT服务经验:包括运营和优化应用、项目开发、管理和咨询经验。
金耀初
所属单位:西湖大学工程学院,杭州310030,中国
电子邮件:[email protected]
简介:金教授分别于1988年、1991年和1996年在中国杭州浙江大学获得理学学士、硕士和博士学位,2001年在德国波鸿鲁尔大学获得博士学位。他是中国西湖大学工程学院教授。他是亚历山大·冯·洪堡(Alexander von Humboldt)人工智能教授,德国比勒费尔德大学技术学院自然启发计算和工程主席。他还是英国萨里大学计算机科学系计算智能教授、特聘主席。他曾是芬兰Jyvaskyla大学的“芬兰特聘教授”、中国东北大学的“长江特聘客座教授”和澳大利亚悉尼理工大学的“特聘访问学者”。他的主要研究兴趣包括进化优化、进化学习、可信机器学习和进化开发系统。金教授现任《复杂与智能系统》主编。他是2016-2021年IEEE认知和发展系统事务的主编,2013-2015年和2017-2019年IEEE杰出讲师,IEEE计算智能学会技术活动副主席(2015-2016)。他是2018年和2021年IEEE Transactions on Evolutionary Computation杰出论文奖以及2015年、2017年和2020年IEEE计算智能杂志杰出论文奖的获得者。2019年至2021年,他连续被《科学网》评为“高度引用研究员”。他是欧洲研究院院士。
9. 第七届复杂系统数据驱动优化国际会议(DOCS 2025)(2024.12.30)
第七届复杂系统数据驱动优化国际会议(DOCS 2025)将于2025年8月15-17日在中国昆明举办,我们诚邀复杂系统驱动优化相关领域的研究人员、从业人员和学者投稿。
10. The EURO Meets NeurIPS 2022 Vehicle Routing Competition(2025.2.25)
【摘要】解决车辆路径问题(VRP)是许多工业应用的一项重要任务。尽管VRP传统上是在运筹学(OR)领域进行研究的,但最近它们已成为机器学习(ML)社区广泛工作的主题。OR和ML社区都开始将ML整合到他们的方法中,但方式截然不同。虽然OR社区主要依赖于简单的ML方法,但ML社区通常使用深度学习,但无法超越OR基线。为了解决这一差距,EURO Meets NeurIPS 2022车辆路线竞赛汇集了OR和ML社区,这是之前几场竞赛的共同努力,旨在解决由领先的车辆路线软件提供商ORTEC提供的现实世界数据上具有挑战性的VRP变体。挑战集中在具有时间窗口的“经典”确定性VRP(VRPTW)和新订单在一天内到达的动态版本上。超过50个团队在13周的提交时间内提交了解决方案,不仅在竞赛问题上争取最佳表现,而且还在争夺排行榜的最长统治地位。竞赛的目标已经实现,运筹学和最新技术在几个获奖作品中都发挥了重要作用。
【关键词】机器学习、组合优化、随机优化、带时间窗的车辆路径问题、动态调度问题
一、介绍
每天,数以百万计的卡车和其他车辆在全球各地执行交付或服务。为这些车辆找到最佳路线对于公司降低成本和环境影响至关重要。车辆路径问题(VRP)是著名的旅行商问题(TSP)的推广,因此一直是重要研究活动的焦点。在VRP中,目标是为一组车辆和一组客户找到路线,这样每个客户都会被其中一辆车访问一次,并且行驶的总距离(或产生的旅行成本)最小化。文献中已经对VRP的许多扩展进行了研究(Vidal等人,2020),例如,包括时间窗口(称为VRPTW),它要求在特定时间段内向客户交付,以及随机变量(例如,客户之间的旅行持续时间不确定)或随时间变化的动态变量(Pillac等人,2013)。
VRP传统上是在运筹学(OR)领域进行研究的,解决方法主要依赖于使用精确方法或启发式方法搜索可行解的空间(Laporte等人,2014; Poggi和Uchoa,2014; Costa等人,2019)。近年来,该问题也引起了机器学习(ML)研究人员的关注(Nazari等人,2018;Kool等人,2018,Kwon等人,2020;Hottung等人,2020,Xin等人,2021b;d O Costa等人,2020),da Costa等人,2021,Xin等人,2021a;Kool等人,2022b;Bai等人,2021;Choo等人,2022),他们开发了各种使用深度神经网络(DNN)的方法,通过最优解或使用强化学习。虽然这些技术在针对特定问题的组件和通用搜索方案方面有所不同,但它们中的大多数目前都没有超越最先进的OR解决方案策略,OR解决方案战略通常基于快速局部搜索,并采用额外的元启发式策略来指导对解决方案空间的探索。
ML和OR社区在车辆路径问题上的工作进展截然不同,有时使用不同的解决方案评估实践、硬件和基准,对速度和解决方案质量的强调不同,对面向应用程序的工作和面向方法的工作有不同的观点。鉴于此,EURO Meets NeurIPS 2022车辆路线竞赛旨在将两个社区团结起来,共同解决相同的路线问题和基准,从而促进地区之间的异花授粉。该比赛是VeRoLog比赛的共同努力(Gromicho等人,2019年),欧洲车辆路径和物流优化工作组(VeRoLog),IJCAI AI 4TSP竞赛(Zhang et al.,2023)的EURO数据科学工作组满足优化(DSO),以及DIMACS实施挑战(Archetti等人,2021)由离散数学和理论计算机科学中心(DIMACS)组织。比赛涉及解决VRPTW的静态和动态版本,目标是为OR和ML社区提供利用学习算法和高级方法的机会。除了前三场比赛外,最近其他相关比赛的例子是亚马逊最后一英里路线挑战赛(Merch´an等人,2022)和CEC-12电动汽车路线问题比赛(Mavrouniotis等人,2020)。
本文概述了竞争和经验教训。我们在第2节中定义了竞争问题,在第3节中描述了赛程设置,在第4节中总结了决赛团队的方法,第5节讨论了最终结果,第6节进行了回顾。
二、问题陈述
长期以来,VRPTW一直是运筹学研究人员(Kallehauge等人,2005年)的重点,因为它出现在多种应用环境和问题变体中,例如家庭医疗路由(Fikar和Hirsch,2017年)、技术员路由(Paraskevopoulos等人,2017年)和集成卡车-无人机送货(Chung等人,2020年)。我们选择了VRPTW及其动态变体进行竞争,因为这些问题是规范的,易于建模,但由于客户访问的时间窗口限制和车辆的容量限制,寻找低成本的解决方案具有挑战性。除此之外,VRPTW的静态和动态版本没有得到机器学习社区的大量工作,这使它们成为使机器学习社区更接近现实世界应用程序并鼓励OR社区使用更先进的机器学习方法的主要目标。在下文中,我们将VRPTW形式化,从标准(静态)版本开始,然后是其动态变体。
静态问题设置:VRPTW是容量限制VRP(CVRP)的一种受限变体,其中每个客户都要求在指定的时间间隔内交付,称为时间窗口。静态问题的定义如下。本次竞赛中考虑的VRPTW问题实例由n个地点(一个仓库和一组n-1个客户)、一个n×n矩阵D组成,该矩阵指定了在每对地点之间行驶的时间(以秒为单位)(它表示实际的道路行驶时间,以秒为单位,既不是欧几里德也不是对称的)、每个客户i的产品需求量(qi)以及车辆可以携带的最大数量Q,也称为车辆的容量。
由节点i表示的每个客户还具有服务持续时间si和时间窗口[e(i),l(i)],其中e(i\<)l(i),服务/交付必须在该时间窗口内开始,s(i)表示为客户i提供服务所需的时间。允许车辆在时间窗口开始之前到达客户所在地,但必须等到交付窗口开始才能开始交付。时间窗口关闭后无法开始交付。通过这种方式,竞争对手将时间窗口约束视为硬约束。可用车辆的数量没有限制。
VRPTW的一个可行解决方案包括一组在停车场开始和结束的路线,这样每个客户在指定的时间窗口内都可以在一条路线上访问,并且分配给一条路线的总需求不超过车辆容量Q。目标是找到一个可行的解决方案,最大限度地减少所有路线的总驾驶时间。请注意,车辆数量、服务时间和等待时间不是本次比赛的目标。该问题定义遵循最近DIMACS VRPTW挑战中使用的惯例,除了矩阵D不是欧几里德矩阵,车辆数量是无限的。通过这些约定,即使在动态环境中,问题的可行性也得到了保证(见下一节)。
动态问题设置:对于问题的动态变体,请求在一天中到达不同的一小时时段。求解器可以选择在当前时间段中分派哪些请求,必须为哪些请求创建可行的路由,以及推迟到哪些请求与稍后可能到达的新请求合并。有些请求是“必须执行”的请求,必须在当前时间段内发送,因为将它们延迟到下一个时间段将使它们的时间窗口不可行。在最后一个时间段中,所有请求都必须执行。从静态VRPTW实例的数据中,对每个时间段的请求的位置、需求、服务时间和时间窗口进行统一采样,然后过滤具有不可行时间窗口的请求。
三、大赛详情
比赛分为资格赛阶段和最后阶段,资格赛阶段的前10名参赛作品将在100个隐藏测试实例上进行测试。在资格赛阶段,结果将显示在公共排行榜上。在资格认证阶段,静态问题的提交时间限制为3至8分钟,具体取决于实例的大小,动态问题的每个时间段时间限制为1分钟。在最后阶段,这个时间限制分别增加到每个时间段5到15分钟和2分钟。
在快速入门存储库中,提供了一个包含250个静态VRPTW实例的公共数据集。这些是ORTEC提供的真实实例,使用了来自美国一家食品配送服务公司的匿名数据。这些实例包含200到900个客户。根据这些静态实例,环境通过在5到9个时间段内从静态客户集中采样100个请求(之后过滤具有不可行时间窗口的请求)来创建动态实例,具体取决于实例。公共实例和提供的环境可用于开发求解器或训练机器学习模型。
所有实例均按照LKH3使用的惯例以VRPLib格式提供。由于静态问题是动态问题的特例,因此使用相同的协议对求解者进行静态和动态问题变体的评估。对于这个协议,我们使用了一个用Python实现的环境,该环境遵循OpenAI gym接口(Brockman等人,2016)。在这里,环境接受一个动作并返回一个观察结果、一个奖励、一个指示环境是否完成的标志,以及额外的信息。这个术语来自强化学习,在强化学习中,求解器可以被视为与环境交互的代理。在这个术语中,观察定义了每个时期的VRPTW/请求选择问题,动作是定义一组调度路线的解决方案,奖励是该时期解决方案(一组调度的路线)的成本(驾驶持续时间)的负值。解决一个问题直到完成(有多个时期)可以被称为环境的一个插曲。
3.1 基线
我们为参与者在开发求解器时提供了一些基线。
静态基线:作为静态变体的基线,我们提供了混合遗传搜索(HGS)算法的实现(Vidal等人,2012;Vidal,2022),该算法将遗传算法与局部搜索相结合。HGS及其扩展已被用于为许多车辆路线问题变体产生最先进的结果(Vidal等人,2013,2014; Vidal,2022)。具体来说,我们提供的基线是Kool等人(2022a)使用的HGS-CVRP的扩展(Vidal,2022)赢得DIMACS实施挑战的VRPTW轨道,因此可以被认为是最先进的。该实现使用了Vidal等人(2013)的策略。通过搜索有效地评估时间窗约束。此外,与HGS-CVRP相比,它还包括Nagata等人(2010)的额外交叉。人口和社区规模管理的动态参数,以及一些代码优化。
动态策略:到目前为止,使用HGS解决的所有车辆路线变体都是静态的。在我们的情况下,扩展一个静态求解器来处理所需的动态请求,选择在任何给定的时间段上应该服务哪些请求。这样的扩展并非易事,需要额外的客户选择策略。
为了选择在每个时间段中要分派的请求,我们在快速启动代码库中提供了三个初始的简单策略:(1)贪婪:每个可用的请求都将在当前时间段内被分派。这意味着所有请求都包含在HGS路由优化中;(2) 懒惰:只会发送必须发送的请求。必去请求是不能因为违反时间窗(由环境指示)而被延迟到下一个时间段的请求;以及(3)随机:随机选择要在当前时间段中调度的请求:以50%的概率独立地调度每个请求。请注意,为了获得可行的解决方案,必须提交的请求将始终包含在内。
此外,在比赛期间,我们使用机器学习增加了两条额外的基线:(1)监督:使用甲骨文求解器(使用未来信息)创建示例,以训练神经网络来预测甲骨文发送的请求,以及(2)DQN:使用强化学习训练深层Q网络(DQN)(Mnih等人,2013)代理,通过与环境重复交互来选择请求。机器学习基线仅用于说明目的,并没有超越贪婪基线。这些基线共同提供了初步的比较结果,并被列入公共排行榜,但不是作为官方参与者。
3.2 评分和提交系统
团队被要求提交可以在给定实例的情况下生成解决方案的代码:例如,手工设计的启发式算法,或用强化学习训练的策略。这允许我们在隐藏的测试实例上测试提交的代码,我们使用这些测试实例来根据这些实例上的解决方案质量来确定最终的赢家。如问题陈述中所述,每个实例的得分计算为所有车辆行驶的总时间(即不包括服务或等待时间)。鉴于此,较小的分数更可取。
对所有团队的静态问题的隐藏实例和所有团队的动态问题的隐藏实例的每个实例的得分进行平均,从而导致对这两个问题变体的团队进行单独的排名。然后,对每支队伍的两个排名进行平均,得出每支队伍在整个比赛中的最终排名。这确保了无论实际分数如何,这两个问题的权重都是相等的。如果平局,则将分数本身取平均值,而不是排名。
为了启用代码提交,我们使用了Codalab Competition平台,并在快速入门存储库中为参与者提供了说明。代码在基于Dockerfile的Apptainer/Singulity容器内执行,以确保为所有参与者提供相同的环境,以便他们可以重现以进行测试。该环境有一个CPU内核(Intel(R)Xeon(R)Gold 5118 [email protected])、一个GPU(Nvidia TitanRTX 24GB)和32GB RAM。
3.3 奖品
我们为获奖者提供了以下奖项,总计超过5000 €。
-
最佳表现:2022/750/500 € 排名第一/第二/第三
-
评审团奖:250 €
-
青年才俊奖:250 €
-
排行榜奖品:总计1300 €
根据第3.2节所述的决赛隐藏数据集排行榜标准,对前三名奖项进行评分。为了进一步鼓励创新想法,即使它们没有带来最佳表现,组织者也会酌情将“评审团奖”授予一种提供新颖方法论想法的方法。对于这个奖项,我们寻求一种方法:(1)提供了一种新颖的解决方案;(2)使用了机器学习;(3)在规定时间内取得了良好的性能;(4)没有获得第一名。
“青年才俊奖”授予仅由学生和/或博士生组成的表现最佳的团队。最后,排行榜奖金为50/30/20 €,每周颁发给排行榜上1/2/3的数字,以鼓励早期竞争。
四、团队贡献总结
每个决赛团队都在一篇短文中描述了他们的方法,并在最后的研讨会上进行了介绍(见第6节)。论文和演示幻灯片均已发布在比赛网站5上。我们在这里概述了决赛选手的贡献。
Kleopatra Jungel et al. (2022):通过减少一些随机化步骤并在本地搜索迭代中为不变的路由实现缓存机制,改进了静态变体的HGS。对于动态问题,他们实现了一种可参数化的HGS(PC-HGS)奖品收集变体,该变体根据一组奖品来联合优化调度请求和路由的选择,这些奖品表示当前时代调度请求的偏好。最优奖励是先验未知的,但机器学习模型被训练来预测奖励,使用损失函数来鼓励PC-HGS结果接近预期的预言解决方案(见基线)。
OptiML vanDoornetal.(2022):通过删除Kool等人(2022a)引入的有序交叉、初始结构和不断增长的社区/人口组成部分,简化了基线人类基因组系统的实施。中所示。他们在父级选择步骤中添加了多样性标准,对本地搜索进行了代码优化,并对参数进行了广泛调整。对于动态问题,他们的方法模拟了未来请求的多种场景,为此,他们使用求解器作为oracle优化了路由(见基线)。在模拟中经常与必去请求结合的May-go请求也被标记为“必去”,并且这个过程会重复几次,以定义要分派的最终请求集。然后使用静态求解器优化该集合,并分派所有具有至少一个(原始)必须执行请求的路由。
Team SB Kwon et al. (2022):调整了HGS参数,并将二元锦标赛推广到k路锦标赛,其中k自动调整,以便如果最近找到新的最佳解,则更频繁地选择更高适应度的个体。此外,为了鼓励多样性,在产生一定数量的后代和温暖的重启机制后,将个体从种群中移除。动态变体使用了两个神经网络:一个用于预测请求的优先级,另一个用于选择必须分派的请求。这些用于HGS算法,具有修改后的目标,可以选择请求,根据额外距离权衡优先级。这两个网络都是使用强化学习进行训练的。
HustSmart Li et al. (2022):将EAX交叉添加到HGS中,并添加了SISR算法,以便在每次找到新的最佳解决方案时对解决方案进行优化。对于动态问题,他们为每个请求计算一个启发式定义的惩罚分数,并使用OR工具来解决VRPTW,同时允许以惩罚为代价放弃访问。这导致了一组请求,然后使用HGS算法对这些请求的路由进行了进一步优化。
Miles To Go Before We Sleep Reese et al. (2022):针对静态问题对HGS代码进行了多次性能改进,并在不同的训练实例子集上调整了参数。对于问题的动态变体,他们实现了两种启发式方法,用于根据请求与必须执行的订单的(基本)关闭程度来选择要发送的可能执行订单的请求。使用HGS对给定选择的路线进行优化。
ORBerto Hood Hildebrandt et al. (2022):针对问题的静态变体调整了HGS参数,并在一组采样的未来场景中优化了动态变体的调度请求集。为此,他们定义了一个考虑所有场景的单一集成问题,并使用列生成过程解决了该问题。使用HGS优化了结果请求集的路由。
HowToRoute Mesa et al. (2022):降低了强化过程的频率,并在HGS算法中实施了调整后的交叉。对于动态变体,他们发送了接近必去请求的可能去请求,并使用HGS找到了解决方案。然后,如果这降低了路由中请求的平均成本,他们应用了一种方法从路由中删除可能的请求(将被推迟)。使用HGS进一步优化了最终选择。
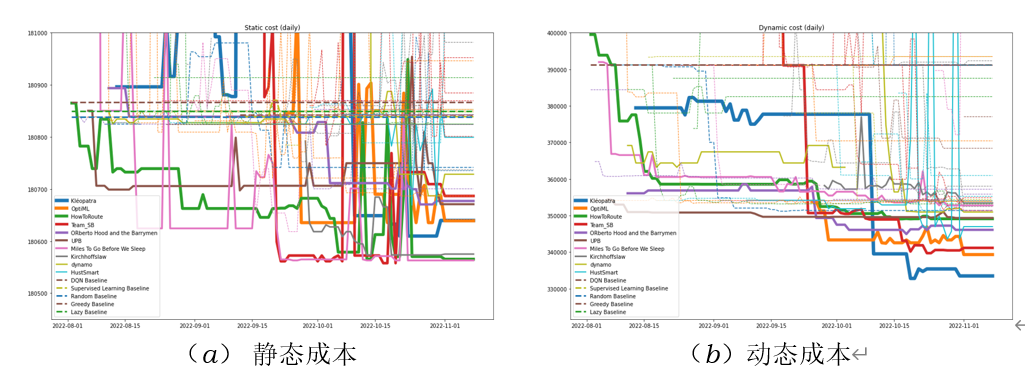
图1:比赛资格赛阶段的静态和动态结果
Kirchhoffslaw Ao and Zong (2022):针对问题的静态变体调整了HGS参数,并使用强化学习训练了一个神经网络,以选择动态变体的调度请求。操作对应于是否应该选择订单,最终奖励是通过将每个时期对所选请求运行HGS后的最终成本与贪婪基线方法的最终成本进行比较来计算的。
UPB Dieter (2022) :专注于问题的动态变量,并实施了一种后悔策略,该策略使用关于请求分布的可用信息来分析计算每个可走请求的遗憾值:当请求将被立即调度时,可能会错过的改进。遗憾值低于阈值的请求会立即发送,并使用HGS进行优化。
dynamo GhannamandGleixner (2022):为HGS增加了一个额外的HGreX交叉,以解决静态问题。对于动态变体,他们调整了HGS,允许在优化中包含一部分请求,其中以订单的平均成本(总驾驶时间除以请求数量)为目标。惩罚确保必须立即发出的订单,并支持额外的延迟条款,包括时间窗口提前结束的请求。
五、结果
图1显示了在资格赛阶段不同团队的静态和动态问题变体在公共排行榜上的结果。由于不同评估的结果可能略有不同,图表并没有严格减少,但对于这两种问题变体,随着比赛的进行,我们看到结果有明显的改善趋势。团队在静态和动态问题上的平均排名决定了排行榜上的整体排名,如图2所示。在比赛期间,排行榜上的参赛者人数稳步增加,一些决赛选手在资格赛阶段结束时才进入公共排行榜的前10名。
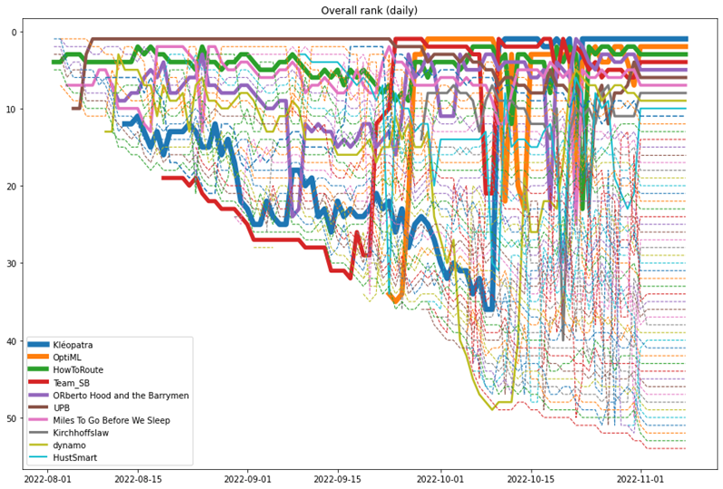
图2:比赛资格赛阶段的排行榜排名
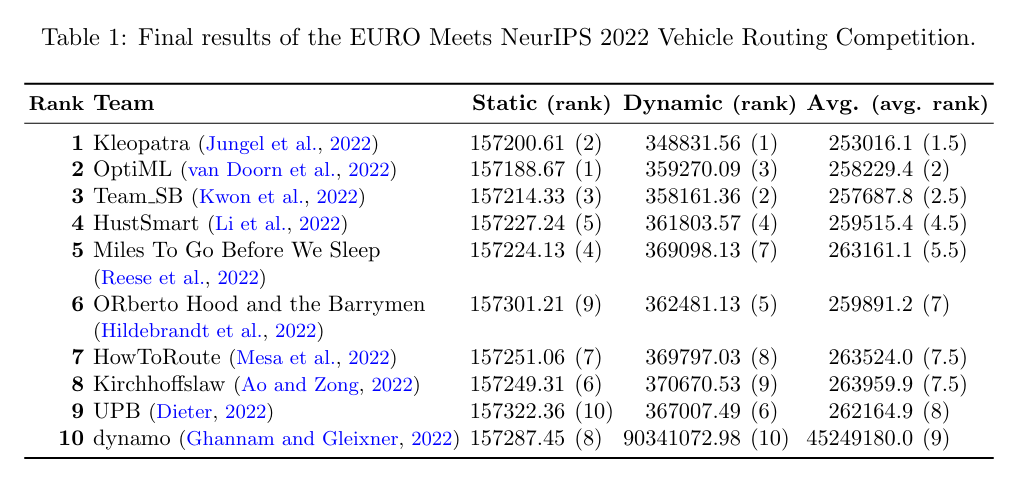
公共排行榜的前10名确定了决赛选手,在比赛的最后阶段对他们进行了全面评估。这是使用隐藏测试集完成的,它由100个实例组成,这些实例在静态和动态变体中都得到了解决,运行时间更长(见第3节)。表1显示了决赛选手的结果,其中团队根据他们在问题的静态和动态变体上的平均排名进行排名。Kleopatra队(Jungel等人,2022年)获得第一名,在动态问题上排名第一,在静态问题上排名第二,赢得2022欧元。OptiML团队(van Doorn等人,2022)在静态问题上排名第一,在动态问题上排名第三,总体排名第二,赢得了750欧元。SB队(Kwon等人,2022年)获得了第三名和500欧元,在静态问题上排名第三,在动态问题上名列第二。总的来说,我们观察到每个团队在问题的静态和动态变体上的表现之间存在很强的相关性,这表明团队能够在这两个问题之间很好地分配他们的努力。
评审团奖授予SB团队,因为他们使用基于机器学习的创新方法取得了优异的成绩。青年人才奖授予Kleopatra团队。最后,在资格认证阶段进入公共排行榜前三名的排行榜奖项授予了UPB、Kleopatra、SB、4pd vrp和OptiML团队。
大赛期间使用的所有真实数据,包括用于最终评估的隐藏数据集,都已在大赛GitHub存储库的CC BY-NC 4.0许可证下提供。我们希望这个数据集将继续被用作现实世界的基准。出于可验证性和再现性的目的,用于最终评估的所有设置和决赛选手找到的单个解决方案。此外,还发布了求解器,以及复制最终结果表的笔记本。大多数决赛队伍都公布了他们的代码,该代码链接在比赛网站上。
六、回顾
最终,近150支球队通过网站注册,其中50支球队提交了最终参赛作品。在资格审查阶段,共提交了800多份意见书。180人加入了Slack工作区,在那里交换了大约4500条消息,因此这被积极用于与参与者进行交流。参与者包括来自运筹学和机器学习社区的研究人员,以及来自学术界的许多团队和一些行业参与者。与会者来自世界各地。
NeurIPS的总结研讨会于2022年12月7日以虚拟会议的形式举行。约有30人参加了比赛,其中包括比赛组织者和10支决赛队伍的成员。录音可在比赛网站上找到。
事后看来,静态问题的(现实世界)数据集包含许多实例,这些实例太小,无法在HGS基线上进行改进,因为最佳或接近最佳的解决方案总是能在短的CPU时间内找到。尽管如此,这部分挑战仍然带来了有益的方法和实践发展。特别是,在静态变体方面排名第一的团队OptiML开发的软件已发布为PyVRP,这是一种最先进的开源VRPTW求解器,可以很容易地从Python中使用。这将有助于机器学习研究人员在未来的车辆路线问题上建立和贡献最先进的OR求解器。
与静态变量相比,问题的动态变量在基线策略之外取得了非常显著的进展。所有最好的方法都将机器学习作为其获胜策略的关键组成部分。这表明,机器学习不仅在未来很有前景,而且已经可以在动态优化问题上与其他方法竞争。
有两个问题变量的动机,但根据参与者的组合表现对参与者进行评分,是为了奖励对两个变量都有效的多才多艺的方法,并确保努力既用于提高静态性能,又用于处理问题的动态方面。在实践中,大多数团队为这两种变体实施了特定的解决方案策略,在少数情况下,只调整了静态变体的基线算法参数。
从技术角度来看,Codalab平台使我们能够评估代码提交,但我们需要进行许多调整才能使其适用于我们的用例。由于我们的评估需要GPU,我们不得不连接我们自己的计算工作器,虽然Codalab提供了Docker映像来支持此使用情形,但它假设全天候运行专用工作器,这浪费了(GPU)计算资源,因为大多数时间提交队列将是空的。为了将提交作为共享计算机群集上的作业进行评估,我们必须1)切换到Apptainer/Singulity(因为Docker需要不可用的根权限),2)调整Worker脚本以在队列为空时终止,以及3)设置单独的外部监控脚本以在队列中有新提交时启动作业。
除了评估,还有一些额外的挑战:Codalab排行榜没有正确计算排名,因此我们发布了一个正确的排行榜,该排行榜将在我们自己的比赛网站上自动更新。未来,鉴于挑战的组合,我们将研究Kaggle或AICrowd等其他平台。尽管如此,带有实时排行榜的提交平台在比赛中发挥了至关重要的作用,参赛队伍告诉我们他们每天刷新页面多次。公开的结果鼓励团队在比赛初期表现更好,积极参与,排行榜奖是额外的激励措施。
七、结论
作为比赛的组织者,我们很高兴地看到,这次比赛成功地将AI和OR研究人员聚集在一起,产生了新的方法,推动了最先进的ML和OR技术,以解决VRPTW的静态和动态版本。此外,我们还提供了比赛中的实例,作为研究人员可以用来测试新方法的现实世界基准。所有开发的基线方法和许多参与者的实现也都是公开的。未来,组织团队将继续努力,将OR和AI社区聚集在一起,解决相关的现实世界优化问题。
致谢:
我们要感谢ORTEC赞助了大部分奖金池,以及EURO VeRoLog和DSO工作组,他们为评审团和年轻人才奖提供了额外的支持。比赛中使用的计算基础设施由埃因霍温理工大学HPC实验室慷慨赞助。最后,我们要感谢EURO和NeurIPS会议在组织本次比赛时给予的支持。
11. 制造业计划革命:APS如何让复杂生产排程从数天缩至1小时?| 附实战案例拆解(2025.3.4)
本文是关于高级计划排程系统(APS,Advanced Planning and Scheduling)的内容,包括高级计划排程系统的概念、核心价值与功能体现、应用场景与具体案例等内容。
一、高级计划排程系统是什么?
高级计划排程系统(APS,Advanced Planning and Scheduling) 是制造业中用于智能化优化生产计划与资源调度的核心系统。它基于运筹学模型与工业级算法引擎(如遗传算法、禁忌搜索算法),将企业订单、资源、物料、交期等复杂约束转化为可执行的计划方案,旨在实现资源利用率最大化、生产周期最短化、订单交付精准化。
APS的核心价值与功能体现如下:
(1)实现计划(Planning)与排程(Scheduling)的双重优化。
计划层:解决“做什么”,进行中长期资源分配,例如:订单优先级排序(ETO模式下多项目的关键路径管理;物料需求预测(MTS模式下的库存水位平衡)
排程层:解决“怎么做”,进行短期任务执行,例如:工序级设备/人员分派(避免瓶颈资源冲突);动态插单与紧急任务重排(分钟级响应波动)
(2)进行多维度约束的协同处理。
时间约束:工作日历、订单交期、工序间隔时间
资源约束:设备产能、人员技能、模具/夹具可用性
逻辑约束:工艺路线(串行/并行/替代工序)、物料齐套性
业务规则:客户优先级、最小换型批次、环保停机要求
(3)与ERP/PLM/MES/WMS的深度集成
从ERP获取订单主数据,从PLM同步BOM及工艺路线,向MES下发工单指令,联动WMS校验物料齐套,形成“计划-执行-反馈”闭环。
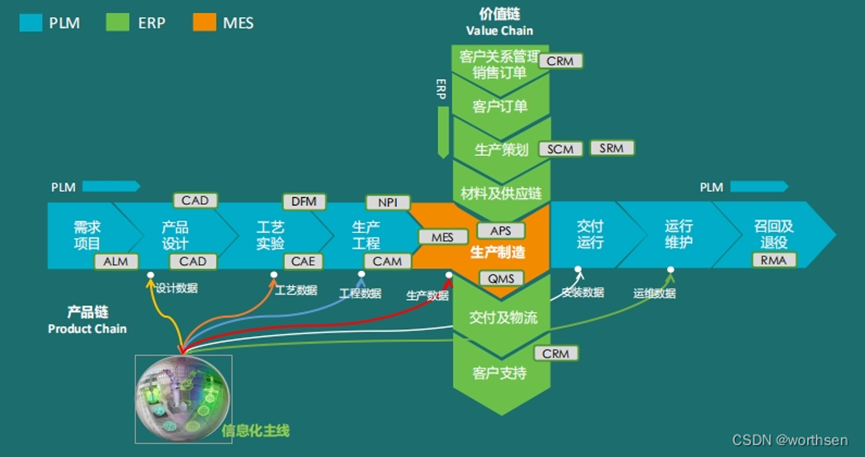
图片来源:https://blog.csdn.net/qq_38880380/article/details/127203433
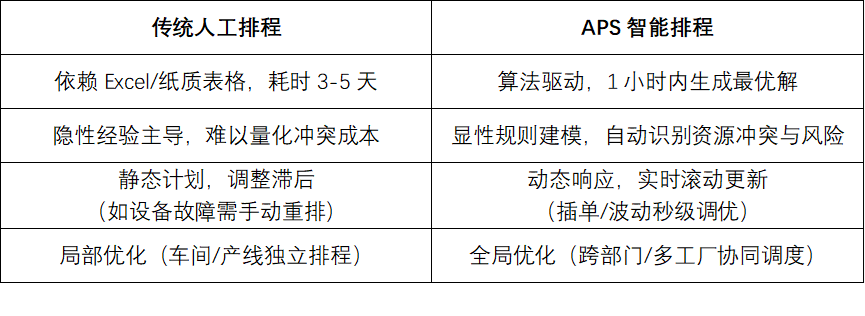
APS vs 传统计划的差异:
二、APS在不同生产类型的企业中有哪些应用场景?
- ETO(按订单设计)企业
ETO企业常面临『设计改10次,生产误3月』的困境,APS通过多项目并行管理,自动计算大型装备的关键路径,全局视角下动态平衡设计延迟与生产资源抢占风险。示例:船舶制造中,分段焊接与舾装工序的联动排程,规避船坞占用冲突。
- MTS(按库存生产)企业
基于需求预测,优化经济生产批量(EPQ),降低库存成本的同时避免缺货。示例:紧固件厂根据设备换模时间成本,智能合并同类订单,减少换型损耗。
- ATO(按订单装配)企业
半成品库存与订单需求的实时匹配,支持延迟策略(Postponement)下的快速配置。
示例:服务器厂商按客户配置需求,动态调度主板、硬盘、电源模块的装配序列。
三、APS应用举例
- 企业背景
某大型机械装备企业采用ETO项目型生产方式,人工利用excel制定生产主计划,计划逻辑为设计正排+生产总装倒排,之后由设计组长与班组长分别制定工序级计划。企业面临着大量订单延期交付的难题,应用APS改善其延期交付问题。
大型机械装备制造的两大核心工序为
(1)分段生产:
将整机分解为多个“分段”(如底座、压缩机、容器),在车间内分别经下料、加工,组装成大型模块,再运输到总装场地进行总装焊接(像拼乐高一样组合成整机)。
(2)总装:
在总装场地上安装在各分厂中生产的大型模块,如发动机、压缩机,需满足总装工艺顺序,如先放置底座,之后再焊接底座上的容器、压缩机等。
- APS采用联动分段生产与总装的三级计划排程体系
里程碑计划:管控分段模块设计/生产节点(如底座设计完成日)
主生产计划:精确到小时级的分段生产时间窗(如压缩机模块10月31日17:00前下线)
作业排程:工序级资源调度(如工作中心中设备a在10月25日9:00-12:00加工工序021)
APS联动体系以减少延期交付,最小化生产周期,提高设备使用率为目标,考虑约束如:
(1)设计与生产工作日历不同,设计为单班双休、生产为双班单休。
(2)分段生产各工作中心、总装场地有容量限制。
(3)物料齐套,检查库存量、在途量后,物料齐套方可排入资源使用序列。
- 典型冲突场景
总装场地是稀缺资源,假设A机某大型模块的分段生产未按时完成,导致场地被占用,原计划紧接着在此场地开展总装的B机的总装工序无法按计划开始,从而引起整条生产链延迟。如同『高铁追尾』:A项目延误占用总装轨道,B项目被迫急刹,APS则是智能调度中心,实时重铺轨道网络。
联动排程如何解决问题?
APS系统会做两件事:
(1)逆向推算关键节点:
以“订单交付日”为终点,倒推总装的最晚开始时间、各大型模块的分段生产的最晚完成时间。
例如:若总装至少需30天,交付日为12月1日,则总装必须在11月1日前开始 → 首个总装的底座模块的分段生产必须在10月31日前完成。
(2)动态平衡资源冲突:
当A机分段生产延迟时,系统自动:
a.是否有其他空闲的总装场地(如B机总装改到另一个场地进行)?
b.是否优先调用更多工人或加班加速A机延迟部分的生产?
c.若无法避免延迟,自动通知供应链推迟A机后续总装及所有B机大型模块的到料时间。
- 效果如何?
该企业应用APS后:
✓ 计划制定时间从7天→1.5小时
✓ 订单准时交付率从58%→82%
✓ 总装场地利用率提升41%
- 案例总结
大型机械制造的分段生产(影响总装工序开始时间)和总装排序(依赖场地可用性)必须协同排程,本质上是在解决:“如何让有限的场地资源,在不同工序、不同项目之间无缝衔接”。这正是APS系统在复杂制造业中的核心价值——通过算法实现跨工序、跨项目的资源最优编排。
四、全文总结
APS以运筹优化算法为技术引擎,让您的生产计划从“人脑经验”升级为“算法驱动”,大幅缩减计划制定及调整时间,决胜智造时代!
点击“https://mp.weixin.qq.com/s/RaQx9k5nYZMKeT_C2qd55A?scene=25\&sessionid=-162018659#wechat_redirect”可尝试MTS下demo案例。
欢迎咨询了解更多生产场景解决方案!(久章智能官网:http://www.jzlog.cn/#)
12. 【诚邀参赛】DOCS2025第一届“辽河杯”数据驱动的复杂系统优化算法竞赛(2025.5.13)
一、赛事简介
第一届“辽河杯”数据驱动的复杂系统优化算法竞赛以“搭建交流平台、挖掘优秀人才、激发创新思维、解决真实问题”为核心理念,致力于推动数据驱动的复杂系统优化领域的前沿发展。
本竞赛设置柔性流水车间动态调度问题和带时间窗的车辆路径规划问题两个赛道。初赛进行平台在线测评,两个赛道分别采用中科云翼智能排产平台和晞德求解器进行在线测评;决赛设置现场答辩环节,由专家顾问对方案的完整性、专业性和创新性进行综合评审。获奖者将获得由IEEE计算智能学会颁发的权威证书,并赢取丰厚奖金。
二、主办单位
辽河实验室
中国科学院沈阳自动化研究所
中国科学院软件研究所
西湖大学
华中科技大学
三、指导单位
IEEE计算智能学会
四、运营单位
久章智能
五、大赛顾问
曾鹏:中国科学院沈阳自动化研究所副所长,博士生导师,中国自动化学会理事、边缘计算专委会主任委员,辽宁辽河实验室常务副主任。主要从事工业网络、智能制造技术的研究工作。先后获得国家技术发明二等奖,国家标准创新贡献一等奖等科技奖励6项。
金耀初:欧洲科学院院士,IEEE Fellow,国家特聘专家,长江学者讲座教授。IEEE计算智能学会主席,《复杂与智能系统》主编。目前为西湖大学人工智能讲席教授,人工智能系系主任,“可信及通用人工智能实验室”负责人。曾任德国比勒菲尔德大学“洪堡人工智能教席教授”、英国萨里大学“计算智能”杰出教授、芬兰国家技术创新局“芬兰杰出教授”。长期从事人工智能与计算智能的理论、算法和工程应用研究。先后主持欧盟、英国EPSRC、德国联邦教研部、中国自然科学基金合作创新团队项目及重点项目。已发表论文500余篇,谷歌学术引用5.9万余次,h-index 为119, 2019年以来连续入选科睿唯安 “全球高被引科学家”榜单。获2025年度“IEEE Frank Rosenblatt Award”。
高亮:华中科技大学副校长,国家智能设计与数控技术创新中心主任。2018年获国家杰出青年科学基金,首届科学探索奖得主,IET Fellow,连续四年入选全球高被引科学家。出版专著17部,发表SCI论文700余篇,Web of Science引用2.7万次,H-index 82。授权发明专利90项,软件著作权28项。获国家科技进步二等奖1项、教育部自然科学一等奖2项等。现任IET Collaborative Intelligent Manufacturing和Light: Advanced Manufacturing期刊共同主编。长期致力于智能优化与机器学习在设计制造中的应用研究,尤其是智能设计与智能调度领域。
杨圣祥:英国德蒙福特大学计算机科学与信息学院教授、计算智能研究中心主任和数字未来研究院人工智能研究组主任。长期从事计算智能理论、方法及应用研究,其研究工作得到英国和欧盟研究基金会以及工业界的大力资助,先后承担了30余项科研基金项目。出版英文专著1部和英文编著2部,编辑国际会议论文集10余部,发表论文500多篇,其Google Scholar引用23400余次和H-index为78,入选2019年-2024年美国斯坦福大学发布的“全球前2% 顶尖科学家”(World's Top 2% Scientists)榜单。亚洲计算智能协会副主席。担任10余种国际知名期刊副主编或编委。
刘昶:中国科学院沈阳自动化研究所研究员。长期从事复杂制造过程建模、生产调度和智能优化的理论和应用研究。发表学术论文50余篇,专利和软件著作权20余项,获省部级科技进步一等奖、发明专利奖、科研成果5项。主持开发的“中科云翼智能排产系统”,已经在离散和半流程行业中得到了实际应用。
蔡少伟:中国科学院软件研究所研究员,博士生导师,约束求解研究室主任,智源青年科学家,获国家优秀青年基金,中国科学院“领雁”奖章,多次获得约束求解领域和形式化验证领域顶级会议CAV、CP、SAT的最佳论文和杰出论文奖,近十年来在国际SAT和SMT比赛获得十余个金牌,连续多年获得MaxSAT比赛非完备赛道冠军。长期致力于约束求解和芯片验证的研究,其求解器应用于华为、华大九天、微软、阿里巴巴、腾讯等著名企业。
燕冰:罗切斯特理工大学电气与微电子工程系的副教授。研究领域主要集中在智能电力和能源系统的运行优化、智能制造系统的规划与调度,以及大规模混合整数线性规划问题的数学优化方面,其研究工作得到了美国国家自然科学基金和能源部的资助。
张新杰:久章智能创始人。新疆大学计算数学本科,复旦应用数学硕士,上海财经大学世界经济博士毕业。20年以上信息行业服务经验,包括项目管理、咨询、开发、测试等 ;16年以上跨国公司项目群管理相关经验(IBM,Dunnhumby);5年运营管理经验(IBM);行业涵盖智慧城市、金融、零售、物流、电信等。
六、参赛对象
面向国内外高校的在校本科生、研究生、教师,以及企业和科研院所的专业人员。
七、赛程安排
5月10日:报名
5月15日:平台开放
7月15日:报名截止
7月30日:算法提交、线上评审(初赛)
8月19-21日:现场答辩、评审、颁奖(决赛)
八、奖项设置
特等奖1名:奖金5万元+IEEE CIS获奖证书
一等奖1名:奖金1万元+ IEEE CIS获奖证书
二等奖3名:奖金5000元+ IEEE CIS获奖证书
三等奖5名:奖金3000元+ IEEE CIS获奖证书
优秀奖若干名(最多10名):IEEE CIS获奖证书
九、参赛要求
参赛形式
通过赛事官网进行报名,详情参见后文。
可个人参赛或团队参赛,团队人数不超过5人,每位选手仅限加入1支队伍。
团队参赛时,由1名成员统一提交作品,其他成员需在报名时实名备案。
晋级限制
同一研究领域(赛道)下,同一导师指导的队伍最多2支晋级决赛。
若初赛或决赛阶段发现算法核心逻辑或创新性高度雷同,经评委裁定后合并为1支队伍并通知选手。
费用说明
竞赛不收取报名费、评审费,参赛者需自行承担差旅及食宿费用。
其他说明
报名成功即视为参赛选手同意并遵守本次比赛的全部规则,如参赛选手存在违反通知、规则、协议等行为,主办方有权取消其参赛资格。
十、初赛评审规则
通过资格审核的参赛队伍需在指定算法竞赛平台完成技术测试,并按要求提交完整的算法成果。竞赛平台将根据最优解质量动态更新各队伍的初步成绩排名,评审专家将综合平台实时排名数据与专业评审意见,最终遴选出晋级决赛队伍名单。
需特别说明,算法设计的原创性与技术创新性将作为重要评分维度,经查实存在学术不端行为的团队将立即取消竞赛资格。所有参赛者须严格遵守保密协议,禁止任何形式的赛题讨论、方案外泄及其他违反竞赛章程的行为。
十一、现场答辩流程
晋级团队须参与现场答辩环节,该环节包含技术方案陈述(含系统演示)、专家质询答辩两个核心模块。由领域权威专家组成的评委会将从方案的求解质量、技术实现完整性、学术专业深度、创新价值维度等指标进行综合评判,最终评定特等、一等、二等奖项。最终结果由“初赛成绩(40%)+答辩评分(60%)”加权确定,于答辩现场及会议官网同步公布。
答辩与颁奖将在第七届复杂系统数据驱动优化国际会议(DOCS 2025)会议现场举行。
十二、赛事报名
赛事介绍:https://www.ais.cn/attendees/index/2UUEUN
报名通道:https://www.ais.cn/attendees/toSignUp/2UUEUN
点击文末左下角“阅读原文”,即可跳转赛事官方网站。参赛者通过赛事官方网站进入对应赛道,点击【立即报名】,填写竞赛报名表上传系统进行报名。新用户需注册。报名不收取任何费用。
联系邮箱:
王老师:[email protected] 抄送[email protected]
13. 用“Free Energy Machine”统一组合优化求解:一个跨越统计物理与机器学习的方法(2025.6.26)
组合优化问题广泛存在于科学研究与工程实践中,从图划分、逻辑推理,到芯片布图、任务调度,几乎所有涉及离散决策的问题,都可以归结为某种形式的组合优化。然而,由于这类问题通常属于 NP-hard() 类型,随着规模的扩大,传统算法在效率和可拓展性上面临巨大挑战。如何在保持问题通用性的同时,又实现高效、可扩展的求解,一直是组合优化领域中的核心难题。
2024 年,Zi-Song Shen 等人提出了一种新的求解框架:Free-Energy Machine(简称FEM)。这一方法借助统计物理中的自由能最小化原理,结合机器学习中的自动微分与梯度优化技术,构建出一个统一、高效、可并行的组合优化求解器。在多项基准测试中,这一方法表现出了优异的精度和速度,并展现出极强的通用性和可扩展性。
一、理论基础与方法构建
FEM 的核心思想来源于统计物理。作者将组合优化问题抽象为一个“能量函数” E(σ),其中 σ 表示所有待求的离散变量配置。在物理中,寻找系统的最低能量状态对应于在零温度下寻找其最稳定的结构,对应到优化问题中即为寻找最优解。
由于直接搜索最低能量配置非常困难,FEM 引入了变分自由能函数作为近似手段。它通过一个可调参数 β(即温度的倒数)对能量和熵进行加权,形成以下自由能表达:
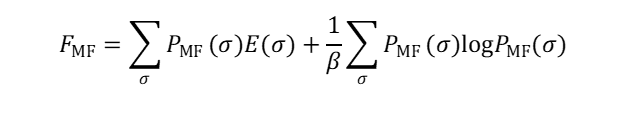
其中 P(MF) (σ) 是通过变分方法构造的近似概率分布,采用的是变量之间相互独立的均值场(mean-field)形式。这一分布使用 softmax 函数进行参数化,所有变量的概率项都可以通过可微函数表示,使得整个优化过程可以通过自动微分工具求解。
在优化过程中,FEM 模拟了一个从高温(随机性大)逐步冷却到低温(趋向最优解)的“退火”过程,类似于模拟退火算法,但更加系统化地结合了统计物理理论和机器学习框架。
二、算法特点与技术优势
FEM 在设计上融合了多个优势:
通用性强
传统的许多近似优化方法,如 Ising 机器或 QUBO 求解器,只适用于特定形式的问题(如二值变量、二次能量函数)。而 FEM 不依赖于特定建模结构,可以原生支持多值变量、高阶交互项乃至约束项,具备极强的建模能力。
高并行性
所有优化操作均基于矩阵乘法、softmax 函数和向量化计算,非常适合 GPU 或 FPGA 等现代并行硬件平台,尤其适合大规模问题求解。
优化器成熟
FEM 使用了深度学习中广泛应用的优化器(如 Adam),支持自适应学习率和梯度一阶、二阶估计,在优化效率和稳定性上表现出色。
副本机制增强探索能力
受 replica symmetry breaking 理论启发,FEM 同时维持多个优化副本,共同探索解空间,从而有效避免陷入局部最优。
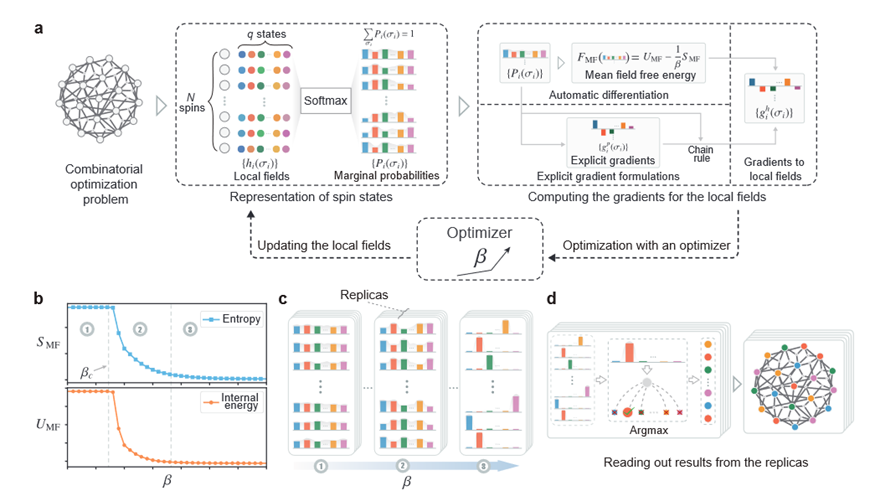
FIG. 1. The framework of implementing Free-Energy Machine.
三、应用验证与性能表现
作者在三类典型的组合优化问题中对 FEM 进行了深入测试:
- 最大割问题(Max-Cut)
FEM 在大规模图(如 K(2000))上找到了已知最优解,并在 G-set 数据集中对比当前最强方法dSBM,显示出更优的时间效率与解质量。
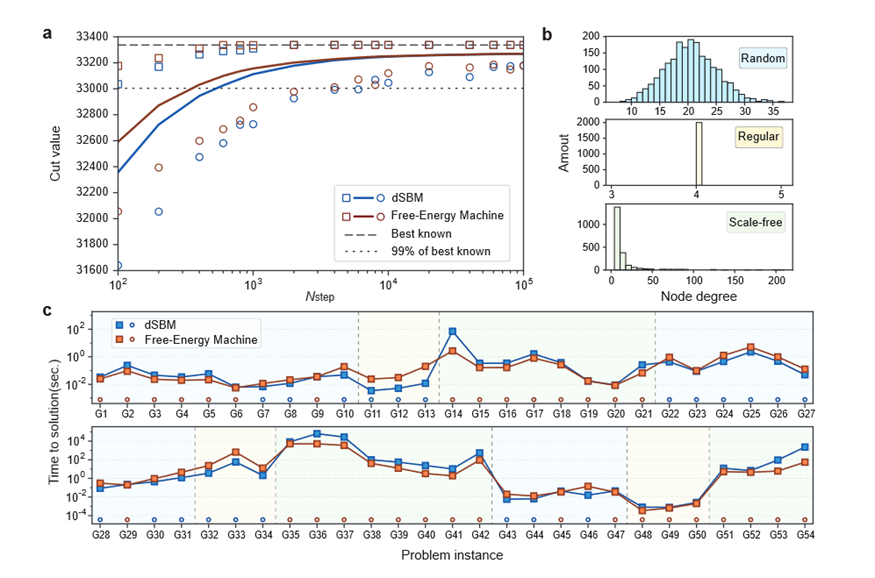
FIG. 2. Benchmarking results for the maximum cut problem. 图 (a) 展示了 FEM 在 K(2000) 图上的解质量分布,图 (c) 展示了不同图类型上的时间效率对比。
- 多路平衡最小割(q-way balanced Min-Cut)
该问题引入了多值变量和全局平衡约束,对建模能力提出挑战。FEM 不仅可以灵活建模,还在多个真实图数据上超越了 METIS 和 KaFFPaE 等工业级划分器,尤其在高分组数场景下优势明显。在一个包含近 150 万节点的大型芯片验证问题中,FEM 的边界通信开销比 METIS 减少了 22%\~26%。
- 最大 k-SAT 问题(Max k-SAT):
该类问题涉及高阶逻辑关系。FEM 在 MaxSAT 2016 的 454 个测试实例中,448 个达到最优解,其余也仅差一条逻辑。平均求解时间为 0.074 秒,远快于传统 CPU 上的启发式方法(如 Max-CTDS)。
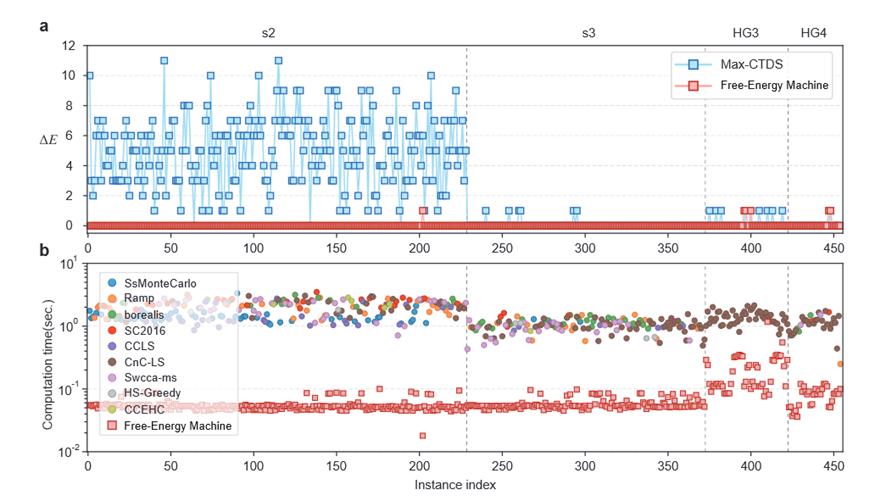
FIG. 3. Benchmarking results on the MaxSAT 2016 competition problems. 图 (a) 展示了解的最优性对比,图 (b) 展示了计算时间优势。
这些实验结果充分说明,FEM 在不同类型、不同结构、不同规模的组合优化问题中都具备强大的通用性和领先的求解能力。
四、潜在应用与未来方向
FEM 的建模通用性和执行效率,使其适用于一系列实际问题,包括:
-
图划分与负载均衡(例如芯片布局、并行计算资源分配)
-
社交网络与图神经网络中的社区发现
-
复杂逻辑推理与约束求解(SAT、规划问题等)
-
多任务调度与路径规划(如 UAV 任务、制造调度)
此外,FEM 的结构还可进一步扩展。例如,作者指出可以引入更精细的物理模型(如 TAP 自由能、Bethe 自由能)来增强模型表达能力;或者结合神经网络结构提升变分分布的表示能力。这些方向都为 FEM 的理论深化和实际落地提供了丰富的空间。
不过值得说明的是,FEM理论上通用,但是目前它默认处理的是无约束优化,在工程领域使用效果还有待商榷。
总结:
Free Energy Machine(FEM)提供了一种面向组合优化的通用求解框架,既具备理论上的完整性,又具备工程上的可行性。它将统计物理中的自由能最小化思想,与机器学习中的梯度优化技术有机结合,打破了传统优化算法在结构限制和规模扩展上的瓶颈。
对于运筹优化研究者以及处理大规模离散决策问题的从业人员来说,FEM 不仅是一个值得关注的新工具,也可能成为今后组合优化的一种主流方向。
项目代码开源可得,读者可访问如下链接了解更多内容:
https://github.com/Fanerst/FEM
14. 大语言模型与运筹优化的融合:当前进展、挑战及未来思考(2025.10.16)
传统的运筹优化解决方案通常采用“定制化建模+专业化求解”的方式。工程师需根据问题背景,结合专家知识构建数学规划模型,并通过求解器进行优化计算。如果客户对求解效率有较高要求,还需要专门开发定制化加速精确算法或启发式算法。
这一过程涉及需求调研、问题分析、数学建模、模型优化、算法开发、编程实现及调试等多个环节,既繁琐又容易出错,且通常需要大量时间和精力。因此,研究人员不仅需要具备深厚的运筹学背景,还需了解业务逻辑、精通数学建模以及编程和调试技能。
由此可见,运筹学在国内企业广泛应用的一个主要障碍是其较高的开发门槛。回顾运筹优化方案的开发流程可以发现,如果仅以“解决问题”为最低目标,而不考虑求解效果和速度,当前流程中最具挑战性的一部分是如何从非专业人员的需求描述中提取关键信息,并将其转化为数学规划模型。这一过程包含大量专家知识,很多信息是基于语义且难以量化的。正如杉数所提到的:“杉树过去8年,所有项目都要准确地将业务文字描述转化为数学语言([1])!”。
然而,随着大语言模型技术的快速发展,使得解决上述问题看到了希望。大模型的核心优势在于首次使机器能够“听懂”并理解人类语言,进而生成基于自然语言的响应。这使得人类能够直接以自然语言与机器进行互动。由于大模型依托海量的训练数据(几乎涵盖了人类所有知识),其强大的泛化能力、丰富的知识储备和出色的逻辑推理能力,使其在多个领域超越了单个人类专家的知识边界。因此,考虑到真实业务场景中往往蕴含了大量基于文本和语义的信息,是否可以借助大模型帮助我们“理解”这些信息,并建立相应的规划模型呢?一些结合大模型与运筹学的研究正是基于这一理念,试图利用大模型的语义理解能力,实现从客户需求到数学模型代码的自动生成,从而绕过传统的算法工程师定制化建模过程。我们将这一研究框架称为“大模型基于语言格式需求的辅助建模”。
01 大模型基于语言需求的辅助建模
该框架主要利用大语言模型强大的语言理解与生成能力,实现从“语言格式需求描述”到“完整运筹优化模型及代码生成”,再到“用优化求解器求解”的全过程。然而,由于大模型输出结果的本质是通过海量数据学习语言模式和逻辑关系,并基于概率进行预测,尽管结果看似合理,但其中可能存在“伪精确性”。在运筹优化模型的构建过程中,每一个变量、每一条约束的引入和设定都需要严格考虑,尤其在处理难以求解的非线性问题时,通常需要将其转化为等价的线性格式。只有经过严谨的数学推导,才能确保最终模型的正确性与可解释性。
大模型在处理这一流程时,无法确保每一步推导和转化的正确性,尤其在处理超长文本或大信息量任务时,产生“幻觉”的概率会大大增加。在运筹学中,即便是推导过程中微小的等价条件的充要性没有得到充分考虑,或者一个不起眼的符号错误,也可能导致最终结果的最优性无法保证。
尽管大模型的发展已催生出许多增强推理能力的方法,例如思维链(Chain-of-Thoughts)及其变体(如Tree of Thoughts、Graph of Thoughts)、渐进式提示方法(Progressive-Hint Prompting)、大模型智能体技术(ReAct)、反思机制(Reflexion)等,这些方法在数学应用题、24点游戏、小说写作等领域取得了显著进展,但目前基于语言的大模型辅助建模仍然仅能应对经典和简单的优化问题。在处理大规模高复杂性任务时,距离实际应用仍有较大差距。
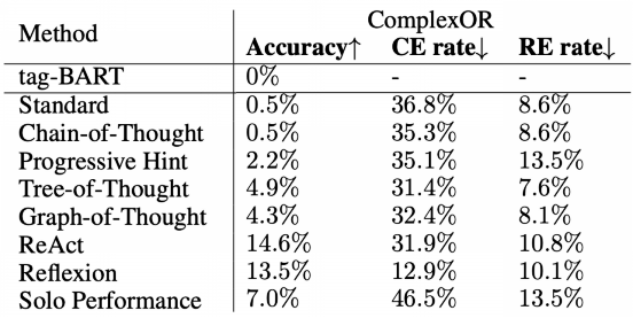
图1 基于大模型的算法在运筹优化问题建模上的表现([2])
图 1 中,左侧 Method 代表不同的基于大模型的算法,右侧展示了它们在复杂运筹优化问题数据集上的表现。从准确率可以看出,当前基于大模型的方法在复杂运筹优化问题上几乎全军覆没,最高准确率不超过 15%,即平均每 7 道题仅能解对 1 题,表现相当不理想。其主要原因在于,运筹优化的求解需要深厚的专业背景知识和极长的逻辑推理链路,而现有方法主要针对较简单的推理任务,因此难以适用于这一领域。
此外,该测试基于通用大模型,未针对运筹优化问题进行专业化微调,这在一定程度上限制了大模型的能力。然而,当前阻碍大模型针对运筹优化问题进行微调的核心瓶颈在于训练数据的稀缺性。目前开源的公共数据集多为单一且简单的场景,而优质的工业案例往往涉及私有数据,获取难度较大。
解决上述问题的最新实践有杉数的ORLM(Operations Research Language Model)运筹学大模型([3])。其核心贡献在于采用了一种半自动化方法——OR-INSTRUCT,用于创建、扩展和合成符合特定要求的数据,从而针对性地训练基准源大模型的优化求解能力。此外,杉数还构建了 IndustryOR,这是首个用于评估大语言模型解决实际运筹优化问题质量的工业基准测试。
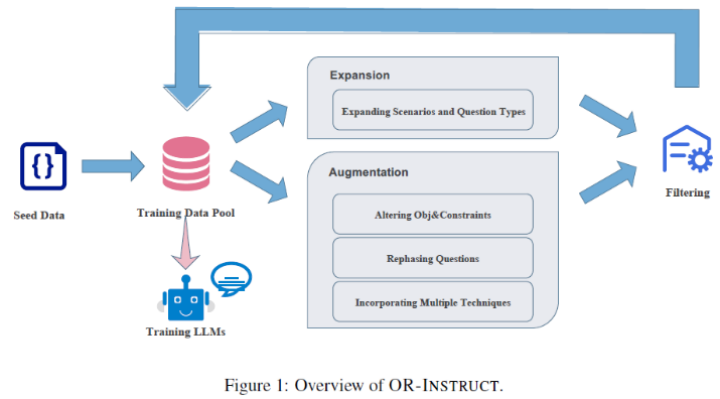
图2 OR-INSTRUCT方法框架
OR-INSTRUCT 通过 GPT-4 从 686 个真实行业案例中提取场景与问题类型作为种子数据,并通过扩展与增强操作生成了 30K 个训练样本。其中,扩展操作侧重于拓展应用场景,而非单一任务,从而提高数据的覆盖范围;增强操作则旨在丰富问题解决方案的多样性,涵盖问题描述、目标函数、约束条件的变更,以及不同建模技术的结合,以提升模型的泛化能力。
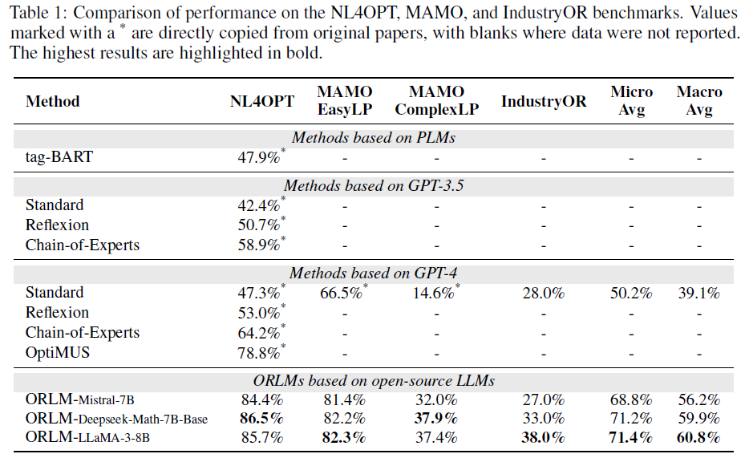
图3 不同模型的测试结果对比
在具体的训练过程中,杉数利用 OR-INSTRUCT 数据对多个约 7B 规模的开源大模型进行训练,包括 Mistral-7B、Deepseek-Math-7B-Base Shao 和 LLaMA-3-8B,并将训练得到的模型统称为 ORLM。测试结果显示,与未经过专门训练的开源大模型相比,ORLM 取得了显著的优化建模能力提升。例如,ORLM-LLaMA-3-8B 在 NL4OPT 和 MAMO(涵盖简单与复杂的线性规划)测试集,以及 IndustryOR 基准测试上,均达到了最先进的性能表现。与标准 Standard-GPT-4 相比,其微观平均提升 42.2%,宏观平均提升 55.4%。在求解复杂问题方面,ORLM-LLaMA-3-8B 在线性规划、整数规划和混合整数规划方面的表现优于 Standard-GPT-4。然而,在非线性规划及其他罕见问题类型上,两个模型的表现仍有待提升。
总体而言,在大模型基于语言需求的辅助建模这一应用中,数据是最核心、最关键的因素。并且尽管经过针对性微调的大模型在建模能力上相较于通用大模型有了显著提升,并在一定程度上降低了使用门槛,具备较强的通用性,但在面对复杂的工业级运筹优化问题时,仍存在较大困难,离实际应用落地还有不小距离。
02 使用大模型直接进行端到端的决策
如果说大模型基于语言需求的辅助建模主要依赖于大模型的语言理解与生成能力,那么使用大模型进行端到端决策则直接利用了 Transformer 模型的预测能力。传统优化问题的求解通常需要经历 **需求数据 → 数学建模 → 最优化求解 → 解决方案 **这一完整流程。虽然最终求得的解在理论上能够保证最优性,但整个过程复杂且耗时,且在不同问题之间缺乏泛化能力。如果我们已经拥有需求数据,且目标是直接得到可行的解决方案,那么是否有方法可以直接从需求数据到可行解之间建立起一个“映射函数”?通过这种方法,我们可以跳过繁琐的建模过程,只需将需求数据代入映射函数,即可快速得到可行解。基于这种“映射函数”获得可行解的决策过程,便被称为端到端决策。
端到端决策不直接对问题进行建模,而是学习从协变量 x 映射到决策z的决策规则,寻找一个能够直接将协变量映射到决策的规则函数。该框架的优势在于,一旦获得了决策规则函数,对于未来可能的情景,只需将相应的协变量代入规则函数,即可迅速得到决策,而不需要重新求解优化问题。这一特性使得端到端决策特别适用于需要快速决策的场景。
构建一个自变量到因变量的映射函数的方法有很多种,从最简单的多元线性回归到复杂的机器学习和深度学习方法都能实现。然而,由于现实中优化问题的最优解空间通常是高维非线性的,传统的线性回归方法难以得到理想的映射函数。因此,许多研究选择采用机器学习\深度学习方法来解决这一问题。例如,京东的端到端库存管理模型([4])就是一项典型的实践研究。该研究通过历史观测数据训练深度学习模型,能够直接从输入特征输出建议的补货数量,而无需任何中间建模步骤。
与传统深度学习模型相比,大模型在执行端到端决策任务时表现出更强的学习能力。这是因为大模型不仅能够处理结构化数据,还能处理非结构化数据和信息(如直接的语言描述),在上下文长度和知识广度上也明显优于普通深度学习模型。
例如,Google DeepMind 团队提出的优化方法——Optimization by PROmpting(OPRO)( [5]),聚焦于使大模型作为优化器,直接生成问题的解和提示词。以优化问题的求解为例,OPRO 的核心流程如图 4 所示。首先,OPRO 以 Meta-Prompt 作为大模型的输入,生成问题的可行解,并计算解的目标函数值作为评分。接着,新生成的解和评分组成“Solution-Score pair”被添加至 Meta-Prompt,用于下一轮优化。
显然,Meta-Prompt 的设计对于大模型是否能够胜任优化任务至关重要。Meta-Prompt 主要由两部分构成:
-
优化问题的相关描述:借助大模型处理自然语言处理(NLP)任务的优势,将问题的目标函数、约束条件以及相关背景用文字进行描述。此外,还可以添加非正式的正则化提示词,如“提示应简洁且具有普适性”;
-
优化的历史信息:适当的历史上下文演示有助于大模型识别潜在的模式。OPRO 会将历史解及其评分按升序排列,帮助大模型发现高评分解之间的相似性。
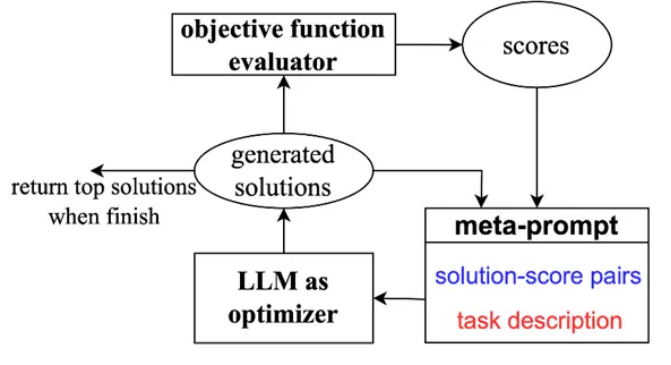
图4 Google团队的OPRO优化流程示意图
在生成解的阶段,可以通过每轮优化生成多个解来减少不稳定性,并通过自适应调整大模型的采样温度,以实现探索与开发之间的平衡。图3为OPRO在TSP问题上的求解结果,其中NN(Nearest Neighbor)和FI(Farthest Insertion)为求解TSP问题的经典启发式方法。在n=10和15时,大模型能够以极小的gap求得近优解,但随着TSP节点数的增多,LLM的求解性能显著下滑。
在生成解的阶段,可以通过每轮优化生成多个解,以减少不稳定性,并通过自适应调整大模型的采样温度,实现探索与开发之间的平衡。图 3 展示了 OPRO 在 TSP 问题上的求解结果,其中 NN(Nearest Neighbor)最近邻法和 FI(Farthest Insertion)最远插入法是求解 TSP 问题的经典启发式方法。在 n=10和15时,大模型能够以极小的 gap 获得近优解,但随着 TSP 节点数的增加,大模型的求解性能显著下滑。
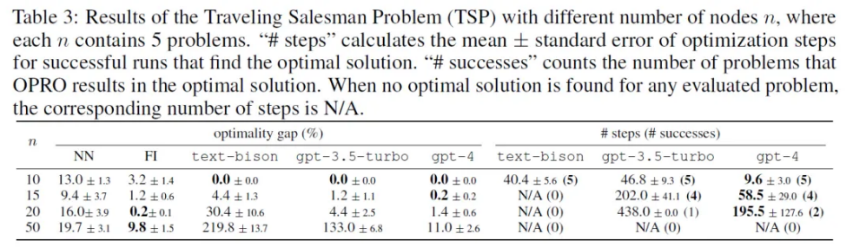
图5 OPRO方法在TSP问题下的性能表现
此外,清华团队的《City-LEO:使用大语言模型和端到端优化实现透明城市管理》( [6])首次提出了一种创新的大语言模型嵌入式智能体——City-LEO (LLM with End-to-End Optimization)。该智能体结合了大语言模型在先验知识逻辑推理方面的优势,将端到端建模框架与预训练随机森林相结合,有效缩小了预定义的大规模优化问题的范围,从而应对不确定运营环境中的城市管理挑战。
该研究设计的 City-LEO 智能体任务框架集成了代码保护机制,能够遵循 Gurobi 优化语言的规则进行迭代验证。图 6 展示了智能体的框架结构,包含问题匹配器、问题相关目标生成器、问题裁剪工具、端到端模型和响应提示器等关键组件。
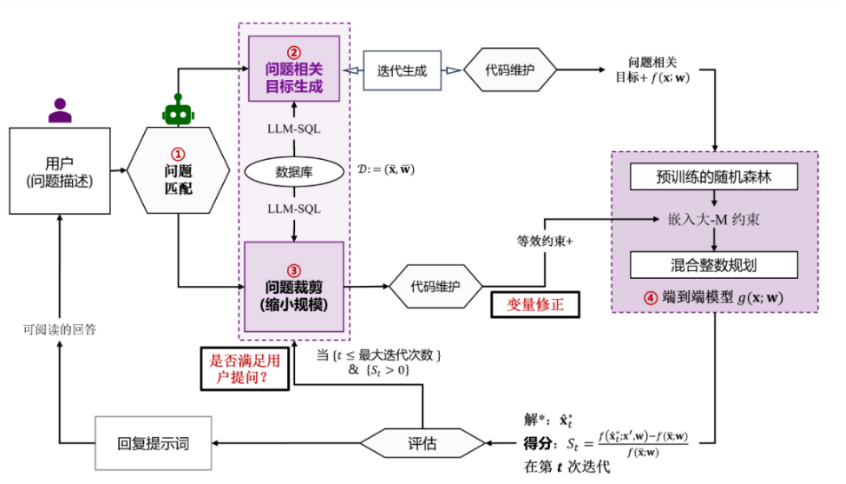
图6 City-LEO智能体结构
该方法的具体步骤如下:
-
问题匹配器将用户提问 Q与特定领域的智能体进行匹配。
-
问题相关目标生成器生成基于用户提问的目标函数f (x;w),作为端到端优化问题的辅助目标。
-
问题裁剪工具缩小决策变量x的可行域X,主要通过搜索并参数化与用户提问关联较弱的决策变量x'∈X 实现。
-
端到端模型包含两个目标函数:随机森林相关目标和用户提问相关目标。本体由不同的经过预训练的随机森林模型组成。
-
维护机制使用自我迭代来确保大语言模型输出的可靠性。
该研究将 City-LEO 应用于城市共享电单车(E-Bike Sharing,EBS)运营管理场景,并进行了数值实验。在端到端模型中,随机森林模型基于共享电单车系统的实际运营数据和相应的天气数据进行训练。树形结构能够捕捉用户需求中的内在不确定性,因为它依赖于历史气象信息和运营记录进行学习。最终的数值实验结果表明,City-LEO 能更好地匹配用户提问的问题,并将相关目标融入端到端优化模型中;在不同的问题缩小范围设定下和在精度上有一定的妥协时,City-LEO表现出了优越的计算效率;City-LEO 提供的共享电单车运营策略相较于完整模型更好地满足了用户需求。
总体而言,与基于传统深度学习的端到端框架相比,直接使用大模型进行端到端决策能够显著提升学习能力和决策质量;与传统运筹优化方法相比,获得较好的映射函数后,可以迅速获得可行解,响应速度大大提升;而与通用大模型相比,它能够处理更为复杂且工业化的优化问题。然而,大模型的端到端决策框架的开发和训练,项目复杂度、开发难度和所需的专业知识投入不亚于传统运筹优化模型。此外,端到端模型的训练需要大量高质量、高垂直性的历史数据作为输入,因此该框架更适用于依托大型企业平台经济、拥有丰富私有历史数据(支持模型训练及算法实施效果因果检验)且需要快速响应的特定优化问题场景,而不太适合通用性的运筹优化问题。
03 使用大模型辅助改进现有智能优化算法
另有一些研究主要利用大模型来辅助改进现有的智能优化(启发式)算法。启发式算法通常通过一些启发式规则跳出局部最优解,寻找全局最优解。这些规则的设计大多基于经验总结,而不依赖严格的数学推理,因此非常适合大模型来指导规则设计——它们具备一定的规律性,但无需严格的推理证明(类似于生物学中通过大模型寻找有效的蛋白质分子结构)。在某些情况下,大模型的“涌现”现象可能会生成意想不到的算子,从而显著提高启发式算法的求解效率。
相关研究包括 Liu 等人(2024)([7])的工作,该研究提出了一种大模型驱动的进化算法(LLM-driven EAs, LMEA),首次将大语言模型应用于进化组合优化器。该方法通过提示词工程引导大模型对当前种群进行选择、交叉和变异等经典进化操作,避免了对各类算子复杂设计的需求,也无需对模型进行额外的训练。同时,LMEA 配备了一个自适应机制,用以调节大模型的温度,从而在探索与利用之间取得平衡,避免搜索陷入局部最优解。
对于 LMEA 方法,其提示词的构建主要包括三部分:
-
问题描述和解的特性:包含优化问题的描述以及期望解的特性与格式;
-
上下文例子:通过展示优化问题的解及其对应的适应度函数值,帮助大模型理解这些信息,通常来自当前种群;
-
任务说明:为大模型提供明确的任务指引,包括父代选择、交叉和变异等操作,用于产生新解。
不难发现,LMEA 方法的提示词构建与上文中的 OPRO 方法有相似之处。然而,OPRO 更侧重于直接让 LLM 根据当前种群生成新的解;而 LMEA 方法则从进化思想出发,利用大模型的优势,驱动选择、交叉和变异这三个经典进化算子,从而实现更高效的进化。
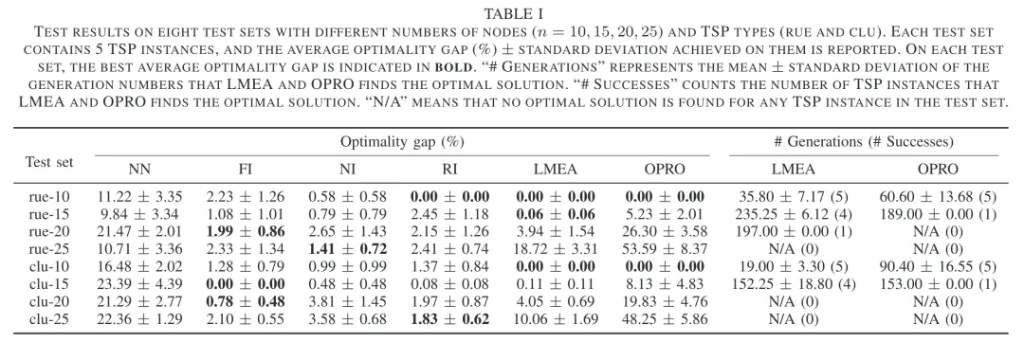
图7 LMEA方法在TSP问题上的求解结果
图 7 展示了 LMEA 方法在 TSP 问题上的求解结果,并与不同启发式方法以及 OPRO 方法进行了对比。实验结果表明,LMEA 方法在小规模问题(n=10 和 n=15)下得到的解与最优解非常接近,且在所有测试案例中,LMEA的表现都优于 OPRO方法。然而,随着节点数的增加,LMEA 和 OPRO 都未能很好地处理大规模 TSP 问题,其性能不及传统启发式方法。
尽管 LMEA 借鉴了进化算法的思想来指导大模型生成解,但某种程度上,它仍可归为“端到端”框架一类,因为与 OPRO 一样,LMEA 也是通过大模型直接生成解。这种直接生成解的方式,可能会限制大模型在处理大规模组合优化问题时的表现。因此,越来越多的研究者开始利用大模型的优势,并引入进化计算(Evolutionary Computing, EC)思想来生成启发式规则,这类技术也被称为语言超启发式(Language Hyper Heuristic, LHH)。
相关研究包括 Google DeepMind 团队完成并发表于《Nature》上的研究([8])。与大模型直接生成解的求解范式不同,该研究的目标是生成用于求解的启发式规则。论文介绍了一种名为 FunSearch 的方法,通过在函数空间中搜索并利用反馈循环实现启发式规则的自动化设计。FunSearch 方法是一个对求解程序的迭代过程,每次迭代中,系统会从当前的程序池中选择一些程序作为提示词,由大模型生成新的程序并自动进行评估。能够正常运行的程序将被加入现有程序池,从而形成自我改进的循环。
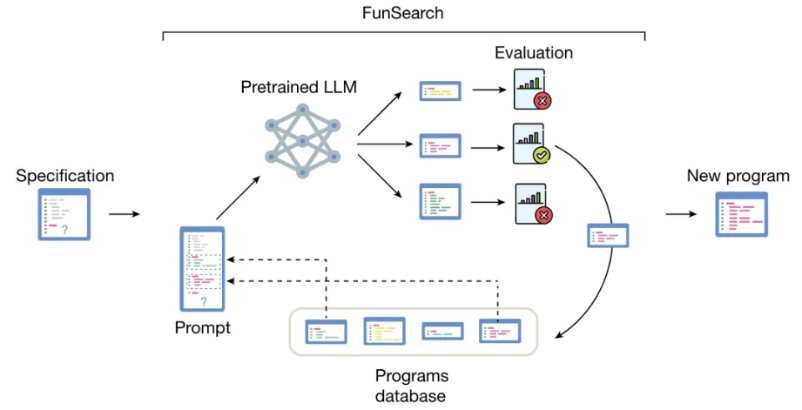
图8 FunSearch方法流程图
如图 8 所示,FunSearch 方法通过不断生成新程序并进行评估,采用迭代循环的方式对启发式规则空间进行搜索,从而获得更高效、更具性能的求解程序。为提高 FunSearch 的搜索效率和性能表现,将解(代码程序)被表示为框架(Skeleton)形式,只对关键部分的代码进行优化和搜索。
同时,FunSearch 方法在帽集问题(Cap Set Problem)和装箱问题(Bin Packing Problem)上进行了实验验证。实验结果表明,在某些帽集问题的样例中,FunSearch 方法得出的解超过了迄今为止已知的最好解。而在装箱问题上,FunSearch 同样表现出卓越的性能,在不同算例中超越了 First Fit 和 Best Fit 启发式方法。
与直接求解不同,FunSearch 方法从算法设计的角度出发,探讨如何更好地利用大模型在理解和推理方面的优势,辅助优化问题的求解。FunSearch 方法创新性地提出了一个大模型驱动的算法设计框架,为后续超启发式方法的研究奠定了基础。
此外,还有Liu等人(2024)( [9])的研究,提出了EoH(Evolution of Heuristics),通过大模型实现启发式规则的自动设计。EoH 将大模型和提示工程融入进化计算框架中,通过迭代进化思想,使大模型不断生成启发式思想(High-level Thoughts)和对应的可行代码(Low-level Code)。EoH的性能已在在线装箱问题、旅行商问题(TSP)和车间调度问题中得到验证。以TSP为例,在200节点规模的问题中,EoH 可获得约0.2%的gap。
与 FunSearch 类似,EoH中大模型生成的也是启发式规则,但其查询次数比FunSearch 少了三个数量级。EoH 设计了5个提示策略,分别侧重于探索(广泛搜索启发式空间)和修改(从以往经验中学习并优化)。通过将生成的启发式规则应用于一系列问题(如 TSPLib 中的某类问题),计算适应度函数值并评估整体性能。值得注意的是,FunSearch 仅对代码生成做出了提示,而 EoH 则同时生成了思想和代码,消融实验验证了 High-level Thoughts 的指导有效性。
FunSearch 和 EoH 等方法将大模型纳入进化计算框架,采用生成启发式规则的方式,已在求解组合优化问题时优于直接生成解的 OPRO。然而,在大规模问题的求解中,大模型优化的性能仍不及端到端神经组合优化。研究者发现,尽管提供了上下文演示信息或优化历史,启发式策略的优劣仍然是隐式告知大模型的。受控制系统反馈机制启发,研究者开始尝试引入反馈思想,让大模型生成反馈提示信息,以指导后续策略的生成。
Ye等人(2024)([10])提出的 ReEvo 融入了上述反馈思想,通过 Reflection Evolution 的方式增强了 LHH,使大模型为启发式规则的生成提供了语言梯度(Verbal Gradients),从而提升了其推理能力。ReEvo 继承了遗传编程(Genetic Programming, GP)框架,其优化流程主要包括五个步骤:选择、短期反馈(Short-term Reflections)、交叉、长期反馈(Long-term Reflections)和精英变异。
短期反馈指大模型根据父代启发式规则的相对表现进行反思,并提供改进设计的提示。这一反馈能够为启发式搜索空间提供语言梯度,从而使优化问题的适应度景观(Fitness Landscape)更加平滑。短期反馈会被纳入交叉操作,与问题描述、父代启发式规则及其适应度值等信息一起作为交叉操作的提示。
长期反馈则是指大模型在启发式设计过程中进行的长期思考,通过融合最新的短期反馈和先前的长期反馈,给出总结性的提示。基于长期反馈,大模型将采样生成多个启发式规则,进而优化现有最优解,即精英变异。
从大模型代理架构的角度来看,短期反馈解释了每轮互动中的环境反馈;长期反馈则提炼了积累的经验和知识,并将其融入推理上下文中。
ReEvo 论文中进行了充分的验证试验,以 TSP、CVRP、MKP 等五个经典组合优化问题为例,ReEvo 与 ACO 和 DeepACO(SOTA)进行了对比。在 TSP50、OP50 和 MKP100 等问题中,ReEvo 的表现超过了 DeepACO(端到端神经组合优化的一种),即使后者在测试问题规模上发生了过拟合。论文还观察到,大多数 ReEvo 生成的启发式规则在不同问题规模和数据分布下表现一致。因此,随着数据分布偏移的增加,LHH 相比于神经组合优化的优势将更加明显。
总体而言,使用大模型辅助改进现有智能优化算法是一个取得了较好效果的方向,无论是学术研究还是工业应用,都有望在求解效果和可解释性方面,在端到端框架中取代传统的机器学习模型。
04 基于多个大模型构造的专家系统
在现实中,对一个现实问题的建模,往往需要一系列人类专家参与,这些专家各自具备不同的知识背景并具备优秀的推理能力。由此,是否可以训练多个大语言模型,使其表现类似于人类专家呢?对此,Xiao等人(2024)([11])在 AI 领域顶级会议 ICLR 上的研究提出了“大模型专家”的概念。每个大模型专家负责解决特定的子问题,如解释专业术语、提取变量与约束、构建数学模型、编程、调试修正等。与人类专家团队类似,多个大模型专家可以协作,共同解决一个问题。
该系统的协作流程如图 9 所示。每个“专家”底层由一个大模型支持,专家能够自动化地检索问题相关的知识库,激发大模型在上下文语境中的学习能力,并利用思维链进行推理。那么,专家如何协作呢?该系统引入了一个特殊角色——Conductor,能够智能选择合适的专家进行询问,并将专家的结果放入一个公共评论池,再选择下一个专家。每个专家在推理时,都可以查看公共评论池中的前一个专家的推理结果,从而实现专家之间有序协作,形成链式结构。该系统因此被称为“专家链”。此外,专家链还具备反思能力,系统会根据最终程序的运行结果进行反思。如果程序未能成功运行或建模无效,错误信息将从专家链末端传播至前端,从后向前进行反思,直到找到并修正错误,从而提高建模的成功率。
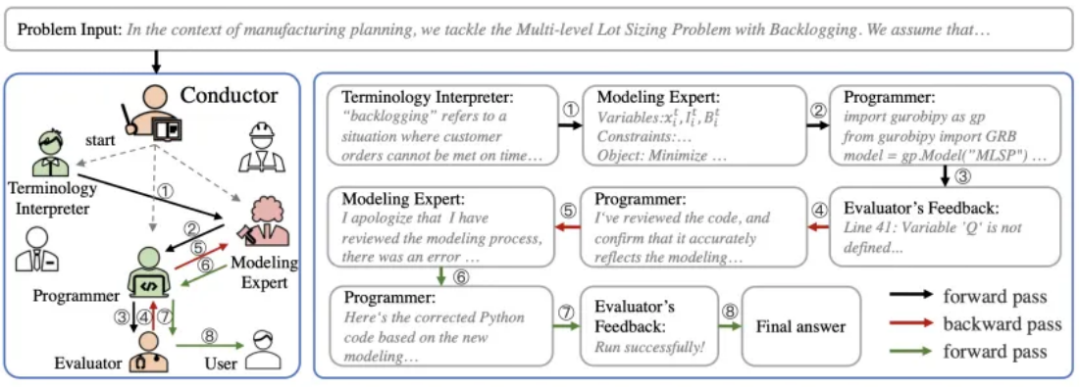
图9 “专家链”系统整体框架
实验证明,“专家链”系统在复杂建模数据集下的效果几乎提高了一倍(从14.6%提升至25.9%)。该数据集包含了37个运筹优化领域的高难度问题,来源于学术研究和实际工业难题。图10展示了“专家链”系统与对比算法在各个难题上的表现。值得注意的是,该方法不仅适用于ChatGPT大模型,还能根据需求替换为不同的基底模型,如LLaMa2 或Claude,具有良好的可移植性。
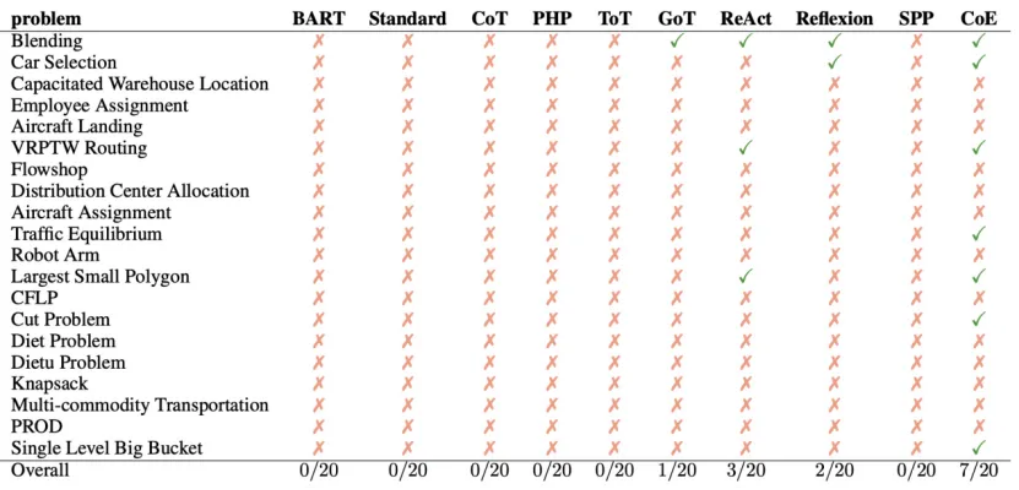
图10 各个对比算法在每个难题上的表现,最右一行是“专家链”系统的表现
总体而言,专家链系统为未来大模型在运筹优化领域的应用开发提供了一个良好的思路。该研究表明,直接利用通用大模型解决优化问题,可能导致“每个环节都不精,整体效果更不好”的局面。相比之下,采用类似人类专家团队决策的思路,通过构建多个专门化的小模型,并由一个协调者进行有效管理,可以充分发挥各个小模型的特长,从而实现更高效、更精确的整体效果。
05 总结
本文回顾了大模型在运筹优化领域的多条探索路径。从当前研究来看,大模型的应用主要集中在两个方向:一是利用大语言模型的自然语言理解与知识表达能力,实现问题的自动抽象和数学建模;二是融合大模型与传统优化算法,推动决策求解与策略优化。这些探索在突破传统方法局限、提升求解效率以及改善模型解释性方面均已取得显著进展,但数学严谨性、数据依赖、模型泛化以及“黑箱”问题仍亟待解决,反映出了理论与实践间的明显差距。因此,本文提出了对大模型与运筹优化结合的未来发展趋势的几点思考:
-
未来大模型与运筹优化的深度融合将催生由多个专业化小模型协同构成的复杂智能体,乃至形成完整的智能生态系统。近年来的实践经验和“专家链”系统探索表明,通用大模型在应对具体复杂任务时存在局限。未来的系统将根据任务逻辑拆分为若干子系统,每个子系统由专门训练的小模型承担特定功能。类似于现有APP通过调用多个API完成任务,未来的系统可同时调动精确建模与求解、启发式建模与求解等多种API,并由“领导”模型实时评估各模块表现,最终输出综合最优方案。这样的系统将集成精确求解、启发式优化、代码生成与核查等多项功能,逐步演化为一个功能完备、任务多样的运筹优化问题解决生态系统。
-
应注重培养大模型调用现有工具完成任务的能力,而非直接让其承担任务。尽管大模型在各类任务上展现出良好的能力,但其本质仍是基于概率输出的语言模型,擅长于理解语言信息而非数学推导或求解等任务。对于那些已有专业软件能够高效完成的单一维度任务,大模型并不需要耗费大量资源来追赶。相反,应注重训练大模型有效利用现有专业软件来解决问题。这包括自动整理输入数据、指导专业软件执行任务,并自动评估结果以决定调整执行参数、重新执行,或直接整理并输出结果。以上可能需要修改专业软件的底层代码,或是增加转换层,以确保两者能够共享相同的推理框架或逻辑规则
-
可以集成形式化验证工具如 Lean 4 来辅助验证其数学推导的正确性,特别是在复杂规划模型的等价转化过程中。这一方法能够直接确保大模型在数学推理上的严格准确性。当大语言模型生成数学解答时,其输出可被传递至 Lean 4 等形式化验证工具,通过自动化定理验证与推导过程检查,确保推导结果符合数学标准。此自动化验证步骤大大提升了大模型在运筹优化中的解题精度,确保结果的严谨性与正确性。
最后,作为一个未来的运筹优化算法工程师,在面对大模型来势汹汹的潜在冲击时,尽管内心充满焦虑与担忧,但也要客观性地看待大模型能对推动运筹优化在国内进一步落地的潜在贡献和其本身存在的不足。目前来看,大模型在抽象建模方面的能力仅相当于一个在读硕士生,还远远未达到取代传统运筹优化算法工程师的地步。其日后发挥的作用最有可能会和现今的开发岗位类似,作为一种效率提升的辅助工具和快速上手新领域知识的好老师。
然而,也不要因此妄下定论固步自封,从而被时代抛弃。毕竟数年前还在依赖LSTM模型做自然语言处理时,谁也无法想到今日大模型表现出的一统江湖的强悍能力。运筹优化在国内本就是相对小众的领域,大多数制造业对其重视程度不高。如果大模型的出现能够降低运筹优化的开发门槛,使得越来越多的企业更加重视生产要素的匹配效能,那么这无疑将拓宽运筹优化的需求空间,社会对运筹优化算法工程师的需求也会越来越旺盛。因此,我们能做的就是积极拥抱新知识,保持终身学习的态度,力求成为冲击浪潮上的弄潮儿,这样才能在瞬息万变的市场环境中,持续保持竞争力,迎接新的机遇与挑战。
参考文献:
[1]. 智能决策大模型ORLM的研发与商业应用落地, https://mp.weixin.qq.com/s/GHFgEmrBg-G49JGJU0sGXA
[2]. 当大模型遇上运筹优化:一句话就能自动建模的「专家链」系统, https://mp.weixin.qq.com/s/UMFmTYCtCCfNTKsqyOTvEQ
[3]. 杉数发布首个开源运筹学大模型ORLM,效果超越GPT-4, https://mp.weixin.qq.com/s/1NyjyBNtKbTxpK_VdmFydw
[4]. Qi, M., Shi, Y., Qi, Y., Ma, C., Yuan, R., Wu, D., \& Shen, Z. J. (2023). A practical end-to-end inventory management model with deep learning. Management Science, 69(2), 759-773.
[5]. C. Yang, X. Wang, Y. Lu, H. Liu, Q. V. Le, D. Zhou, and. X. Chen, “Large language models as optimizers,” arXiv preprint arXiv: 2309.03409, 2023.
[6]. Jiao, Z., Sha, M., Zhang, H., Jiang, X., \& Qi, W. (2024). City-LEO: Toward Transparent City Management Using LLM with End-to-End Optimization. arXiv preprint arXiv:2406.10958.
[7]. Liu S, Chen C, Qu X, Tang K, Ong YS. Large language models as evolutionary optimizers. In 2024 IEEE Congress on Evolutionary Computation (CEC) 2024 Jun 30 (pp. 1-8). IEEE.
[8]. Romera-Paredes B, Barekatain M, Novikov A, Balog M, Kumar MP, Dupont E, Ruiz FJ, Ellenberg JS, Wang P, Fawzi O, Kohli P. Mathematical discoveries from program search with large language models. Nature. 2024 Jan 18;625(7995):468-75.
[9]. Liu F, Xialiang T, Yuan M, et al. Evolution of Heuristics: Towards Efficient Automatic Algorithm Design Using Large Language Model. Forty-first International Conference on Machine Learning. 2024.
[10]. Ye H, Wang J, Cao Z, et al. Reevo: Large language models as hyper-heuristics with reflective evolution. arXiv preprint arXiv:2402.01145, 2024.
[11]. Xiao, Z., Zhang, D., Wu, Y., Xu, L., Wang, Y. J., Han, X., ... \& Chen, G. (2023). Chain-of-experts: When llms meet complex operations research problems. In The twelfth international conference on learning representations.
15. 基于平均场博弈的跨时空调度方案(2026.3.6)
本文探讨了如何利用平均场博弈(MFG)理论解决大规模智能体在跨时空调度中的复杂决策挑战。传统方法在面对海量资源分配时常遭遇维度灾难和利益冲突,而平衡场博弈通过将个体间的交互简化为个体与群体平均状态的互动,显著提升了计算效率。
文中重点介绍了两个应用案例:一是JDRCL框架,它在网约车调度中平衡了平台效率与司机公平性;二是EMFRL方案,通过宏观基本图实现城市路网的非合作边界协同控制。这些模型利用哈密顿-雅可比-贝尔曼方程与Fokker-Planck方程的耦合,证明了分布式决策也能达到类中心化控制的稳定状态。总而言之,平均场博弈为处理物流、交通等大数据场景下的宏观演化与微观优化提供了坚实的数学框架。
一、平均场博弈
平均场博弈(Mean Field Game, MFG)是研究海量微小智能体(参与者)在竞争或动态环境下战略决策的数学与博弈论理论,结合了博弈论、随机分析和最优控制理论。在平均场博弈中,平均场借用了物理学中的概念,意味着在庞大的群体中,单个智能体的行为对整个系统的影响微乎其微。因此,每个智能体在决策时,不再单独针对其他每一个个体的行为作出反应,而是根据种群的整体状态概率分布(即“平均场”)来进行优化决策。在连续时间模型中,它通常由描述个体最优控制的哈密顿-雅可比-贝尔曼方程和描述群体聚合分布动态的Fokker-Planck方程耦合构成。
传统的多智能体模型或经典博弈论在处理大规模群体时,会面临“维度灾难”和指数级增长的计算复杂性,因为精确描述每一对个体之间的相互作用在数学和计算上都是不现实的。平均场博弈论专门用于解决含有海量交互智能体的复杂系统中的纳什均衡求解问题,将复杂的多体交互问题近似转化为个体与群体平均状态交互的单体问题。其优势主要有以下几点:
-
**计算降维与高效性: **通过将复杂的个体间相互作用转化为对整体平均场的响应,MFG极大地降低了系统模拟和策略求解的计算成本,使得在交通、金融等大数据场景下进行宏观模拟成为可能。
-
**兼顾微观决策与宏观演化: **相比于纯粹的物理学动力学模型,MFG不仅能描述群体状态的演变,还能解释个体是如何基于对未来的预期(理性预期)去主动优化自身策略的,具有更强的解释力。
-
易于与机器学习结合: MFG可以为多智能体强化学习(MARL)提供严格的理论框架,通过引入平均场动作(如MF-Q算法),能够有效突破经典多智能体强化学习在智能体数量增加时的计算瓶颈。
二、跨时空调度问题
跨时空调度是指在具有显著空间分布和时间演变特征的动态系统中,对海量资源(如网约车、城市交通流、物流配送等)进行分配和引导的过程。它不仅关注当下的资源匹配,更强调通过前瞻性的调度(如网约车的空车调度或交通边界的流量控制),以优化整个系统的长期运行状态。
该类问题的常规解决方案通常是基于传统优化方法(线性规划、排队论等)、启发式算法(模拟退火、邻域搜索、遗传算法等)或强化学习算法(DQN、A2C等)来求解。然而,传统解决方案通常存在以下难点:
-
状态与动作空间的指数级爆炸: 在真实的跨时空调度场景中(如成千上万的网约车司机或复杂的城市路网),如果采用中心化决策器为所有个体进行全局统筹,其状态空间和动作空间会随着个体数量呈指数级膨胀,面临严重的“单点故障”风险和不可计算性。
-
**深度的时空耦合效应: **调度决策不仅决定当下的收益,还会深刻改变资源的未来空间分布,进而影响未来的匹配潜力和效率。例如,将网约车派往某地完成订单,改变了司机的地理位置,直接决定了其未来的接单概率。
-
多目标冲突(效率与公平难以兼顾): 调度系统往往需要同时优化整体“效率”(如平台的总交易额GMV、路网总通行量)和个体“公平”(如保证最弱势司机的收入底线)。然而,这两者往往存在内在冲突,只关注效率极易导致部分个体被边缘化,损害系统的长期可持续性。
-
**动态变化的动作空间: **智能体在不同时间和空间下可执行的动作是动态变化的(例如网约车司机在不同网格面临的可用订单集合实时都在变化),这给算法的神经网络设计和特征表示带来了极大挑战。
-
**异构主体的非合作博弈: **跨区域的调度(如城市交通边界控制)往往涉及不同利益相关者(如不同区域的管理者、内部停车场等)。他们缺乏集中通信,目标不一致,各自为政容易陷入对系统不利的双输局面。
三、基于平均场博弈的跨时空调度应用方案
3.1 网约车平台联合派单与空车调度(基于 JDRCL 框架)
在网约车系统中,调度不仅决定当前的订单匹配(即时收益),还会改变司机的空间分布(未来收益潜力),传统的效率优先算法往往会导致部分司机收入过低。为此,研究者提出了一种受约束的多目标马尔可夫博弈(CMOMG)框架——JDRCL(Joint Order Dispatching and Driver Repositioning with Constrained MARL),在调度成本预算的约束下,联合优化长期的系统总订单量(效率)和最大最小公平性(公平)。
3.1.1 问题建模与目标函数:
将每一位司机视作一个独立的智能体。该框架包含两个优化目标:一个是代表平台效率的总体期望累积收益(GMV),另一个是代表公平性的所有司机中最差的期望累积收益(Max-min Fairness)。平台预设了总调度成本(如空车调度的补贴)的预算约束B。
问题的核心目标函数被公式化为受约束的最大最小优化问题:
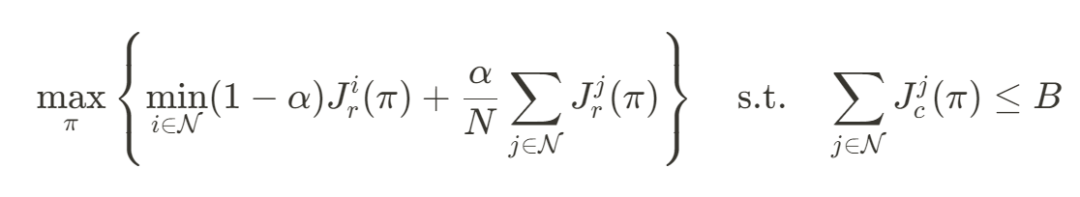
其中:
-
$J_r^i(\pi)$表示在联合策略 $\pi$ 下,智能体$i$的长期期望累积收益。
-
$J_c^j(\pi)$表示智能体$j$的长期期望累积调度成本。
-
$\alpha$是平衡效率与公平性的调节系数。
3.1.2 拉格朗日对偶转换:
由于直接求解带有约束的最大最小问题极其困难,JDRCL 利用拉格朗日乘子法,将原问题转化为拉格朗日最大最小无约束问题:
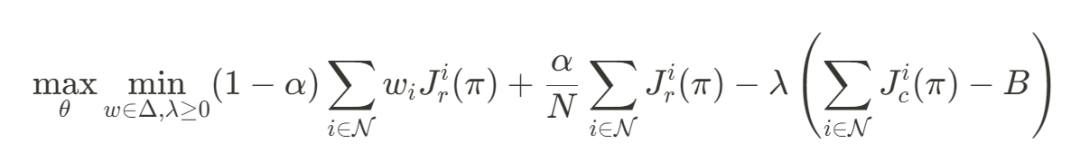
其中,θ是策略网络的参数(主变量),ω∈Δ是用于拟合最小化项的权重向量,λ是处理成本预算约束的非负对偶变量。
3.1.3 核心更新算法与推导:
算法采用原始-对偶迭代训练(Primal-Dual Iterative Training),交替更新策略参数θ和对偶变量λ。
- 策略(Actor)参数更新:利用随机梯度上升最大化目标函数。其梯度的样本估计公式推导为:
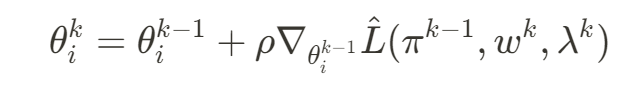
根据策略梯度定理,其核心梯度估计公式展开为:
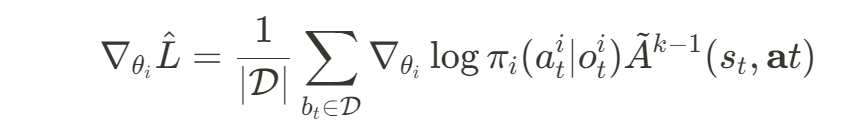
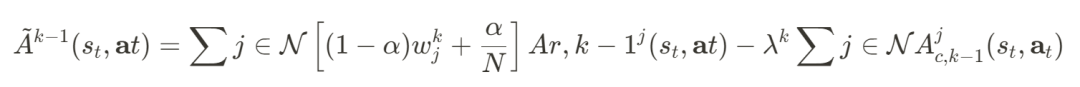
在这里,在这里,A_r^j和A_c^j分别是收益和成本的优势函数(Advantage function)。这一推导的物理意义是:智能体会倾向于增加那些不仅能提高全局整体收益和最弱势司机收益,同时又能降低系统整体调度成本的动作概率。
- 对偶变量更新:通过投影梯度下降法来惩罚超出预算的部分:
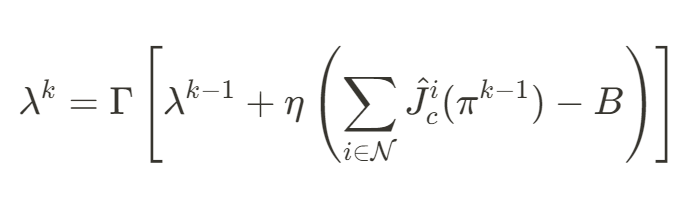
3.1.4 动作空间降维:
由于司机在不同时间、地点面临的候选订单池是实时变化的,这导致动作空间极其庞大且动态可变。为了解决这个问题,JDRCL 按目的地网格对订单进行聚类分组,将策略网络的输出维度固定为有限的网格类别(如G+9维,即G个候选订单目的网格与9个巡游邻近网格)。这种降维使得 Actor 网络每次只需进行一次前向传播即可高效完成最优动作的选择。
3.2 城市路网非合作边界协同控制(基于 EMFRL 方案)
在城市交通调度中,如果将一个区域的跨界交叉路口(边界控制单元)和内部停车场等视为不同的利益相关者,它们之间往往缺乏集中的通信和物理连接,且有着相互独立的决策目标。为了避免各主体由于利益不一致而陷入双输的局面,研究者提出了扩展平均场强化学习(EMFRL)方法来进行非合作边界控制。
3.2.1 引入宏观基本图作为平均场:
传统基于细胞传输模型(CTM)的方法需要一个中央管理者控制所有的流率。EMFRL 放弃了这一中心化假设,转而在CTM模型中引入了描述区域路网整体运行状态的宏观基本图(MFD)概念,MFD 所反映出的边界总流率与路网车辆密度的关系,被作为平均场论中平均动作(Mean-field Action)的雏形。各智能体仅需感知路网整体反应出的边界流率这一宏观状态,即可做出局部最优的决策。
3.2.2 核心机制与 FP-HJB 方程系统:
寻找非合作博弈中的纳什均衡点,其本质上被转化为求解每个智能体的贝尔曼方程(Bellman Equation)。在连续时间与状态的平均场博弈理论框架下,这一分布式的微观决策与宏观演化过程,由著名的 Fokker-Planck (FP) 方程和 Hamilton-Jacobi-Bellman (HJB) 方程耦合构成的系统来数学化描述:
- 个体决策最优化的 HJB 方程(逆向演化):每个局部交通控制单元(智能体)的目标是基于对未来的拥堵预期使自身效用最大化,其价值函数u(x, t)满足:
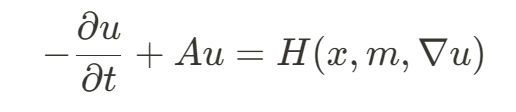
其中,A为扩散算子,H为哈密顿量,它代表了控制单元在给定的路网车辆密度分布m(平均场)下,计算出的最优交通流调节策略(反馈控制)。
- 路网宏观状态演化的 Fokker-Planck 方程(正向演化):当所有分散的控制单元都依据各自的HJB方程执行边界控制策略时,路网中整体交通流的密度分布m(x, t)的演变由连续性方程主导:
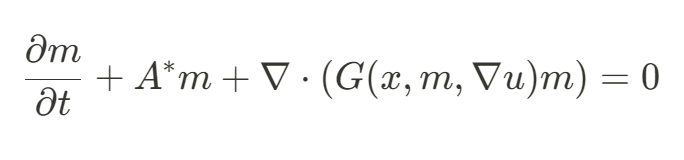
这里,G(x, m, \nabla u)反映了在最优控制场作用下的流量漂移项(宏观流率)。这套方程组在数学上严格证明了:即使缺乏中央管理者,只要智能体遵循对平均场m 的最优响应,系统也能收敛到与中心化控制表现相近的稳定宏观状态。
3.2.3 平均场动作预测器与特异性表达:
-
MFAP 的引入:在多智能体强化学习中,由于各主体的策略都在不断更新,当前的平均场动作与未来的平均场动作是不稳定的。研究设计了平均场动作预测器(MFAP),以上一时刻的平均场动作和环境信息为输入,采用监督回归预测当前时刻的平均场动作。MFAP 会随着智能体策略逼近纳什均衡而同步收敛。
-
值分解网络(VDN)与置信分配:为了减少在采用 EMFRL 进行平均场近似时产生的误差,模型在策略神经网络中引入了 VDN 结构,增强了同一组智能体之间的特异性表达,允许不同交叉路口和内部节点学习到分化的子策略,实现无通信的隐式协作。
四、SaaS
(一)TSP(单车版路径规划)接口服务(2025.2.10)
云服务
版本日期:01/16/2025
本程序包含一个接口
任务提交:http://localhost:[端⼝]/process
-
所有请求⽅式均为POST,格式均为JSON
-
具体调用方式为,通过process上传任务,等待若干分钟后(可指定最大运行时间)返回运⾏结果
-
每次process只能上传⼀个调度
目录
-
1.1 格式(快速上手样例)
-
(1)传入参数
-
(2)传出参数
-
-
1.2 接口说明
-
(1)传入参数
-
(2)传出参数
-
1.1 格式(快速上手样例)
(1)传入参数
JSON
{
    "config": {
        "CALCULATION_TIME": 5
    },
    "depot": {
        "address": "上海市杨浦区毕升路99号",
        "addressNo": "ADDR000",
        "lonLat": "121.47390,31.22805"
    },
    "orders":[
        {
            "orderNo": "PO001",
            "address": "上海市杨浦区邯郸路某某号",
            "addressNo": "ADDR001",
            "lonLat": "121.50389,31.29665"
        }
    ],
}
(2)传出参数
JSON
{
    "code": 0,
    "results": [
            {
                "seq": 1,
                "lonLat": "121.50389,31.29665",
                "addressNo": "ADRR001",
                "orderNo": "PO001",
                "distance": 6.1
            }
    ]
}
1.2 接口说明
(1)传入参数
参数名 含义
类型举例 默认值 是否必须 config 可选配置字段 object - - 否 CALCULATION_TIME 最大计算时间(分钟),限制实际运行时间小于等于该值 int 5 12 否
depot物流中心。现行程序将只使用第一个物流中心,其余物流中心将被忽略。 object - - 是 deName 仓库名称 string 上海绥德物流中心 无 是 address 地点名称 string 毕生路99号 无 是 addressNo 地址编号 string ADDR002 无 是 lonLat 地址:经度(东经为正,西经为负)-纬度(北纬为正-南纬为负) string 121.47390,31.22805 无 是 orders 订单表 array[object] - - 是 orderNo 订单号 string PO001 无 是 address 地点名称 string 花园路1号 无 是 addressNo 地点编号 string ADDR002 无 是 lonLat 订单目的地:经度(东经为正,西经为负)-纬度(北纬为正-南纬为负) string 121.47390,31.22805 无 是 (2)传出参数
含义 类型 举例 code WIP状态码0:成功;1:未发现调度记录;2:其他内部错误;3:未发现调度记录 int 0 result 运行结果,若报错则为null - - orderNo 订单号 string PO001 seq 顺序号(同一个收货客户的订单,顺序号相同) int 1 lonLat 经纬度 string 121.50389,31.29665 addressNo 地址编号 string ADDR002 distance 从上一个点到当前点的行驶距离(km) float 6.1 -
本地部署
版本日期:01/16/2025
本程序包含两个接口
任务提交:http://localhost:[端⼝]/submit
结果获取:http://localhost:[端⼝]/fetch
-
所有请求⽅式均为POST,格式均为JSON
-
具体调用方式为,通过submit上传任务,等待若干分钟后(可指定最大运行时间)执⾏fetch获取运⾏结果
-
每次submit和fetch只能上传⼀个调度,即⼀个dispatchId
目录
-
2.1 格式(快速上手样例)
-
(1)任务递交(submit)
-
传入参数
-
传出参数
-
-
(2)获取结果(fetch)
-
传入参数
-
传出参数
-
-
-
2.2 接口说明
-
(1)任务递交(submit)
-
传入参数
-
传出参数
-
-
(2)获取结果(fetch)
-
传入参数
-
传出参数
-
-
2.1 格式(快速上手样例)
(1)任务递交(submit)
地址:http://localhost:[端⼝]/submit
方法:POST
- 传入参数
{
    "dispatchId": "DIS0001",
    "config": {
        "CALCULATION_TIME": 5
    },
    "depot": {
        "address": "上海市杨浦区毕升路99号",
        "addressNo": "ADDR000",
        "lonLat": "121.47390,31.22805"
    },
    "orders":[
        {
            "orderNo": "PO001",
            "address": "上海市杨浦区邯郸路某某号",
            "addressNo": "ADDR001",
            "lonLat": "121.50389,31.29665"
        }
    ],
}
- 传出参数
{
    "success": true,
    "code": 10000,
    "msg": "Succeed!"
}
(2)获取结果(fetch)
地址:http://localhost:[端⼝]/fetch
方法:POST
- 传入参数
{
    "dispatchId": "DIS0001"
}
- 传出参数
"code": 0,
"results": {
    "dispatchId": "DIS0001",
    "dispatch": [
        {
            "seq": 1,
            "lonLat": "121.50389,31.29665",
            "addressNo": "ADRR001",
            "orderNo": "PO001",
            "distance": 6.1,
        }
    ]
}
2.2 接口说明
(1)任务递交(submit)
地址:http://localhost:[端⼝]/submit
⽅法:POST
- 传入参数
| 参数名 | 含义 | 类型 |
举例 | 默认值 | 是否必须 | |
|---|---|---|---|---|---|---|
| dispatchId | 调度记录ID,调度唯⼀识别符号 | string | DIS0001 | 无 | 是 | |
| config | 可选配置字段 | array[object] | - | - | 否 | |
| CALCULATION_TIME | 最大计算时间(分钟),限制实际运行时间小于等于该值 | int | 5 | 12 | 否 | |
depot |
物流中心。现行程序将只使用第一个物流中心,其余物流中心将被忽略。 | array[object] | - | - | 是 | |
| deName | 仓库名称 | string | 上海绥德物流中心 | 无 | 是 | |
| address | 地点名称 | string | 毕生路99号 | 无 | 是 | |
| addressNo | 地址编号 | string | ADDR002 | 无 | 是 | |
| lonLat | 地址:经度(东经为正,西经为负)-纬度(北纬为正-南纬为负) | string | 121.47390,31.22805 | 无 | 是 | |
| orders | 订单表 | array[object] | - | - | 是 | |
| orderNo | 订单号 | string | PO001 | 无 | 是 | |
| address | 地点名称 | string | 花园路1号 | 无 | 是 | |
| addressNo | 地点编号 | string | ADDR002 | 无 | 是 | |
| lonLat | 订单目的地:经度(东经为正,西经为负)-纬度(北纬为正-南纬为负) | string | 121.47390,31.22805 | 无 | 是 |
- 传出参数
| 参数名 | 含义 | 类型 | 举例 |
|---|---|---|---|
| success | 是否提交成功 | bool | true |
| code | WIP状态码0:成功;1:还未运行完成;2:其他内部错误 | int | 10000 |
| msg | 返回错误,如果错误返回错误信息 | string | Succeed! |
(2)获取结果(fetch)
地址:http://localhost:[端⼝]/fetch
⽅法:POST
- 传入参数
| 参数名 | 含义 | 类型 | 举例 |
|---|---|---|---|
| dispatchId | 需要获取的调度记录 | string | DIS0001 |
- 传出参数
| 参数名 | 含义 | 类型 | 举例 | ||
|---|---|---|---|---|---|
| code | WIP状态码0:成功;1:未发现调度记录;2:其他内部错误;3:未发现调度记录 | int | 0 | ||
| result | 运行结果,若报错则为null | - | - | ||
| dispatchId | 调度ID | string | DIS0001 | ||
| dispatch | 调度结果 | array[object] | - | ||
| orderNo | 订单号 | string | PO001 | ||
| seq | 顺序号(同一个收货客户的订单,顺序号相同) | int | 1 | ||
| lonLat | 经纬度 | string | 121.50389,31.29665 | ||
| addressNo | 地址编号 | string | ADDR002 | ||
| distance | 从上一个点到当前点的行驶距离(km) | float | 6.1 |
(二)VRP(多车版路径规划)接口服务(2025.2.10)
云服务
版本日期:01/16/2025
本程序包含一个接口
任务提交:http://localhost:[端⼝]/process
-
请求⽅式为POST,格式为JSON
-
具体调用方式为,通过process上传任务,等待若干分钟后(可指定最大运行时间)返回运⾏结果
-
每次process只能上传⼀个调度
目录
-
1.1 格式(快速上手样例)
-
(1)传入参数
-
(2)传出参数
-
-
1.2 接口说明
-
(1)传入参数
-
(2)传出参数
-
1.1 格式(快速上手样例)
(1)传入参数
{
    "config": {
        "STAY_MINUTE": 8.0,
        "LOADING_SPEED": 1.5,
        "SPEED": 50.0,
        "CALCULATION_TIME": 5.0
        "RETURN_FLAG": false
    },
    "depots": [
        {
            "deCode": "WH01",
            "deName": "张江物流中⼼",
            "province": "上海市",
            "city": "上海市",
            "district": "浦东新区",
            "address": "毕升路99号",
            "addressNo": "ADDR000"
        }
    ],
    "orders":[
        {
            "orderNo": "PO001",
            "DC": "WH01",
            "address": "上海市杨浦区邯郸路某某号",
            "addressNo": "ADDR001",
            "timeWindow": "06:00-09:00",
            "lonLat": "121.50389,31.29665"
        }
    ],
    "vehicles": [
        {
            "vehicleId": "沪B-E7468",
            "maxVolume": 36.0
            "maxWeight": 36.0
            "mileageCost": 10.0,
            "departureTime": "06:00"
        }
    ]
}
(2)传出参数
{
    "code": 0,
    "results":  [
        {
            "vehicleId": "沪A00000",
            "seq": 1,
            "lonLat": "121.50389,31.29665",
            "addressNo": "ADRR001",
            "orderNo": "PO001",
            "eta": "09:35",
            "etd": "09:48",
            "distance": 6.1,
        }
    ]
}
1.2 接口说明
(1)传入参数
| 参数名 | 含义 | 类型 |
举例 | 默认值 | 是否必须 | |
|---|---|---|---|---|---|---|
| config | 可选配置字段 | object | - | - | 是 | |
| STAY_MINUTE | 最少停留时间(分钟) | float | 8.0 | 30.0 | 是 | |
| LOADING_SPEED | 车辆装卸货速度(货量/分钟) | float | 1.5 | 1.0 | 是 | |
| SPEED | 车速(km/h) | float | 50.0 | 50.0 | 是 | |
| CALCULATION_TIME | 最大计算时间(分钟),限制实际运行时间小于等于该值 | int | 5 | 12 | 否 | |
| RETURN_FLAG | 车辆是否返厂 | bool | true | false | 是 | |
depot |
物流中心 | object | - | - | 是 | |
| deCode | 物流中心代码 | string | WH01 | 无 | 是 | |
| deName | 物流中心名称 | string | 张江物流中心 | 无 | 是 | |
| province | 省份 | string | 上海市 | 无 | 是 | |
| city | 城市 | string | 上海市 | 无 | 是 | |
| district | 区县 | string | 浦东新区 | 无 | 是 | |
| address | 地点名称 | string | 毕生路99号 | 无 | 是 | |
| addressNo | 地址编号 | string | ADDR002 | 无 | 是 | |
| lonLat | 地址:经度(东经为正,西经为负)-纬度(北纬为正-南纬为负) | string | 121.47390,31.22805 | 无 | 是 | |
| orders | 订单表 | array[object] | - | - | 是 | |
| orderNo | 订单号 | string | PO001 | 无 | 是 | |
| address | 地点名称 | string | 花园路1号 | 无 | 是 | |
| addressNo | 地点编号 | string | ADDR002 | 无 | 是 | |
| DC | 配送中心ID | string | WH01 | 无 | 是 | |
| lonLat | 订单目的地:经度(东经为正,西经为负)-纬度(北纬为正-南纬为负) | string | 121.47390,31.22805 | 无 | 是 | |
| timeWindow | 时间窗:最早送货时间-最晚送货时间,空字符串代表不限制 | string | 06:00-08:00 | "" | 否 | |
| cubic | 货物体积,0代表未知,-1为不使用该限制 | float | 1.0 | -1 | 否 | |
| weight | 货物重量,0代表未知,-1为不使用该限制 | float | 1.0 | -1 | 否 | |
| vehicles | 车辆表 | array[object] | - | - | 是 | |
| vehicleId | 车辆标识符 | string | 沪B-E7468 | 无 | 是 | |
| mileageCost | 每公里成本:/km | float | 10.0 | 无 | 是 | |
| maxVolume | 最大装载体积,0代表未知,-1为不使用该限制 | float | 36.0 | -1 | 否 | |
| maxWeight | 最大装载重量,0代表未知,-1为不使用该限制 | float | 36.0 | -1 | 否 | |
| departureTime | 出发时间,空字符串代表出发时间为"0:00" | string | 02:00 | "" | 否 |
(2)传出参数
| 含义 | 类型 | 举例 | ||
|---|---|---|---|---|
| code | WIP状态码0:成功;1:还未运行完成;2:无可行解;3:其他内部错误 | int | 0 | |
| result | 运行结果,若报错则为null | array[object] | - | |
| vehicleId | 车辆标识符 | string | 沪B-E7468 | |
| orderNo | 订单号 | string | PO001 | |
| seq | 顺序号(同一个收货客户的订单,顺序号相同) | int | 1 | |
| lonLat | 经纬度 | string | 121.50389,31.29665 | |
| addressNo | 地址编号 | string | ADDR002 | |
| eta | 预计到达时间 | string | 09:35 | |
| etd | 预计离开时间 | string | 09:48 | |
| distance | 从上一个点到当前点的行驶距离(km) | float | 6.1 |
本地部署
版本日期:01/16/2025
本程序包含两个接口
任务提交:http://localhost:[端⼝]/submit
结果获取:http://localhost:[端⼝]/fetch
-
所有请求⽅式均为POST,格式均为JSON
-
具体调用方式为,通过submit上传任务,等待若干分钟后(可指定最大运行时间)执⾏fetch获取运⾏结果
-
每次submit和fetch只能上传⼀个调度,即⼀个dispatchID
目录
-
2.1 格式(快速上手样例)
-
(1)任务递交(submit)
-
传入参数
-
传出参数
-
-
(2)获取结果(fetch)
-
传入参数
-
传出参数
-
-
-
2.2 接口说明
-
(1)任务递交(submit)
-
传入参数
-
传出参数
-
-
(2)获取结果(fetch)
-
传入参数
-
传出参数
-
-
2.1 格式(快速上手样例)
(1)任务递交(submit)
地址:http://localhost:[端⼝]/submit
方法:POST
- 传入参数
{
    "dispatchId": "DIS0001",
    "config": {
        "STAY_MINUTE": 8.0,
        "LOADING_SPEED": 1.5,
        "SPEED": 50.0,
        "CALCULATION_TIME": 5.0
    },
    "depots": [
        {
            "deCode": "WH01",
            "deName": "张江物流中⼼",
            "province": "上海市",
            "city": "上海市",
            "district": "浦东新区",
            "address": "毕升路99号",
            "addressNo": "ADDR000"
        }
    ],
    "dispatchZones":"DISZONE001",
    "orders":[
        {
            "dispatchZoneCode": "DIS0001",
            "orderNo": "PO001",
            "DC": "WH01",
            "address": "上海市杨浦区邯郸路某某号",
            "addressNo": "ADDR001",
            "timeWindow": "06:00-09:00",
            "lonLat": "121.50389,31.29665"
        }
    ],
    "vehicles": [
        {
            "dispatchZoneCode": "DIS0001",
            "vehicleId": "沪B-E7468",
            "maxVolume": 36.0
            "maxWeight": 36.0
            "mileageCost": 10.0,
            "departureTime": "06:00"
            "returnFlag": false
        }
    ]
}
- 传出参数
{
    "success": true,
    "code": 10000,
    "msg": "Succeed!"
}
(2)获取结果(fetch)
地址:http://localhost:[端⼝]/fetch
方法:POST
- 传入参数
{
    "dispatchId": "DIS0001"
}
- 传出参数
"code": 0,
"results": {
    "dispatchId": "DIS0001",
    "dispatch": [
        {
            "dispachZoneCode": "DISZONE001",
            "vehicleId": "沪A00000",
            "seq": 1,
            "lonLat": "121.50389,31.29665",
            "addressNo": "ADRR001",
            "orderNo": "PO001",
            "eta": "09:35",
            "etd": "09:48",
            "distance": 6.1,
        }
    ]
}
2.2 接口说明
(1)任务递交(submit)
地址:http://localhost:[端⼝]/submit
⽅法:POST
- 传入参数
| 参数名 | 含义 | 类型 |
举例 | 默认值 | 是否必须 | |
|---|---|---|---|---|---|---|
| dispatchID | 调度记录ID,调度唯⼀识别符号 | string | DIS0001 | 无 | 是 | |
| config | 可选配置字段 | array[object] | - | - | 否 | |
| STAY_MINUTE | 最少停留时间(分钟) | float | 8.0 | 30.0 | 否 | |
| LOADING_SPEED | 车辆装卸货速度(货量/分钟) | float | 1.5 | 1.0 | 否 | |
| SPEED | 车速(km/h) | float | 50.0 | 50.0 | 否 | |
| CALCULATION_TIME | 最大计算时间(分钟),限制实际运行时间小于等于该值 | int | 5 | 12 | 否 | |
depots |
物流中心。现行程序将只使用第一个物流中心,其余物流中心将被忽略。 | array[object] | - | - | 是 | |
| deCode | 物流中心代码 | string | WH01 | 无 | 是 | |
| deName | 物流中心名称 | string | 张江物流中心 | 无 | 是 | |
| province | 省份 | string | 上海市 | 无 | 是 | |
| city | 城市 | string | 上海市 | 无 | 是 | |
| district | 区县 | string | 浦东新区 | 无 | 是 | |
| address | 地点名称 | string | 毕生路99号 | 无 | 是 | |
| addressNo | 地址编号 | string | ADDR002 | 无 | 是 | |
| lonLat | 地址:经度(东经为正,西经为负)-纬度(北纬为正-南纬为负) | string | 121.47390,31.22805 | 无 | 是 | |
| dispatchZone | 分区编号 | string | DISZONE001 | 无 | 是 | |
| orders | 订单表 | array[object] | - | - | 是 | |
| dispatchZoneCode | 分区编号 | string | DISZONE001 | 无 | 是 | |
| orderNo | 订单号 | string | PO001 | 无 | 是 | |
| address | 地点名称 | string | 花园路1号 | 无 | 是 | |
| addressNo | 地点编号 | string | ADDR002 | 无 | 是 | |
| DC | 配送中心ID | string | WH01 | 无 | 是 | |
| lonLat | 订单目的地:经度(东经为正,西经为负)-纬度(北纬为正-南纬为负) | string | 121.47390,31.22805 | 无 | 是 | |
| timeWindow | 时间窗:最早送货时间-最晚送货时间,空字符串代表不限制 | string | 06:00-08:00 | "" | 否 | |
| cubic | 货物体积,0代表未知,-1为不使用该限制 | float |
D | D | 否 | |
| weight | 货物重量,0代表未知,-1为不使用该限制 | float |
1 | -1 | 否 | |
| vehicles | 车辆表 | array[object] | - | - | 是 | |
| dispatchZoneCode | 分区编号 | string | DISZONE001 | 无 | 是 | |
| vehicleID | 车辆标识符 | string | 沪B-E7468 | 无 | 是 | |
| mileageCost | 每公里成本:/km | float | 10.0 | 无 | 是 | |
| maxVolume | 最大装载体积,0代表未知,-1为不使用该限制 | float | 36.0 | -1 | 否 | |
| maxWeight | 最大装载重量,0代表未知,-1为不使用该限制 | float | 36.0 | -1 | 否 | |
| departureTime | 出发时间,空字符串代表出发时间为"0:00" | string | 02:00 | 00:00 | 否 | |
| returnFlag | 车辆是否回场 | bool | false | false | 否 |
- 传出参数
| 参数名 | 含义 | 类型 | 举例 |
|---|---|---|---|
| success | 是否提交成功 | bool | true |
| code | WIP状态码(10000)成功;(1001)参数错误;(1002)代码错误;(1003)运行异常;(1004)校验错误 | int | 10000 |
| msg | 返回错误,如果错误返回错误信息 | string | Succeed! |
(2)获取结果(fetch)
地址:http://localhost:[端⼝]/fetch
⽅法:POST
- 传入参数
| 参数名 | 含义 | 类型 | 举例 |
|---|---|---|---|
| dispatchID | 需要获取的调度记录 | string | DIS0001 |
- 传出参数
| 参数名 | 含义 | 类型 | 举例 | ||
|---|---|---|---|---|---|
| code | WIP状态码0:成功;1:还未运行完成;2:未发现调度记录;3:其他内部错误 | int | 0 | ||
| result | 运行结果,若报错则为null | - | - | ||
| dispatchId | 调度ID | string | DIS0001 | ||
| dispatch | 调度结果 | array[object] | - | ||
| dispatchZoneId | 调度区域ID | string | DISZONE001 | ||
| vehicleId | 车辆标识符 | string | 沪B-E7468 | ||
| seq | 顺序号(同一个收货客户的订单,顺序号相同) | int | 1 | ||
| lonLat | 经纬度 | string | 121.50389,31.29665 | ||
| addressNo | 地址编号 | string | ADDR002 | ||
| eta | 预计到达时间 | string | 09:35 | ||
| etd | 预计离开时间 | string | 09:48 | ||
| distance | 从上一个点到当前点的行驶距离(km) | float | 6.1 |