一家咖啡店能不能活,三分看产品,七分看位置。
那两千家呢?位置之外,还多了一个更贵的问题:每天 450 吨物料,从中心仓送到 2500 家门店,这条配送网络该怎么织?
前者是选址问题,后者是网络设计问题。两件事在传统连锁企业里通常由两套人马、两摊经验分别解决——选址团队看人流、看竞品、看租金;物流团队凭经验设仓、派车、划片区。规模到几百上千家店时,经验就会同时碰到两堵墙:选址靠感觉,对错要一年后才知道;配网靠经验,成本却每天都在发生。
我们最近做了一套系统,把这两件事放进同一个优化框架里一次算清。下面先用一个模拟案例看结果,再简单聊聊背后的技术思路。
先看结果:一座"合成城市"里的 2500 家店
为了验证系统,我们生成了一个可复现的模拟城市:由若干高斯"商圈中心"与主干道走廊构成的人群密度场,叠加 400 家竞争门店,然后让系统回答两个问题——
问题一:门店开在哪、分几档、各自能挣多少钱?
系统在密度场上完成了 S/A/B/C 四级门店布局:
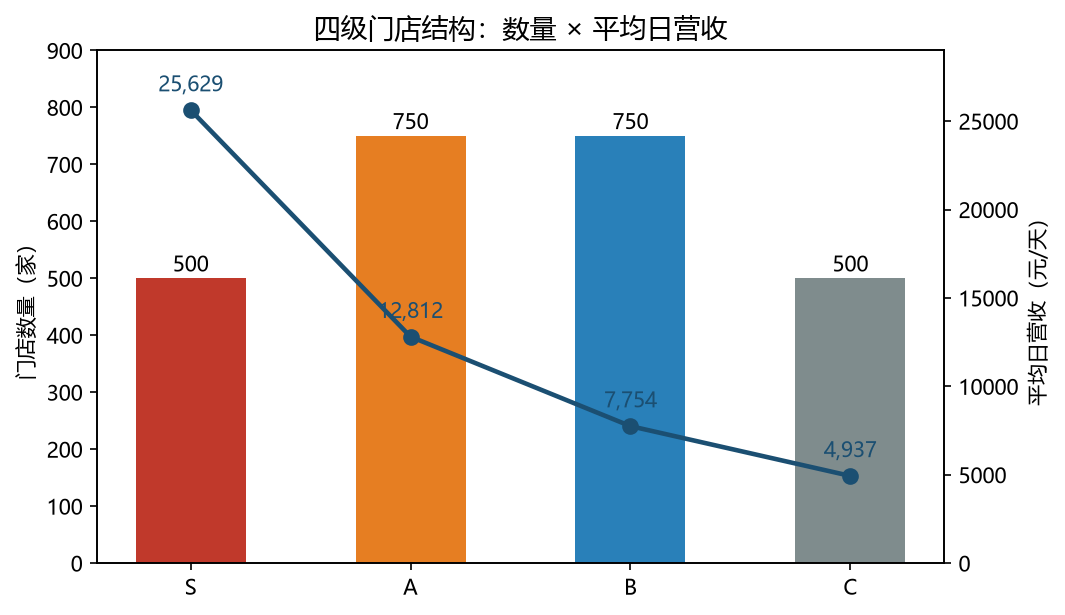
- 共 2500 家门店:S 级 500 家、A 级 750 家、B 级 750 家、C 级 500 家;
- 全网日营收合计 3071 万元;
- 等级之间的营收差距清晰反映了"位置即定价":S 级店平均日营收 25,629 元,最好的单店做到 53,407 元/天,是 C 级店平均水平的 5 倍多。
每一家店的营收都不是拍出来的,而是基于 Huff 重力模型测算:顾客选哪家店,取决于这家店的"吸引力"(面积、品牌、可见度)除以距离衰减,再和周边所有竞争者(包括那 400 家竞对门店)瓜分同一块人流。也就是说,这个营收预测从第一天就把"隔壁开了家竞品"算进去了。
问题二:货从哪来、经过谁、走哪条路?
系统给出了 16 个卫星仓的两级配送方案——中心仓用卡车跑一级干线,卫星仓用厢货做二级短驳:
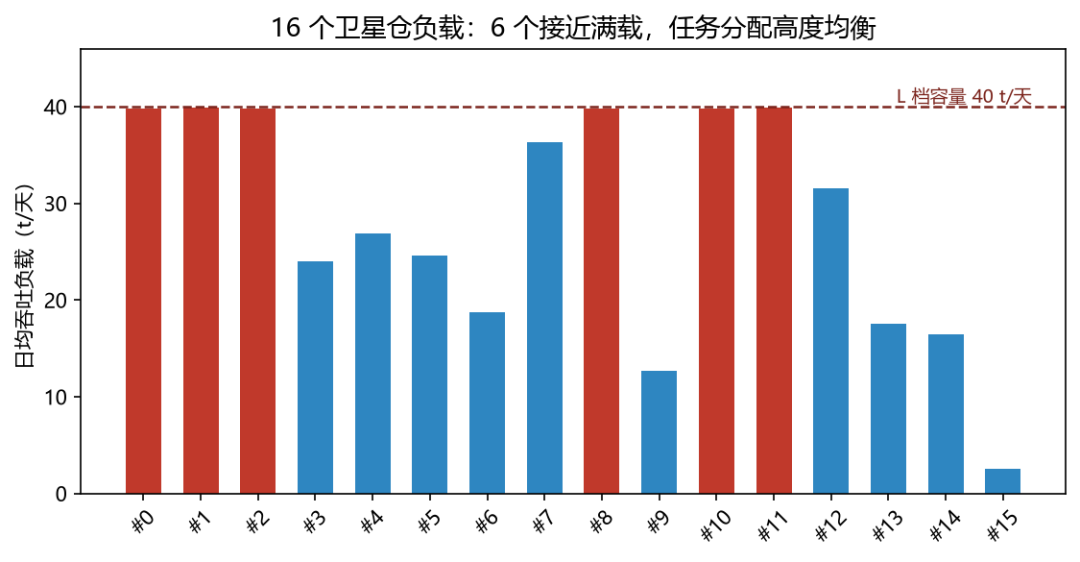
- 16 个卫星仓(全部为 L 档,单仓容量 40 吨/天),合计吞吐 450 吨/天,恰好等于 2500 家门店的配送总需求;
- 每个仓平均服务 156 家门店,仓间负载高度均衡,6 个仓被压到接近满载——没有闲置的仓,也没有过载的仓;
- 全网配送总成本 137,751 元/天,仅占全网日营收的 0.45%。
把选址和配送叠在一张图上看,是这样的:
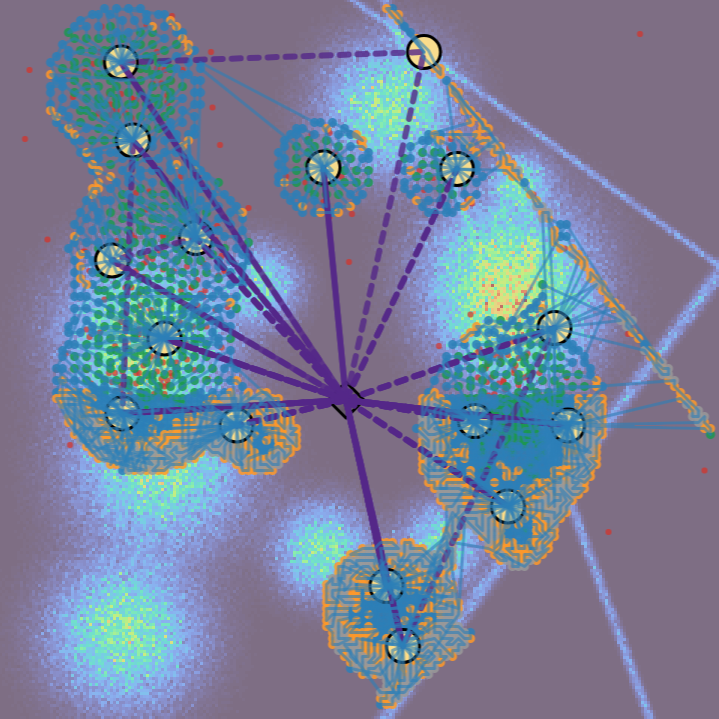
紫色虚线是卡车干线(中心仓→卫星仓),浅色细线是厢货短驳(卫星仓→门店)。人群密度高的地方,门店密、卫星仓也密;密度低的外围,靠少量仓辐射大片区域。仓的位置不是行政区拍的,是需求喂出来的。
这套东西还能用在哪?
方法本身与咖啡无关——任何"前端密集布点 + 后端多级配送"的生意,都踩在同一个问题上。几个典型的应用场景:
- 连锁餐饮 / 咖啡茶饮的扩张规划。 这是最直接的场景。每年开多少店、开在哪个商圈、旗舰店(S 级)与档口店(C 级)怎么配比、竞对在旁边开店时营收会被分流多少——这些过去靠加盟商经验和层层汇报的决定,可以变成一张带营收预测的排序清单。
- 即时零售与前置仓网络。 生鲜、日百前置仓的"选址 + 大仓→前置仓→用户"结构,与本案例的"中心仓→卫星仓→门店"几乎同构。区别在于配送对象从门店变成网格,但覆盖模型(MCLP)和两级网络优化的骨架可以原样复用。
- 连锁药店的分级布点 + 共同配送。 药店有明确的社区覆盖逻辑,且对配送时效敏感。覆盖模型保证服务半径,网络层决定区域仓数量与配送线路,特别适合"多而散"的县域市场。
- 社区团购 / 快消品经销商的片区重构。 传统经销商划片区往往沿历史边界,系统可以按真实需求重新切分:哪些片区该设共配中心、中心开什么档位、每条线路用什么车型,直接给出成本可比的方案。
- 城市物流与"最后一公里"政策评估。 两级网络(大车进城难→卫星仓换小车)正是很多城市共同配送试点的结构。这套模型可以用来评估"设多少个转运节点、设在哪儿、能省多少车公里"。
共同点是:点上的决策(开不开、开哪儿)和线上的决策(仓、车、路)在同一个成本口径下一起算,避免"选址赢了营收、配送却吃掉了毛利"。
技术方案:一句话版 + 三层拆解(不感兴趣可跳过)
选址用"覆盖 + 营收"双模型打分,配送用"选址-路径分解迭代",全部用成熟的运筹优化求解器在分钟级完成。
具体来说:
|
层 |
干什么 |
用的模型 |
|
选址层(L1) |
从候选点中选点,最大化人群覆盖,并用 Huff 模型预测每个点的期望营收、考虑竞争分流,输出排序清单 |
最大覆盖选址模型(MCLP,1974 年的经典模型)+ Huff 重力模型 + 贪心序贯选址 |
|
网络层(L2) |
决定卫星仓的数量、位置、容量档位,以及"中心仓→卫星仓→门店"两级路径 |
带容量约束的仓库选址问题(CWLP)+ 两级车辆路径问题(2E-VRP) |
|
耦合层 |
L2 算出的真实路径成本反馈回 L1 的选址打分,迭代到总成本收敛 |
类似 Benders 分解的主-子问题迭代 |
工程上有几个值得说的选择:
- 不求花哨,求可复现。 求解器用的是 Google 开源的 OR-Tools(CP-SAT + Routing),选型结论很明确:这个规模(候选点几百、门店几千)用精确 MIP + 启发式已经足够,不碰深度学习。所有测试实例带固定随机种子,任何人重跑结果逐点一致;
- 两级 VRP 没有现成模型(OR-Tools 不内置两级问题),我们把"卫星仓选址分配(MIP)"和"两级路径(分别解 CVRP)"拆开交替求解,用真实路径成本不断修正主问题——这是学术界 2E-LRP 问题的主流工程化解法;
- 运输方式可选。 仓有小/中/大三档(固定成本↑、单位成本↓),车有卡车/厢货/新能源等车型,求解器自动为每条线路选成本最低的合规组合;
- 距离可升级。 当前 demo 用欧氏距离×1.3 绕行系数,接口预留了 OpenStreetMap 真实路网(OSMnx),换真实城市数据时无需改模型。
技术调研的完整脉络(从 Church & ReVelle 1974 到 2025 年的大规模 2E-LRP)另有专文,这里不展开。
从 Demo 到落地,差三份数据
这个 demo 用的是合成数据,换到真实业务只需要替换三个输入:
- 人群密度(GeoJSON):手机信令、外卖订单热力、POI 客流均可;
- 候选点清单(CSV):租金、面积、可见度、竞品标记;
- 成本参数(JSON):仓的固定成本与档位、车型与里程成本、单店日配送量。
输出是两张清单:一张排序的选址推荐表(每个候选点的覆盖量、期望营收、竞争分流比例),一张配送网络方案(卫星仓位置+档位、每仓服务哪些店、两级路径明细、成本构成)。从数据进去到地图报告出来,标准规模 5 分钟内跑完。
写在最后
连锁扩张的竞争,表面是门店数量的竞争,背后是决策质量的竞争。同样 2500 家店,选址清单多覆盖几个高价值商圈、配送网络少开两个不必要的仓,一年省下的成本和改善的营收,可能就是利润表上最实在的那几行。
经验仍然重要——但经验最好的用法,是教会模型,然后让模型在凌晨四点把全城 2500 个点的方案算完。
本文转载自久章智能微信公众号(原文发布于 2026-10-16),内容保持原貌。扫码关注公众号「久章智能」,第一时间获取智能决策系列文章。阅读原文 ↗