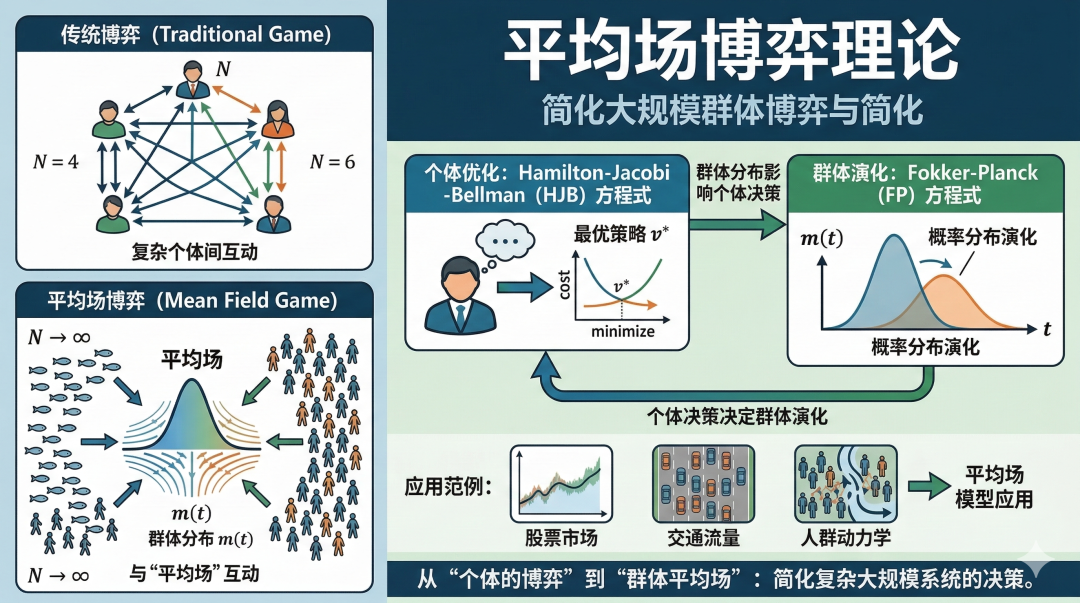
本文探讨了如何利用平均场博弈(MFG)理论解决大规模智能体在跨时空调度中的复杂决策挑战。传统方法在面对海量资源分配时常遭遇维度灾难和利益冲突,而平衡场博弈通过将个体间的交互简化为个体与群体平均状态的互动,显著提升了计算效率。
文中重点介绍了两个应用案例:一是JDRCL框架,它在网约车调度中平衡了平台效率与司机公平性;二是EMFRL方案,通过宏观基本图实现城市路网的非合作边界协同控制。这些模型利用哈密顿-雅可比-贝尔曼方程与Fokker-Planck方程的耦合,证明了分布式决策也能达到类中心化控制的稳定状态。总而言之,平均场博弈为处理物流、交通等大数据场景下的宏观演化与微观优化提供了坚实的数学框架。
全文共计:4235字
预计阅读:8-12分钟
一、平均场博弈
平均场博弈(Mean Field Game, MFG)是研究海量微小智能体(参与者)在竞争或动态环境下战略决策的数学与博弈论理论,结合了博弈论、随机分析和最优控制理论。在平均场博弈中,平均场借用了物理学中的概念,意味着在庞大的群体中,单个智能体的行为对整个系统的影响微乎其微。因此,每个智能体在决策时,不再单独针对其他每一个个体的行为作出反应,而是根据种群的整体状态概率分布(即“平均场”)来进行优化决策。在连续时间模型中,它通常由描述个体最优控制的哈密顿-雅可比-贝尔曼方程和描述群体聚合分布动态的Fokker-Planck方程耦合构成。
传统的多智能体模型或经典博弈论在处理大规模群体时,会面临“维度灾难”和指数级增长的计算复杂性,因为精确描述每一对个体之间的相互作用在数学和计算上都是不现实的。平均场博弈论专门用于解决含有海量交互智能体的复杂系统中的纳什均衡求解问题,将复杂的多体交互问题近似转化为个体与群体平均状态交互的单体问题。其优势主要有以下几点:
-
计算降维与高效性: 通过将复杂的个体间相互作用转化为对整体平均场的响应,MFG极大地降低了系统模拟和策略求解的计算成本,使得在交通、金融等大数据场景下进行宏观模拟成为可能。
-
兼顾微观决策与宏观演化: 相比于纯粹的物理学动力学模型,MFG不仅能描述群体状态的演变,还能解释个体是如何基于对未来的预期(理性预期)去主动优化自身策略的,具有更强的解释力。
-
易于与机器学习结合: MFG可以为多智能体强化学习(MARL)提供严格的理论框架,通过引入平均场动作(如MF-Q算法),能够有效突破经典多智能体强化学习在智能体数量增加时的计算瓶颈。
二、跨时空调度问题
跨时空调度是指在具有显著空间分布和时间演变特征的动态系统中,对海量资源(如网约车、城市交通流、物流配送等)进行分配和引导的过程。它不仅关注当下的资源匹配,更强调通过前瞻性的调度(如网约车的空车调度或交通边界的流量控制),以优化整个系统的长期运行状态。
该类问题的常规解决方案通常是基于传统优化方法(线性规划、排队论等)、启发式算法(模拟退火、邻域搜索、遗传算法等)或强化学习算法(DQN、A2C等)来求解。然而,传统解决方案通常存在以下难点:
-
状态与动作空间的指数级爆炸: 在真实的跨时空调度场景中(如成千上万的网约车司机或复杂的城市路网),如果采用中心化决策器为所有个体进行全局统筹,其状态空间和动作空间会随着个体数量呈指数级膨胀,面临严重的“单点故障”风险和不可计算性。
-
深度的时空耦合效应: 调度决策不仅决定当下的收益,还会深刻改变资源的未来空间分布,进而影响未来的匹配潜力和效率。例如,将网约车派往某地完成订单,改变了司机的地理位置,直接决定了其未来的接单概率。
-
多目标冲突(效率与公平难以兼顾): 调度系统往往需要同时优化整体“效率”(如平台的总交易额GMV、路网总通行量)和个体“公平”(如保证最弱势司机的收入底线)。然而,这两者往往存在内在冲突,只关注效率极易导致部分个体被边缘化,损害系统的长期可持续性。
-
动态变化的动作空间: 智能体在不同时间和空间下可执行的动作是动态变化的(例如网约车司机在不同网格面临的可用订单集合实时都在变化),这给算法的神经网络设计和特征表示带来了极大挑战。
-
异构主体的非合作博弈: 跨区域的调度(如城市交通边界控制)往往涉及不同利益相关者(如不同区域的管理者、内部停车场等)。他们缺乏集中通信,目标不一致,各自为政容易陷入对系统不利的双输局面。
三、基于平均场博弈的跨时空调度应用方案
1 · 网约车平台联合派单与空车调度
(基于 JDRCL 框架)
在网约车系统中,调度不仅决定当前的订单匹配(即时收益),还会改变司机的空间分布(未来收益潜力),传统的效率优先算法往往会导致部分司机收入过低。为此,研究者提出了一种受约束的多目标马尔可夫博弈(CMOMG)框架——JDRCL(Joint Order Dispatching and Driver Repositioning with Constrained MARL),在调度成本预算的约束下,联合优化长期的系统总订单量(效率)和最大最小公平性(公平)。
问题建模与目标函数:
将每一位司机视作一个独立的智能体。该框架包含两个优化目标:一个是代表平台效率的总体期望累积收益(GMV),另一个是代表公平性的所有司机中最差的期望累积收益(Max-min Fairness)。平台预设了总调度成本(如空车调度的补贴)的预算约束B。
问题的核心目标函数被公式化为受约束的最大最小优化问题:
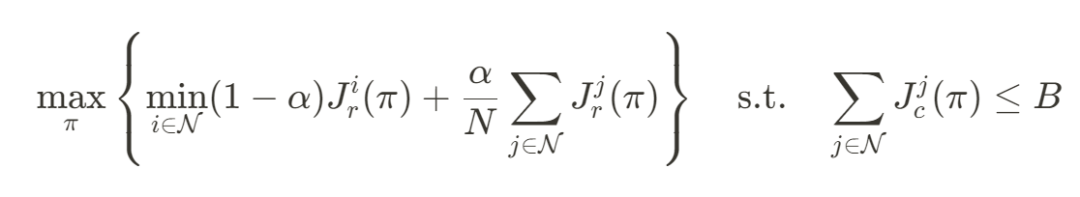
其中:
-
表示在联合策略 π 下,智能体i的长期期望累积收益。
-
表示智能体j的长期期望累积调度成本。
-
α 是平衡效率与公平性的调节系数。
拉格朗日对偶转换:
由于直接求解带有约束的最大最小问题极其困难,JDRCL 利用拉格朗日乘子法,将原问题转化为拉格朗日最大最小无约束问题:
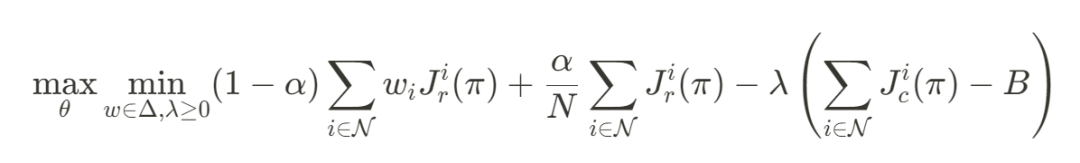
其中,θ是策略网络的参数(主变量),ω∈Δ是用于拟合最小化项的权重向量,λ是处理成本预算约束的非负对偶变量。
核心更新算法与推导:
算法采用原始-对偶迭代训练(Primal-Dual Iterative Training),交替更新策略参数θ和对偶变量λ。
-
策略(Actor)参数更新: 利用随机梯度上升最大化目标函数。其梯度的样本估计公式推导为:
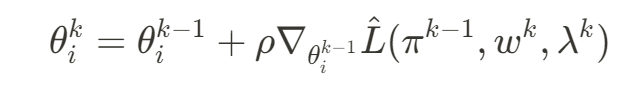
根据策略梯度定理,其核心梯度估计公式展开为:
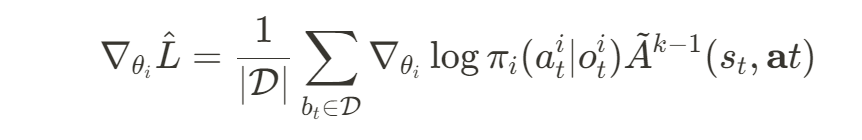
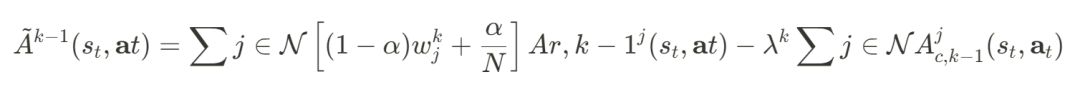
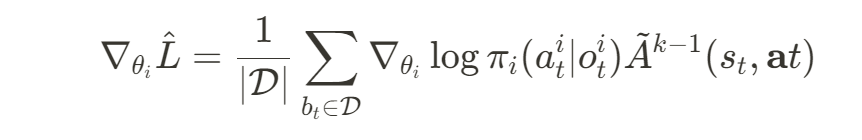
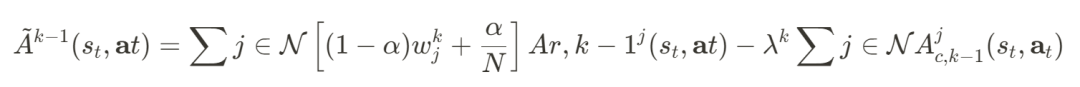
在这里,和分别是收益和成本的优势函数(Advantage function)。这一推导的物理意义是:智能体会倾向于增加那些不仅能提高全局整体收益和最弱势司机收益,同时又能降低系统整体调度成本的动作概率。
-
对偶变量更新: 通过投影梯度下降法来惩罚超出预算的部分:
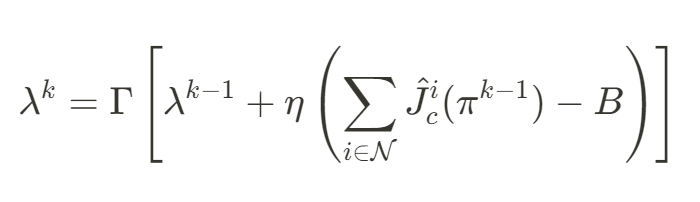
动作空间降维:
由于司机在不同时间、地点面临的候选订单池是实时变化的,这导致动作空间极其庞大且动态可变。为了解决这个问题,JDRCL 按目的地网格对订单进行聚类分组,将策略网络的输出维度固定为有限的网格类别(如G+9维,即G个候选订单目的网格与9个巡游邻近网格)。这种降维使得 Actor 网络每次只需进行一次前向传播即可高效完成最优动作的选择。
2 · 城市路网非合作边界协同控制
(基于 EMFRL 方案)
在城市交通调度中,如果将一个区域的跨界交叉路口(边界控制单元)和内部停车场等视为不同的利益相关者,它们之间往往缺乏集中的通信和物理连接,且有着相互独立的决策目标。为了避免各主体由于利益不一致而陷入双输的局面,研究者提出了扩展平均场强化学习(EMFRL)方法来进行非合作边界控制。
引入宏观基本图作为平均场:
传统基于细胞传输模型(CTM)的方法需要一个中央管理者控制所有的流率。EMFRL 放弃了这一中心化假设,转而在CTM模型中引入了描述区域路网整体运行状态的宏观基本图(MFD)概念,MFD 所反映出的边界总流率与路网车辆密度的关系,被作为平均场论中平均动作(Mean-field Action)的雏形。各智能体仅需感知路网整体反应出的边界流率这一宏观状态,即可做出局部最优的决策。
核心机制与 FP-HJB 方程系统:
寻找非合作博弈中的纳什均衡点,其本质上被转化为求解每个智能体的贝尔曼方程(Bellman Equation)。在连续时间与状态的平均场博弈理论框架下,这一分布式的微观决策与宏观演化过程,由著名的 Fokker-Planck (FP) 方程和 Hamilton-Jacobi-Bellman (HJB) 方程耦合构成的系统来数学化描述:
-
个体决策最优化的 HJB 方程(逆向演化): 每个局部交通控制单元(智能体)的目标是基于对未来的拥堵预期使自身效用最大化,其价值函数
满足:
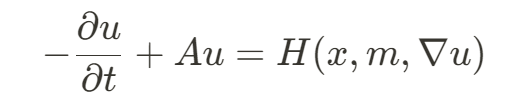
其中,A为扩散算子,H为哈密顿量,它代表了控制单元在给定的路网车辆密度分布m(平均场)下,计算出的最优交通流调节策略(反馈控制)。
-
路网宏观状态演化的 Fokker-Planck 方程(正向演化): 当所有分散的控制单元都依据各自的HJB方程执行边界控制策略时,路网中整体交通流的密度分布
的演变由连续性方程主导:
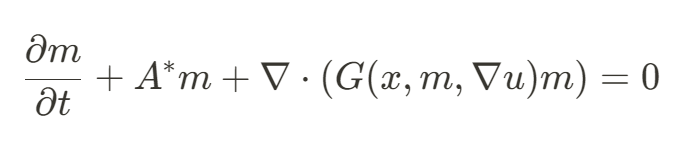
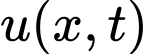
这里,反映了在最优控制场作用下的流量漂移项(宏观流率)。这套方程组在数学上严格证明了:即使缺乏中央管理者,只要智能体遵循对平均场m 的最优响应,系统也能收敛到与中心化控制表现相近的稳定宏观状态。
平均场动作预测器与特异性表达:
-
MFAP 的引入: 在多智能体强化学习中,由于各主体的策略都在不断更新,当前的平均场动作与未来的平均场动作是不稳定的。研究设计了平均场动作预测器(MFAP),以上一时刻的平均场动作和环境信息为输入,采用监督回归预测当前时刻的平均场动作。MFAP 会随着智能体策略逼近纳什均衡而同步收敛。
-
值分解网络(VDN)与置信分配: 为了减少在采用 EMFRL 进行平均场近似时产生的误差,模型在策略神经网络中引入了 VDN 结构,增强了同一组智能体之间的特异性表达,允许不同交叉路口和内部节点学习到分化的子策略,实现无通信的隐式协作。
作者 |王星凯
欢迎关注「久章智能」公众号
了解更多智能决策的前沿技术与行业应用
智能决策进行时:久章智能在物流与制造领域的探索与实践
大语言模型与运筹优化的融合:当前进展、挑战及未来思考
邮箱|[email protected]
本文转载自久章智能微信公众号(原文发布于 2025-03-06),内容保持原貌。扫码关注公众号「久章智能」,第一时间获取智能决策系列文章。阅读原文 ↗