传统的运筹优化解决方案通常采用“定制化建模+专业化求解”的方式。工程师需根据问题背景,结合专家知识构建数学规划模型,并通过求解器进行优化计算。如果客户对求解效率有较高要求,还需要专门开发定制化加速精确算法或启发式算法。
这一过程涉及需求调研、问题分析、数学建模、模型优化、算法开发、编程实现及调试等多个环节,既繁琐又容易出错,且通常需要大量时间和精力。因此,研究人员不仅需要具备深厚的运筹学背景,还需了解业务逻辑、精通数学建模以及编程和调试技能。
由此可见,运筹学在国内企业广泛应用的一个主要障碍是其较高的开发门槛。回顾运筹优化方案的开发流程可以发现,如果仅以“解决问题”为最低目标,而不考虑求解效果和速度,当前流程中最具挑战性的一部分是如何从非专业人员的需求描述中提取关键信息,并将其转化为数学规划模型。这一过程包含大量专家知识,很多信息是基于语义且难以量化的。正如杉数所提到的:“杉树过去8年,所有项目都要准确地将业务文字描述转化为数学语言[1]!”。
然而,随着大语言模型技术的快速发展,使得解决上述问题看到了希望。大模型的核心优势在于首次使机器能够“听懂”并理解人类语言,进而生成基于自然语言的响应。这使得人类能够直接以自然语言与机器进行互动。由于大模型依托海量的训练数据(几乎涵盖了人类所有知识),其强大的泛化能力、丰富的知识储备和出色的逻辑推理能力,使其在多个领域超越了单个人类专家的知识边界。因此,考虑到真实业务场景中往往蕴含了大量基于文本和语义的信息,是否可以借助大模型帮助我们“理解”这些信息,并建立相应的规划模型呢?一些结合大模型与运筹学的研究正是基于这一理念,试图利用大模型的语义理解能力,实现从客户需求到数学模型代码的自动生成,从而绕过传统的算法工程师定制化建模过程。我们将这一研究框架称为“大模型基于语言格式需求的辅助建模”。
01 · 大模型基于语言需求的辅助建模
该框架主要利用大语言模型强大的语言理解与生成能力,实现从“语言格式需求描述”到“完整运筹优化模型及代码生成”,再到“用优化求解器求解”的全过程。然而,由于大模型输出结果的本质是通过海量数据学习语言模式和逻辑关系,并基于概率进行预测,尽管结果看似合理,但其中可能存在“伪精确性”。在运筹优化模型的构建过程中,每一个变量、每一条约束的引入和设定都需要严格考虑,尤其在处理难以求解的非线性问题时,通常需要将其转化为等价的线性格式。只有经过严谨的数学推导,才能确保最终模型的正确性与可解释性。
大模型在处理这一流程时,无法确保每一步推导和转化的正确性,尤其在处理超长文本或大信息量任务时,产生“幻觉”的概率会大大增加。在运筹学中,即便是推导过程中微小的等价条件的充要性没有得到充分考虑,或者一个不起眼的符号错误,也可能导致最终结果的最优性无法保证。
尽管大模型的发展已催生出许多增强推理能力的方法,例如思维链(Chain-of-Thoughts)及其变体(如Tree of Thoughts、Graph of Thoughts)、渐进式提示方法(Progressive-Hint Prompting)、大模型智能体技术(ReAct)、反思机制(Reflexion)等,这些方法在数学应用题、24点游戏、小说写作等领域取得了显著进展,但目前基于语言的大模型辅助建模仍然仅能应对经典和简单的优化问题。在处理大规模高复杂性任务时,距离实际应用仍有较大差距。
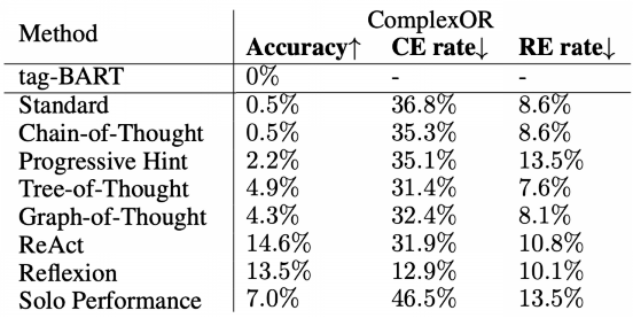
图1 基于大模型的算法在运筹优化问题建模上的表现[2]
图 1 中,左侧 Method 代表不同的基于大模型的算法,右侧展示了它们在复杂运筹优化问题数据集上的表现。从准确率可以看出,当前基于大模型的方法在复杂运筹优化问题上几乎全军覆没,最高准确率不超过 15%,即平均每 7 道题仅能解对 1 题,表现相当不理想。其主要原因在于,运筹优化的求解需要深厚的专业背景知识和极长的逻辑推理链路,而现有方法主要针对较简单的推理任务,因此难以适用于这一领域。
此外,该测试基于通用大模型,未针对运筹优化问题进行专业化微调,这在一定程度上限制了大模型的能力。然而,当前阻碍大模型针对运筹优化问题进行微调的核心瓶颈在于训练数据的稀缺性。目前开源的公共数据集多为单一且简单的场景,而优质的工业案例往往涉及私有数据,获取难度较大。
解决上述问题的最新实践有杉数的ORLM(Operations Research Language Model)运筹学大模型[3]。其核心贡献在于采用了一种半自动化方法——OR-INSTRUCT,用于创建、扩展和合成符合特定要求的数据,从而针对性地训练基准源大模型的优化求解能力。此外,杉数还构建了 IndustryOR,这是首个用于评估大语言模型解决实际运筹优化问题质量的工业基准测试。
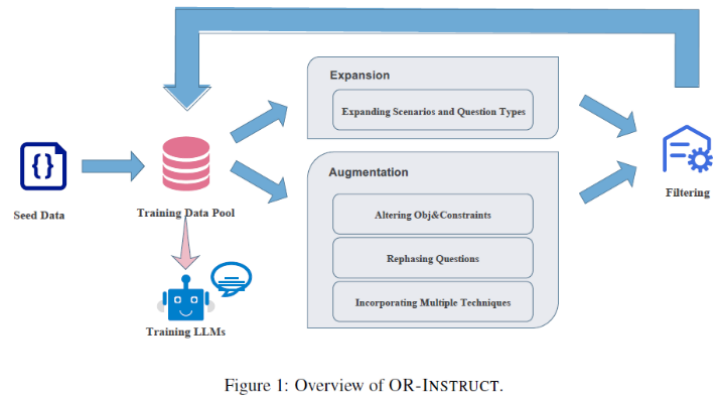
图2 OR-INSTRUCT方法框架
OR-INSTRUCT 通过 GPT-4 从 686 个真实行业案例中提取场景与问题类型作为种子数据,并通过扩展与增强操作生成了 30K 个训练样本。其中,扩展操作侧重于拓展应用场景,而非单一任务,从而提高数据的覆盖范围;增强操作则旨在丰富问题解决方案的多样性,涵盖问题描述、目标函数、约束条件的变更,以及不同建模技术的结合,以提升模型的泛化能力。
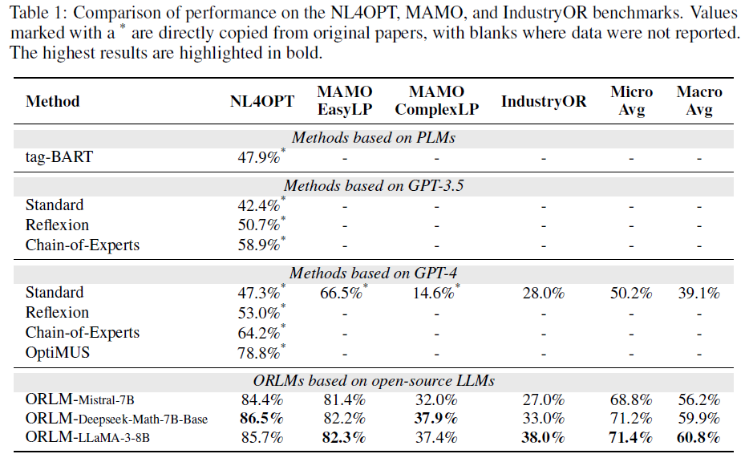
图3 不同模型的测试结果对比
在具体的训练过程中,杉数利用 OR-INSTRUCT 数据对多个约 7B 规模的开源大模型进行训练,包括 Mistral-7B、Deepseek-Math-7B-Base Shao 和 LLaMA-3-8B,并将训练得到的模型统称为 ORLM。测试结果显示,与未经过专门训练的开源大模型相比,ORLM 取得了显著的优化建模能力提升。例如,ORLM-LLaMA-3-8B 在 NL4OPT 和 MAMO(涵盖简单与复杂的线性规划)测试集,以及 IndustryOR 基准测试上,均达到了最先进的性能表现。与标准 Standard-GPT-4 相比,其微观平均提升 42.2%,宏观平均提升 55.4%。在求解复杂问题方面,ORLM-LLaMA-3-8B 在线性规划、整数规划和混合整数规划方面的表现优于 Standard-GPT-4。然而,在非线性规划及其他罕见问题类型上,两个模型的表现仍有待提升。
总体而言,在大模型基于语言需求的辅助建模这一应用中,数据是最核心、最关键的因素。并且尽管经过针对性微调的大模型在建模能力上相较于通用大模型有了显著提升,并在一定程度上降低了使用门槛,具备较强的通用性,但在面对复杂的工业级运筹优化问题时,仍存在较大困难,离实际应用落地还有不小距离。
02 · 使用大模型直接进行端到端的决策
如果说大模型基于语言需求的辅助建模主要依赖于大模型的语言理解与生成能力,那么使用大模型进行端到端决策则直接利用了 Transformer 模型的预测能力。传统优化问题的求解通常需要经历 需求数据 → 数学建模 → 最优化求解 → 解决方案 这一完整流程。虽然最终求得的解在理论上能够保证最优性,但整个过程复杂且耗时,且在不同问题之间缺乏泛化能力。如果我们已经拥有需求数据,且目标是直接得到可行的解决方案,那么是否有方法可以直接从需求数据到可行解之间建立起一个“映射函数”?通过这种方法,我们可以跳过繁琐的建模过程,只需将需求数据代入映射函数,即可快速得到可行解。基于这种“映射函数”获得可行解的决策过程,便被称为端到端决策。
端到端决策不直接对问题进行建模,而是学习从协变量 x 映射到决策z的决策规则,寻找一个能够直接将协变量映射到决策的规则函数。该框架的优势在于,一旦获得了决策规则函数,对于未来可能的情景,只需将相应的协变量代入规则函数,即可迅速得到决策,而不需要重新求解优化问题。这一特性使得端到端决策特别适用于需要快速决策的场景。
构建一个自变量到因变量的映射函数的方法有很多种,从最简单的多元线性回归到复杂的机器学习和深度学习方法都能实现。然而,由于现实中优化问题的最优解空间通常是高维非线性的,传统的线性回归方法难以得到理想的映射函数。因此,许多研究选择采用机器学习\深度学习方法来解决这一问题。例如,京东的端到端库存管理模型[4]就是一项典型的实践研究。该研究通过历史观测数据训练深度学习模型,能够直接从输入特征输出建议的补货数量,而无需任何中间建模步骤。
与传统深度学习模型相比,大模型在执行端到端决策任务时表现出更强的学习能力。这是因为大模型不仅能够处理结构化数据,还能处理非结构化数据和信息(如直接的语言描述),在上下文长度和知识广度上也明显优于普通深度学习模型。
例如,Google DeepMind 团队提出的优化方法——Optimization by PROmpting(OPRO) [5],聚焦于使大模型作为优化器,直接生成问题的解和提示词。以优化问题的求解为例,OPRO 的核心流程如图 4 所示。首先,OPRO 以 Meta-Prompt 作为大模型的输入,生成问题的可行解,并计算解的目标函数值作为评分。接着,新生成的解和评分组成“Solution-Score pair”被添加至 Meta-Prompt,用于下一轮优化。
显然,Meta-Prompt 的设计对于大模型是否能够胜任优化任务至关重要。Meta-Prompt 主要由两部分构成:
-
优化问题的相关描述: 借助大模型处理自然语言处理(NLP)任务的优势,将问题的目标函数、约束条件以及相关背景用文字进行描述。此外,还可以添加非正式的正则化提示词,如“提示应简洁且具有普适性”;
-
优化的历史信息: 适当的历史上下文演示有助于大模型识别潜在的模式。OPRO 会将历史解及其评分按升序排列,帮助大模型发现高评分解之间的相似性。
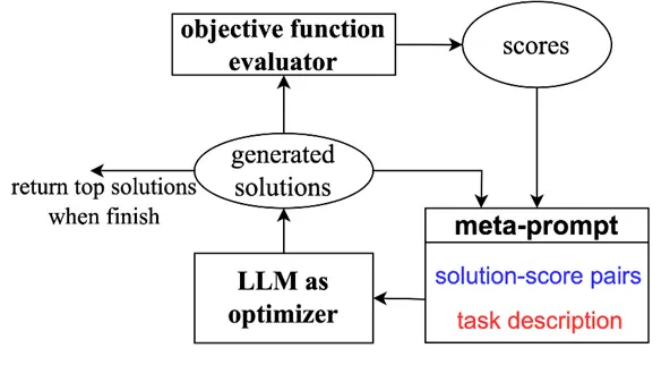
图4 Google团队的OPRO优化流程示意图
在生成解的阶段,可以通过每轮优化生成多个解来减少不稳定性,并通过自适应调整大模型的采样温度,以实现探索与开发之间的平衡。图3为OPRO在TSP问题上的求解结果,其中NN(Nearest Neighbor)和FI(Farthest Insertion)为求解TSP问题的经典启发式方法。在n=10和15时,大模型能够以极小的gap求得近优解,但随着TSP节点数的增多,LLM的求解性能显著下滑。
在生成解的阶段,可以通过每轮优化生成多个解,以减少不稳定性,并通过自适应调整大模型的采样温度,实现探索与开发之间的平衡。图 3 展示了 OPRO 在 TSP 问题上的求解结果,其中 NN(Nearest Neighbor)最近邻法和 FI(Farthest Insertion)最远插入法是求解 TSP 问题的经典启发式方法。在 n=10和15时,大模型能够以极小的 gap 获得近优解,但随着 TSP 节点数的增加,大模型的求解性能显著下滑。
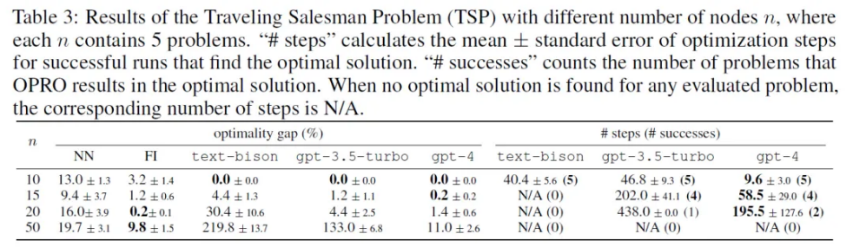
图5 OPRO方法在TSP问题下的性能表现
此外,清华团队的《City-LEO:使用大语言模型和端到端优化实现透明城市管理》 [6]首次提出了一种创新的大语言模型嵌入式智能体——City-LEO (LLM with End-to-End Optimization)。该智能体结合了大语言模型在先验知识逻辑推理方面的优势,将端到端建模框架与预训练随机森林相结合,有效缩小了预定义的大规模优化问题的范围,从而应对不确定运营环境中的城市管理挑战。
该研究设计的 City-LEO 智能体任务框架集成了代码保护机制,能够遵循 Gurobi 优化语言的规则进行迭代验证。图 6 展示了智能体的框架结构,包含问题匹配器、问题相关目标生成器、问题裁剪工具、端到端模型和响应提示器等关键组件。
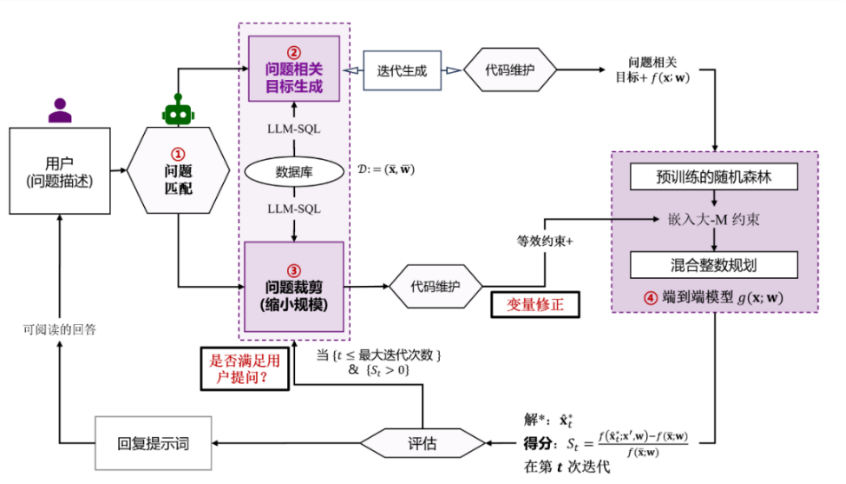
图6 City-LEO智能体结构
该方法的具体步骤如下:
-
问题匹配器 将用户提问 Q与特定领域的智能体进行匹配。
-
问题相关目标生成器 生成基于用户提问的目标函数f (x;w),作为端到端优化问题的辅助目标。
-
问题裁剪工具 缩小决策变量x的可行域X,主要通过搜索并参数化与用户提问关联较弱的决策变量x'∈X 实现。
-
端到端模型 包含两个目标函数:随机森林相关目标和用户提问相关目标。本体由不同的经过预训练的随机森林模型组成。
-
维护机制 使用自我迭代来确保大语言模型输出的可靠性。
该研究将 City-LEO 应用于城市共享电单车(E-Bike Sharing,EBS)运营管理场景,并进行了数值实验。在端到端模型中,随机森林模型基于共享电单车系统的实际运营数据和相应的天气数据进行训练。树形结构能够捕捉用户需求中的内在不确定性,因为它依赖于历史气象信息和运营记录进行学习。最终的数值实验结果表明,City-LEO 能更好地匹配用户提问的问题,并将相关目标融入端到端优化模型中;在不同的问题缩小范围设定下和在精度上有一定的妥协时,City-LEO表现出了优越的计算效率;City-LEO 提供的共享电单车运营策略相较于完整模型更好地满足了用户需求。
总体而言,与基于传统深度学习的端到端框架相比,直接使用大模型进行端到端决策能够显著提升学习能力和决策质量;与传统运筹优化方法相比,获得较好的映射函数后,可以迅速获得可行解,响应速度大大提升;而与通用大模型相比,它能够处理更为复杂且工业化的优化问题。然而,大模型的端到端决策框架的开发和训练,项目复杂度、开发难度和所需的专业知识投入不亚于传统运筹优化模型。此外,端到端模型的训练需要大量高质量、高垂直性的历史数据作为输入,因此该框架更适用于依托大型企业平台经济、拥有丰富私有历史数据(支持模型训练及算法实施效果因果检验)且需要快速响应的特定优化问题场景,而不太适合通用性的运筹优化问题。
03 · 使用大模型辅助改进现有智能优化算法
另有一些研究主要利用大模型来辅助改进现有的智能优化(启发式)算法。启发式算法通常通过一些启发式规则跳出局部最优解,寻找全局最优解。这些规则的设计大多基于经验总结,而不依赖严格的数学推理,因此非常适合大模型来指导规则设计——它们具备一定的规律性,但无需严格的推理证明(类似于生物学中通过大模型寻找有效的蛋白质分子结构)。在某些情况下,大模型的“涌现”现象可能会生成意想不到的算子,从而显著提高启发式算法的求解效率。
相关研究包括 Liu 等人(2024)[7]的工作,该研究提出了一种大模型驱动的进化算法(LLM-driven EAs, LMEA),首次将大语言模型应用于进化组合优化器。该方法通过提示词工程引导大模型对当前种群进行选择、交叉和变异等经典进化操作,避免了对各类算子复杂设计的需求,也无需对模型进行额外的训练。同时,LMEA 配备了一个自适应机制,用以调节大模型的温度,从而在探索与利用之间取得平衡,避免搜索陷入局部最优解。
对于 LMEA 方法,其提示词的构建主要包括三部分:
-
问题描述和解的特性: 包含优化问题的描述以及期望解的特性与格式;
-
上下文例子: 通过展示优化问题的解及其对应的适应度函数值,帮助大模型理解这些信息,通常来自当前种群;
- 任务说明: 为大模型提供明确的任务指引,包括父代选择、交叉和变异等操作,用于产生新解。
不难发现,LMEA 方法的提示词构建与上文中的 OPRO 方法有相似之处。然而,OPRO 更侧重于直接让 LLM 根据当前种群生成新的解;而 LMEA 方法则从进化思想出发,利用大模型的优势,驱动选择、交叉和变异这三个经典进化算子,从而实现更高效的进化。
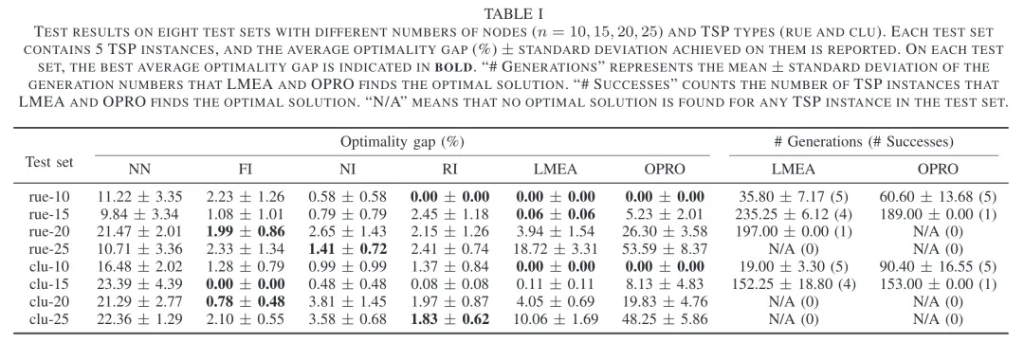
图7 LMEA方法在TSP问题上的求解结果
图 7 展示了 LMEA 方法在 TSP 问题上的求解结果,并与不同启发式方法以及 OPRO 方法进行了对比。实验结果表明,LMEA 方法在小规模问题(n=10 和 n=15)下得到的解与最优解非常接近,且在所有测试案例中,LMEA的表现都优于 OPRO方法。然而,随着节点数的增加,LMEA 和 OPRO 都未能很好地处理大规模 TSP 问题,其性能不及传统启发式方法。
尽管 LMEA 借鉴了进化算法的思想来指导大模型生成解,但某种程度上,它仍可归为“端到端”框架一类,因为与 OPRO 一样,LMEA 也是通过大模型直接生成解。这种直接生成解的方式,可能会限制大模型在处理大规模组合优化问题时的表现。因此,越来越多的研究者开始利用大模型的优势,并引入进化计算(Evolutionary Computing, EC)思想来生成启发式规则,这类技术也被称为语言超启发式(Language Hyper Heuristic, LHH)。
相关研究包括 Google DeepMind 团队完成并发表于《Nature》上的研究[8]。与大模型直接生成解的求解范式不同,该研究的目标是生成用于求解的启发式规则。论文介绍了一种名为 FunSearch 的方法,通过在函数空间中搜索并利用反馈循环实现启发式规则的自动化设计。FunSearch 方法是一个对求解程序的迭代过程,每次迭代中,系统会从当前的程序池中选择一些程序作为提示词,由大模型生成新的程序并自动进行评估。能够正常运行的程序将被加入现有程序池,从而形成自我改进的循环。
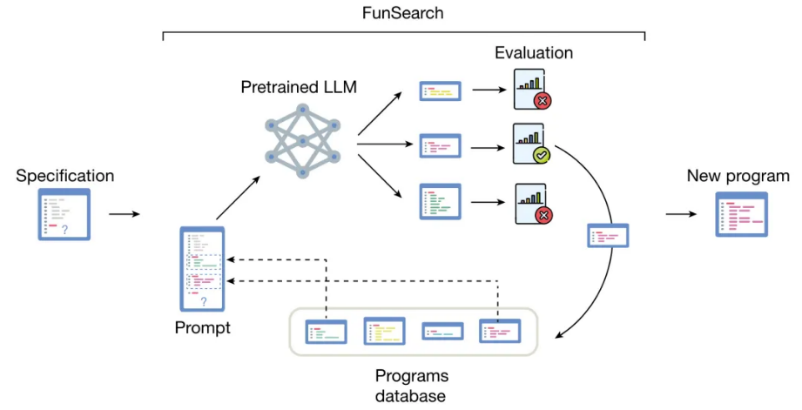
图8 FunSearch方法流程图
如图 8 所示,FunSearch 方法通过不断生成新程序并进行评估,采用迭代循环的方式对启发式规则空间进行搜索,从而获得更高效、更具性能的求解程序。为提高 FunSearch 的搜索效率和性能表现,将解(代码程序)被表示为框架(Skeleton)形式,只对关键部分的代码进行优化和搜索。
同时,FunSearch 方法在帽集问题(Cap Set Problem)和装箱问题(Bin Packing Problem)上进行了实验验证。实验结果表明,在某些帽集问题的样例中,FunSearch 方法得出的解超过了迄今为止已知的最好解。而在装箱问题上,FunSearch 同样表现出卓越的性能,在不同算例中超越了 First Fit 和 Best Fit 启发式方法。
与直接求解不同,FunSearch 方法从算法设计的角度出发,探讨如何更好地利用大模型在理解和推理方面的优势,辅助优化问题的求解。FunSearch 方法创新性地提出了一个大模型驱动的算法设计框架,为后续超启发式方法的研究奠定了基础。
此外,还有Liu等人(2024) [9]的研究,提出了EoH(Evolution of Heuristics),通过大模型实现启发式规则的自动设计。EoH 将大模型和提示工程融入进化计算框架中,通过迭代进化思想,使大模型不断生成启发式思想(High-level Thoughts)和对应的可行代码(Low-level Code)。EoH的性能已在在线装箱问题、旅行商问题(TSP)和车间调度问题中得到验证。以TSP为例,在200节点规模的问题中,EoH 可获得约0.2%的gap。
与 FunSearch 类似,EoH中大模型生成的也是启发式规则,但其查询次数比FunSearch 少了三个数量级。EoH 设计了5个提示策略,分别侧重于探索(广泛搜索启发式空间)和修改(从以往经验中学习并优化)。通过将生成的启发式规则应用于一系列问题(如 TSPLib 中的某类问题),计算适应度函数值并评估整体性能。值得注意的是,FunSearch 仅对代码生成做出了提示,而 EoH 则同时生成了思想和代码,消融实验验证了 High-level Thoughts 的指导有效性。
FunSearch 和 EoH 等方法将大模型纳入进化计算框架,采用生成启发式规则的方式,已在求解组合优化问题时优于直接生成解的 OPRO。然而,在大规模问题的求解中,大模型优化的性能仍不及端到端神经组合优化。研究者发现,尽管提供了上下文演示信息或优化历史,启发式策略的优劣仍然是隐式告知大模型的。受控制系统反馈机制启发,研究者开始尝试引入反馈思想,让大模型生成反馈提示信息,以指导后续策略的生成。
Ye等人(2024)[10]提出的 ReEvo 融入了上述反馈思想,通过 Reflection Evolution 的方式增强了 LHH,使大模型为启发式规则的生成提供了语言梯度(Verbal Gradients),从而提升了其推理能力。ReEvo 继承了遗传编程(Genetic Programming, GP)框架,其优化流程主要包括五个步骤:选择、短期反馈(Short-term Reflections)、交叉、长期反馈(Long-term Reflections)和精英变异。
短期反馈指大模型根据父代启发式规则的相对表现进行反思,并提供改进设计的提示。这一反馈能够为启发式搜索空间提供语言梯度,从而使优化问题的适应度景观(Fitness Landscape)更加平滑。短期反馈会被纳入交叉操作,与问题描述、父代启发式规则及其适应度值等信息一起作为交叉操作的提示。
长期反馈则是指大模型在启发式设计过程中进行的长期思考,通过融合最新的短期反馈和先前的长期反馈,给出总结性的提示。基于长期反馈,大模型将采样生成多个启发式规则,进而优化现有最优解,即精英变异。
从大模型代理架构的角度来看,短期反馈解释了每轮互动中的环境反馈;长期反馈则提炼了积累的经验和知识,并将其融入推理上下文中。
ReEvo 论文中进行了充分的验证试验,以 TSP、CVRP、MKP 等五个经典组合优化问题为例,ReEvo 与 ACO 和 DeepACO(SOTA)进行了对比。在 TSP50、OP50 和 MKP100 等问题中,ReEvo 的表现超过了 DeepACO(端到端神经组合优化的一种),即使后者在测试问题规模上发生了过拟合。论文还观察到,大多数 ReEvo 生成的启发式规则在不同问题规模和数据分布下表现一致。因此,随着数据分布偏移的增加,LHH 相比于神经组合优化的优势将更加明显。
总体而言,使用大模型辅助改进现有智能优化算法是一个取得了较好效果的方向,无论是学术研究还是工业应用,都有望在求解效果和可解释性方面,在端到端框架中取代传统的机器学习模型。
04 · 基于多个大模型构造的专家系统
在现实中,对一个现实问题的建模,往往需要一系列人类专家参与,这些专家各自具备不同的知识背景并具备优秀的推理能力。由此,是否可以训练多个大语言模型,使其表现类似于人类专家呢?对此,Xiao等人(2024)[11]在 AI 领域顶级会议 ICLR 上的研究提出了“大模型专家”的概念。每个大模型专家负责解决特定的子问题,如解释专业术语、提取变量与约束、构建数学模型、编程、调试修正等。与人类专家团队类似,多个大模型专家可以协作,共同解决一个问题。
该系统的协作流程如图 9 所示。每个“专家”底层由一个大模型支持,专家能够自动化地检索问题相关的知识库,激发大模型在上下文语境中的学习能力,并利用思维链进行推理。那么,专家如何协作呢?该系统引入了一个特殊角色——Conductor,能够智能选择合适的专家进行询问,并将专家的结果放入一个公共评论池,再选择下一个专家。每个专家在推理时,都可以查看公共评论池中的前一个专家的推理结果,从而实现专家之间有序协作,形成链式结构。该系统因此被称为“专家链”。此外,专家链还具备反思能力,系统会根据最终程序的运行结果进行反思。如果程序未能成功运行或建模无效,错误信息将从专家链末端传播至前端,从后向前进行反思,直到找到并修正错误,从而提高建模的成功率。
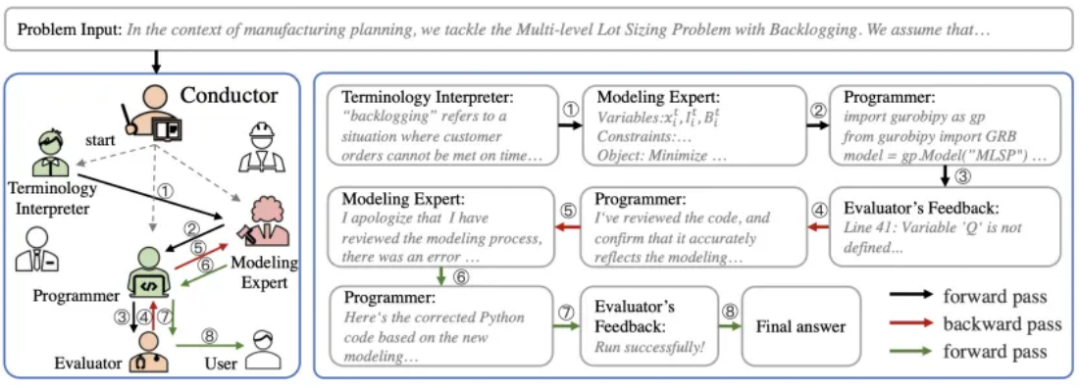
图9 “专家链”系统整体框架
实验证明,“专家链”系统在复杂建模数据集下的效果几乎提高了一倍(从14.6%提升至25.9%)。该数据集包含了37个运筹优化领域的高难度问题,来源于学术研究和实际工业难题。图10展示了“专家链”系统与对比算法在各个难题上的表现。值得注意的是,该方法不仅适用于ChatGPT大模型,还能根据需求替换为不同的基底模型,如LLaMa2 或Claude,具有良好的可移植性。
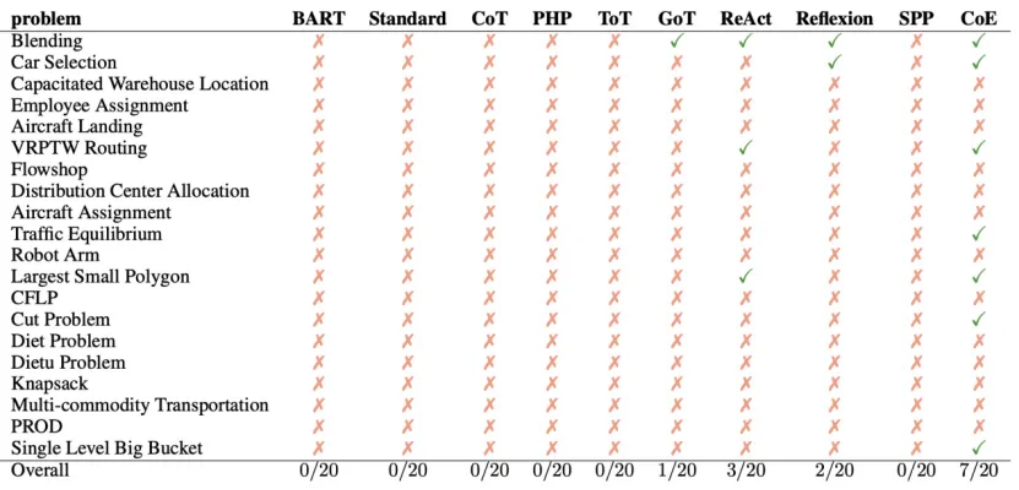
图10 各个对比算法在每个难题上的表现,
最右一行是“专家链”系统的表现
总体而言,专家链系统为未来大模型在运筹优化领域的应用开发提供了一个良好的思路。该研究表明,直接利用通用大模型解决优化问题,可能导致“每个环节都不精,整体效果更不好”的局面。相比之下,采用类似人类专家团队决策的思路,通过构建多个专门化的小模型,并由一个协调者进行有效管理,可以充分发挥各个小模型的特长,从而实现更高效、更精确的整体效果。
05 · 总结
本文回顾了大模型在运筹优化领域的多条探索路径。从当前研究来看,大模型的应用主要集中在两个方向:一是利用大语言模型的自然语言理解与知识表达能力,实现问题的自动抽象和数学建模;二是融合大模型与传统优化算法,推动决策求解与策略优化。这些探索在突破传统方法局限、提升求解效率以及改善模型解释性方面均已取得显著进展,但数学严谨性、数据依赖、模型泛化以及“黑箱”问题仍亟待解决,反映出了理论与实践间的明显差距。因此,本文提出了对大模型与运筹优化结合的未来发展趋势的几点思考:
1. 未来大模型与运筹优化的深度融合将催生由多个专业化小模型协同构成的复杂智能体,乃至形成完整的智能生态系统。近年来的实践经验和“专家链”系统探索表明,通用大模型在应对具体复杂任务时存在局限。未来的系统将根据任务逻辑拆分为若干子系统,每个子系统由专门训练的小模型承担特定功能。类似于现有APP通过调用多个API完成任务,未来的系统可同时调动精确建模与求解、启发式建模与求解等多种API,并由“领导”模型实时评估各模块表现,最终输出综合最优方案。这样的系统将集成精确求解、启发式优化、代码生成与核查等多项功能,逐步演化为一个功能完备、任务多样的运筹优化问题解决生态系统。
2. 应注重培养大模型调用现有工具完成任务的能力,而非直接让其承担任务。尽管大模型在各类任务上展现出良好的能力,但其本质仍是基于概率输出的语言模型,擅长于理解语言信息而非数学推导或求解等任务。对于那些已有专业软件能够高效完成的单一维度任务,大模型并不需要耗费大量资源来追赶。相反,应注重训练大模型有效利用现有专业软件来解决问题。这包括自动整理输入数据、指导专业软件执行任务,并自动评估结果以决定调整执行参数、重新执行,或直接整理并输出结果。以上可能需要修改专业软件的底层代码,或是增加转换层,以确保两者能够共享相同的推理框架或逻辑规则
3. 可以集成形式化验证工具如 Lean 4 来辅助验证其数学推导的正确性,特别是在复杂规划模型的等价转化过程中。这一方法能够直接确保大模型在数学推理上的严格准确性。当大语言模型生成数学解答时,其输出可被传递至 Lean 4 等形式化验证工具,通过自动化定理验证与推导过程检查,确保推导结果符合数学标准。此自动化验证步骤大大提升了大模型在运筹优化中的解题精度,确保结果的严谨性与正确性。
最后,作为一个未来的运筹优化算法工程师,在面对大模型来势汹汹的潜在冲击时,尽管内心充满焦虑与担忧,但也要客观性地看待大模型能对推动运筹优化在国内进一步落地的潜在贡献和其本身存在的不足。目前来看,大模型在抽象建模方面的能力仅相当于一个在读硕士生,还远远未达到取代传统运筹优化算法工程师的地步。其日后发挥的作用最有可能会和现今的开发岗位类似,作为一种效率提升的辅助工具和快速上手新领域知识的好老师。
然而,也不要因此妄下定论固步自封,从而被时代抛弃。毕竟数年前还在依赖LSTM模型做自然语言处理时,谁也无法想到今日大模型表现出的一统江湖的强悍能力。运筹优化在国内本就是相对小众的领域,大多数制造业对其重视程度不高。如果大模型的出现能够降低运筹优化的开发门槛,使得越来越多的企业更加重视生产要素的匹配效能,那么这无疑将拓宽运筹优化的需求空间,社会对运筹优化算法工程师的需求也会越来越旺盛。因此,我们能做的就是积极拥抱新知识,保持终身学习的态度,力求成为冲击浪潮上的弄潮儿,这样才能在瞬息万变的市场环境中,持续保持竞争力,迎接新的机遇与挑战。
参考文献
[1]. 智能决策大模型ORLM的研发与商业应用落地, https://mp.weixin.qq.com/s/GHFgEmrBg-G49JGJU0sGXA
[2]. 当大模型遇上运筹优化:一句话就能自动建模的「专家链」系统, https://mp.weixin.qq.com/s/UMFmTYCtCCfNTKsqyOTvEQ
[3]. 杉数发布首个开源运筹学大模型ORLM,效果超越GPT-4, https://mp.weixin.qq.com/s/1NyjyBNtKbTxpK_VdmFydw
[4]. Qi, M., Shi, Y., Qi, Y., Ma, C., Yuan, R., Wu, D., & Shen, Z. J. (2023). A practical end-to-end inventory management model with deep learning. Management Science, 69(2), 759-773.
[5]. C. Yang, X. Wang, Y. Lu, H. Liu, Q. V. Le, D. Zhou, and. X. Chen, “Large language models as optimizers,” arXiv preprint arXiv: 2309.03409, 2023.
[6]. Jiao, Z., Sha, M., Zhang, H., Jiang, X., & Qi, W. (2024). City-LEO: Toward Transparent City Management Using LLM with End-to-End Optimization. arXiv preprint arXiv:2406.10958.
[7]. Liu S, Chen C, Qu X, Tang K, Ong YS. Large language models as evolutionary optimizers. In 2024 IEEE Congress on Evolutionary Computation (CEC) 2024 Jun 30 (pp. 1-8). IEEE.
[8]. Romera-Paredes B, Barekatain M, Novikov A, Balog M, Kumar MP, Dupont E, Ruiz FJ, Ellenberg JS, Wang P, Fawzi O, Kohli P. Mathematical discoveries from program search with large language models. Nature. 2024 Jan 18;625(7995):468-75.
[9]. Liu F, Xialiang T, Yuan M, et al. Evolution of Heuristics: Towards Efficient Automatic Algorithm Design Using Large Language Model. Forty-first International Conference on Machine Learning. 2024.
[10]. Ye H, Wang J, Cao Z, et al. Reevo: Large language models as hyper-heuristics with reflective evolution. arXiv preprint arXiv:2402.01145, 2024.
[11]. Xiao, Z., Zhang, D., Wu, Y., Xu, L., Wang, Y. J., Han, X., ... & Chen, G. (2023). Chain-of-experts: When llms meet complex operations research problems. In The twelfth international conference on learning representations.
作者 | 西安交通大学 佟磊
本文转载自久章智能微信公众号(原文发布于 2025-10-16),内容保持原貌。扫码关注公众号「久章智能」,第一时间获取智能决策系列文章。阅读原文 ↗