本文档主要对IBM最新推出的Granite 3.0进行调研与试用,形成了调研报告和使用过程的指导,方便读者了解和试用最新推出的Granite 3.0模型和学习寻找Granite 3.0相关的资源。
撰写本文档的目的在于记录调研Granite 3.0的工作内容和使用方法,以及过程中涉及到的相关开源资源与文档的整理。
遵循本文档的指导,可以快速有效地了解Granite 3.0模型,通过文档指导可以将Granite 3.0模型快速在本地部署使用。将其作为Granite 3.0相关工作的参考资料。
全文共:4826字
预计阅读时间:14-20分钟
01 · Granite3.0模型简介
1 · Granite 3.0模型的内容
IBM的Granite 3.0家族系列包括:
- 通用/语言模型:
-
Granite 3.0 8B Instruct,
-
Granite 3.0 2B Instruct,
-
Granite 3.0 8B Base,
-
Granite 3.0 2B Base
- 护栏与安全模型:
-
Granite Guardian 3.0 8B,
-
Granite Guardian 3.0 2B
- 专家混合模型:
-
Granite 3.0 3B-A800M Instruct,
-
Granite 3.0 1B-A400M Instruct,
-
Granite 3.0 3B-A800M Base,
-
Granite 3.0 1B-A400M Base
通用/语言模型主要用于自然语言理解和生成任务,适用于广泛的场景,如文本生成、问答系统、对话系统等。
1. Granite 3.0 8B Instruct是一个大型的语言模型,参数量为80亿。它经过指令调优,适合处理复杂的任务,如生成详细的回答、编写文章、翻译等。
2. Granite 3.0 2B Instruct是一个中等规模的语言模型,参数量为20亿。同样经过指令调优,适用于中等复杂度的任务,如简单的文本生成、问答等。
3. Granite 3.0 8B Base是一个大型的基础语言模型,参数量为80亿。它没有经过特定任务的调优,适用于需要大量参数的通用任务。
4. Granite 3.0 2B Base是一个中等规模的基础语言模型,参数量为20亿。同样没有经过特定任务的调优,适用于中等规模的通用任务。
护栏与安全模型是专门设计用于提高模型的安全性和可靠性,防止生成有害或不当的内容。
1. Granite Guardian 3.0 8B是一个大型的安全模型,参数量为80亿。它经过专门的训练,以识别和过滤有害内容,确保生成的内容是安全和合适的。
2. Granite Guardian 3.0 2B是一个中等规模的安全模型,参数量为20亿。同样经过专门的训练,适用于需要中等规模安全保护的场景。
专家混合模型结合了不同领域的专业知识,适用于特定领域的任务,如金融、医疗、法律等。
1. Granite 3.0 3B-A800M Instruct是一个中等规模的混合模型,参数量为30亿,附加了8亿参数的专业知识模块。经过指令调优,适用于需要专业知识的任务,如金融分析、法律咨询等。
2. Granite 3.0 1B-A400M Instruct是一个较小规模的混合模型,参数量为10亿,附加了4亿参数的专业知识模块。同样经过指令调优,适用于需要中等专业知识的任务。
3. Granite 3.0 3B-A800M Base是一个中等规模的基础混合模型,参数量为30亿,附加了8亿参数的专业知识模块。没有经过特定任务的调优,适用于需要大量参数和专业知识的通用任务。
4. Granite 3.0 1B-A400M Base是一个较小规模的基础混合模型,参数量为10亿,附加了4亿参数的专业知识模块。同样没有经过特定任务的调优,适用于需要中等参数和专业知识的通用任务。
2 · Granite 3.0模型的优势
-
原始性能方面
Granite 3.0 语言模型在原始性能上展示出良好的结果。
在 Hugging Face 的 OpenLLM 排行榜定义的标准学术基准测试中,Granite 3.0 8B Instruct 模型的整体性能平均领先于 Meta 和 Mistral 中类似大小的开源模型的最先进性能。在 IBM 的先进 AttaQ 安全基准测试中,Granite 3.0 8B Instruct 模型在所有测量的安全维度上均领先于 Meta 和 Mistral 的模型。
在检索增强生成(RAG)、工具使用和网络安全领域的核心企业任务中,Granite 3.0 8B Instruct 模型的平均表现优于Mistral 和 Meta 中类似规模的开源模型。
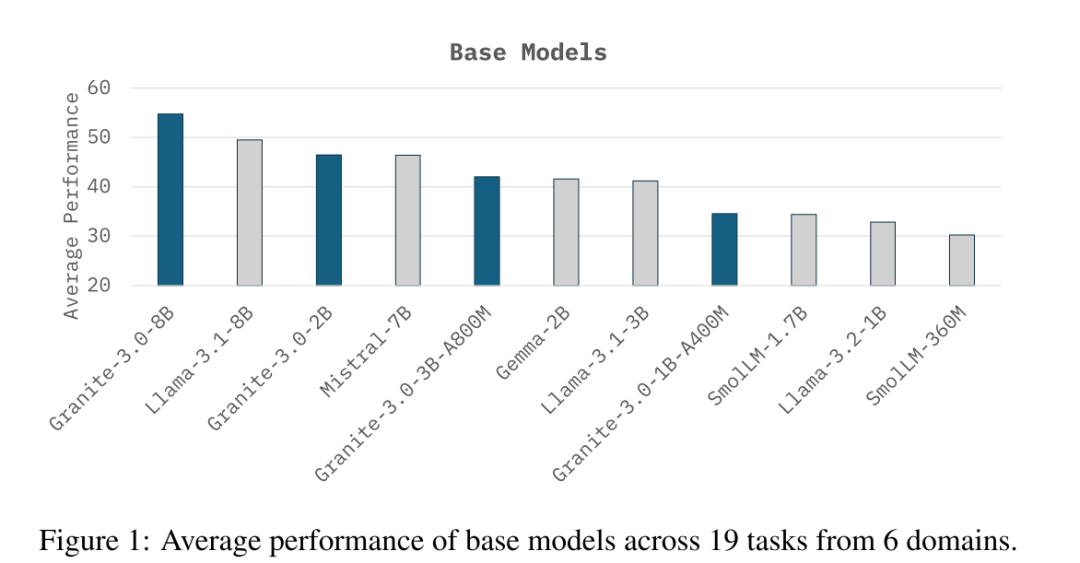
图:基础模型在6个域的19个任务中的平均性能
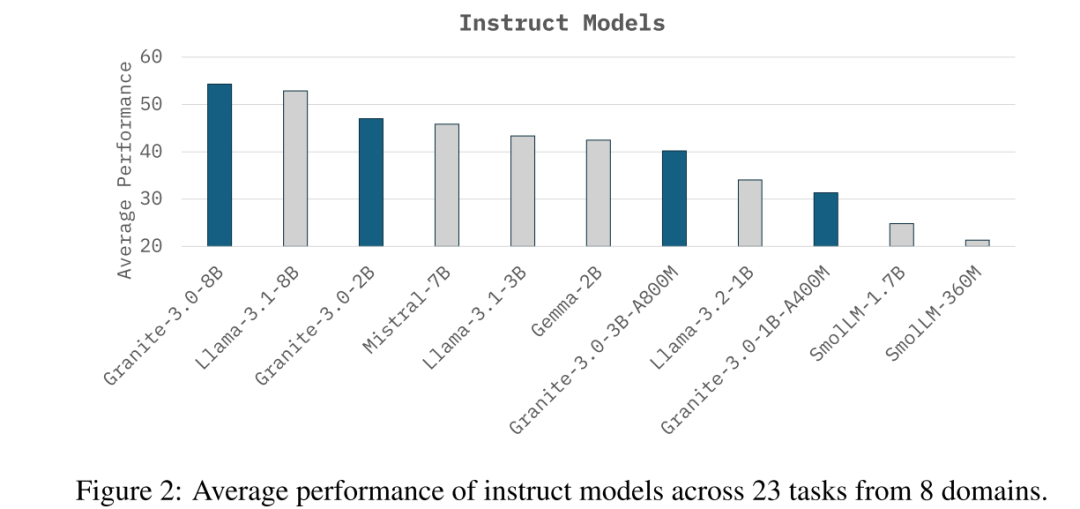
图:指令模型在8个域的23个任务中的平均性能
-
训练数据集方面
Granite 3.0 模型是在超过 12 万亿个标记上进行训练的,这些数据来自 12 种不同的自然语言和 116 种不同的编程语言,采用了一种新颖的两阶段训练方法,利用了数千个旨在优化数据质量、数据选择和训练参数的实验结果。到今年年底,预计 3.0 8B 和 2B 语言模型将支持扩展的 128K 上下文窗口和多模态文档理解能力。
-
推理成本方面
IBM 展示了性能和推理成本的完美平衡,提供了其 Granite 专家混合(MoE)机构模型,Granite 3.0 1B-A400M 和 Granite 3.0 3B-A800M,这些较小且轻量级的模型可用于低延迟应用程序以及基于 CPU 的部署。
IBM 还宣布了其预训练 Granite 时间序列模型的更新版本,早期版本于今年早些时候发布。这些新模型在 3 倍的数据上进行训练,在所有三个主要时间序列基准测试中表现出色,超越了来自 Google、Alibaba 等公司 10 倍更大模型的性能。更新后的模型还提供了更大的建模灵活性,支持外部变量和滚动预测。
02 · Granite3.0模型试用
1 · 如何使用Granite 3.0模型
1. 打开您的网络浏览器并导航到 Hugging Face 网站(国内中文镜像网站链接:https://hf-mirror.com/ )。
2. 安装 Hugging Face Transformers Library,该库提供了使用 LLMs。
3. 在页面顶部的搜索栏中,键入“Granite 3.0”,然后按 Enter。这将显示可用 Granite 3.0 型号的列表。
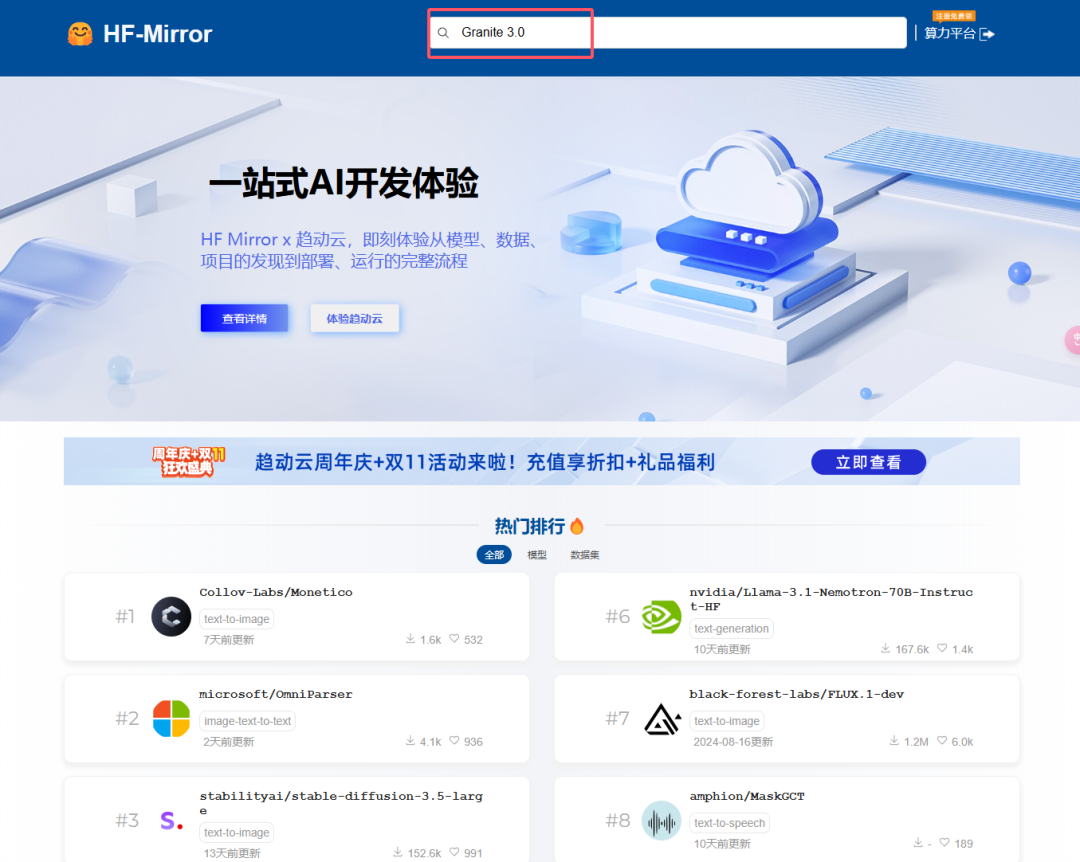
4. 选择要下载的 Granite 3.0 模型。
5. 单击模型的名称以转到其页面。
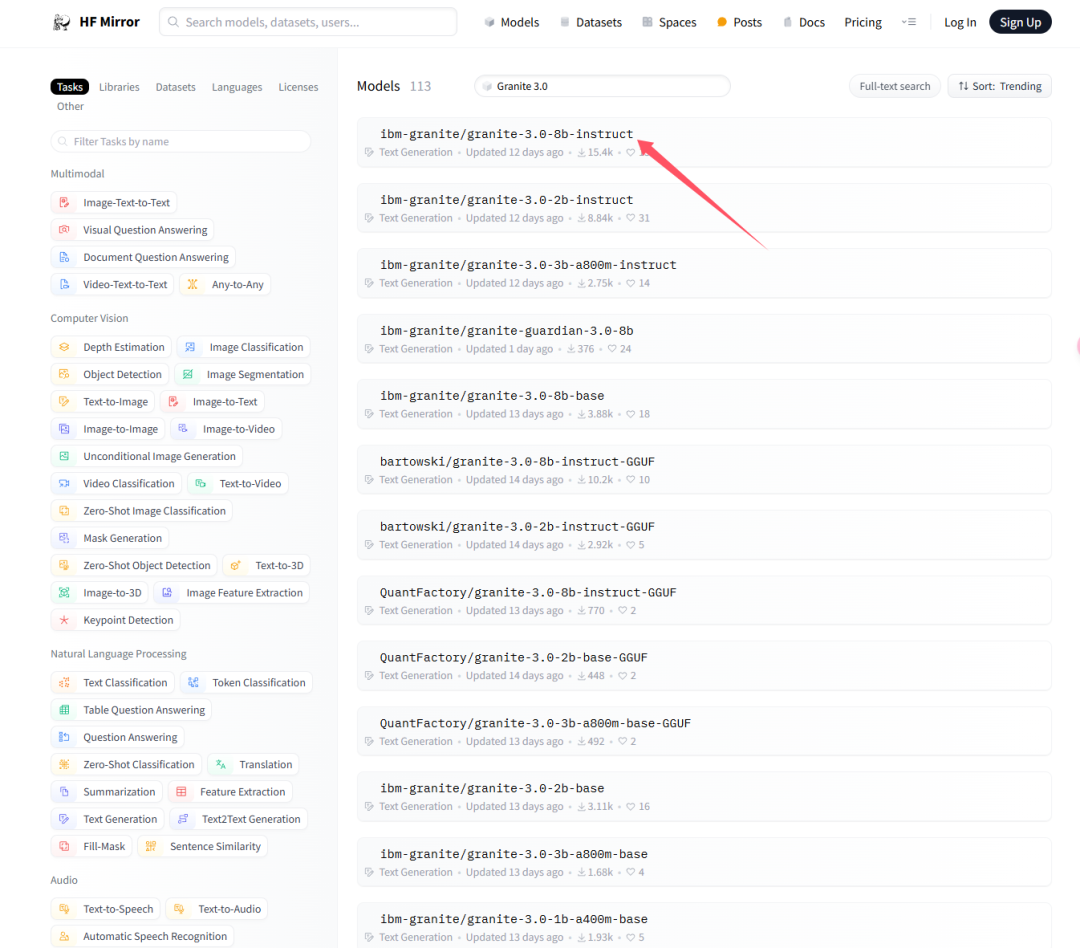
这里选择Granite 3.0 8B Instruct进行试用。
6. 单击“使用此模型”并下载到相应的库。
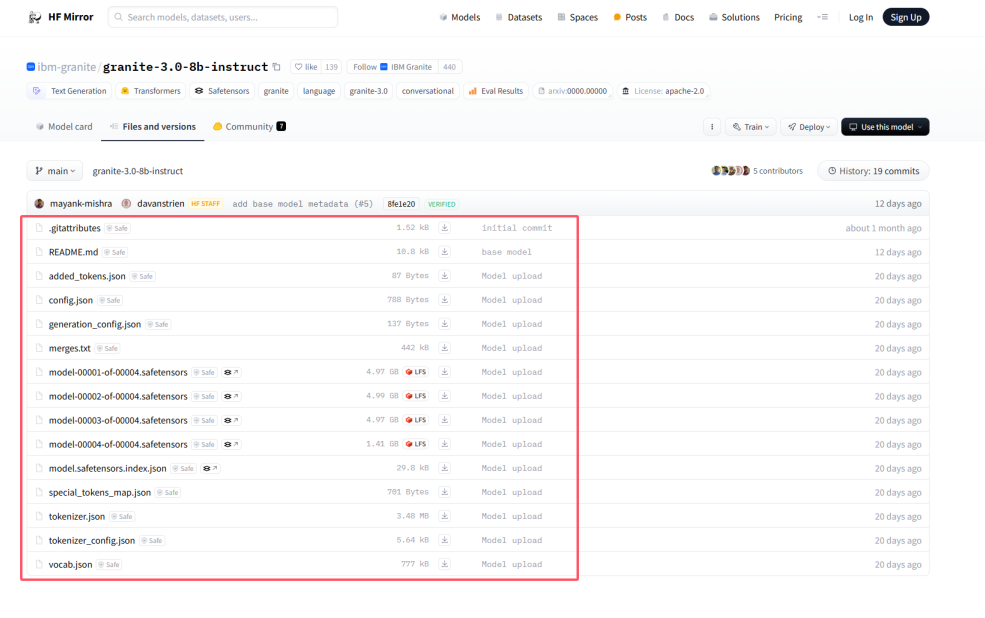
下载官方已经训练好模型的参数。(模型参数地址:https://hf-mirror.com/ibm-granite/granite-3.0-8b-instruct/tree/main)
另外Granite 3.0支持的语言有:英语、德语、西班牙语、法语、日语、葡萄牙语、阿拉伯语、捷克语、意大利语、韩语、荷兰语和中文。用户可以针对这 12 种语言以外的语言微调 Granite 3.0 模型。
- 运行示例1:Please list one IBM Research laboratory located in the United States. You should only output its name and location.
答:IBM Almaden Research Center - San Jose, California

- 运行示例2:过年有哪些旅游目的地推荐?
答:过年是中国最重要的传统节日,各地都有独特的旅游目的地推荐。例如,北京的天坛、上海的长城、广州的清真寺等都是很受欢迎的旅游景点。

7. 选择与您的开发环境兼容的格式。
8. 将文件保存到您的计算机。
03 · Granite3.0模型的潜在助力
1 · Granite 3.0模型对企业的帮助
通用语言模型:
Granite 3.0语言模型提供了不同规模的语言模型,有参数量为80亿的大型语言模型和参数量为20亿的中等规模的语言模型,企业可以针对实际业务需求选择大型或者中等规模的模型投入实际运用。
另外,Granite 3.0 8B Base参数量为80亿,没有经过特定任务的调优,适合大型企业或有特殊需求的企业进行深度定制,开发出符合自己业务特点的应用程序。Granite 3.0 2B Base相较于8B Base,2B Base的成本更低,更适合预算有限的企业,虽然参数量较少,但在常见的文本处理任务上表现依然优秀,能够满足大多数企业的基本需求。
护栏与安全模型:
护栏与安全模型不仅保护企业免受潜在的安全威胁,还确保企业在使用先进技术和数据处理过程中遵守相关法律法规。利用护栏与安全模型可以提供核心的加密、访问控制和审计的功能,提供全面的安全防护和合规支持。综上,Granite 3.0的安全模型可以为企业的数据安全提供强有力的保障,可以以Granite 3.0的安全模型为基础进一步开发高价值的收费产品。
专家混合模型:
专家混合模型(Mixture of Experts, MoE)是一种通过组合多个专家模型来提高整体模型性能的技术。这种模型在处理大规模数据和复杂任务时表现出色,能够显著提升预测准确性和计算效率。
专家混合模型适用于需要专业知识的任务,如金融分析、法律咨询等,用可以针对特定企业用户的业务需求投入专业数据进行训练。
2 · Granite 3.0模型落地企业的部署步骤
(1)明确需求:
确定企业希望通过部署Granite 3.0解决的具体问题或达成的目标,如提高数据处理效率、增强安全性、优化客户体验等。评估现有的硬件和软件资源,确定是否需要额外的投资或升级。
(2)选择合适的版本
通过上述需求从通用语言模型、护栏与安全模型、专家混合模型中选取适合的模型,并且需要根据实际的数据规模选择合适的模型参数量。
(3)硬件资源与环境准备
企业需要确保有足够的计算资源(如CPU、GPU、内存)来运行Granite 3.0模型。确保网络带宽和稳定性,特别是对于分布式部署和远程访问的情况。
确保服务器运行的操作系统兼容Granite 3.0的要求。安装必要的依赖库和工具,如Python、TensorFlow等。
(4)模型部署与集成
从Hugging Face官方渠道下载选定的Granite 3.0模型。按照官方文档进行模型的安装和配置,用业务对应的数据完成对模型的训练或者微调。将Granite 3.0的API与现有的业务系统进行对接,确保数据流畅传输。
(5)测试与验证
结束集成后,需要对对每个功能模块进行单元测试,确保其按预期工作。测试模型的性能指标,如响应时间、吞吐量等。进行端到端的集成测试,确保各个模块协同工作,没有兼容性问题。
04 · Granite3.0模型与其他模型对比1 · 模型架构方面
-
Granite 3.0
架构类型:Granite 3.0 是一个基于 Transformer 的大规模语言模型。Transformer 架构通过自注意力机制(self-attention)有效地处理长依赖关系,使得模型在处理长文本时表现优异。
参数量:Granite 3.0 有多个版本,其中 Granite-3.0-8B 拥有80亿参数,是一个非常大的模型。此外,还有 Granite-3.0密集 版本,通过优化模型结构和训练方法,提高了性能。
优化技术:Granite 3.0 引入了多种优化技术,如稀疏注意力机制、混合精度训练等,以提高训练效率和模型性能。
其他模型:
· BERT:基于 Transformer 的双向编码器表示,主要用于自然语言理解任务。参数量通常较小,如 BERT-base 有1.1亿参数,BERT-large 有3.4亿参数。
· GPT:基于 Transformer 的自回归语言模型,主要用于文本生成任务。GPT-3 拥有1750亿参数,是目前最大的公开语言模型之一。
· RoBERTa:改进版的 BERT,通过更多的训练数据和更长的训练时间提高了性能。
· T5:基于 Transformer 的预训练模型,使用前缀条件化(prefix conditioning)技术,支持多种自然语言处理任务。
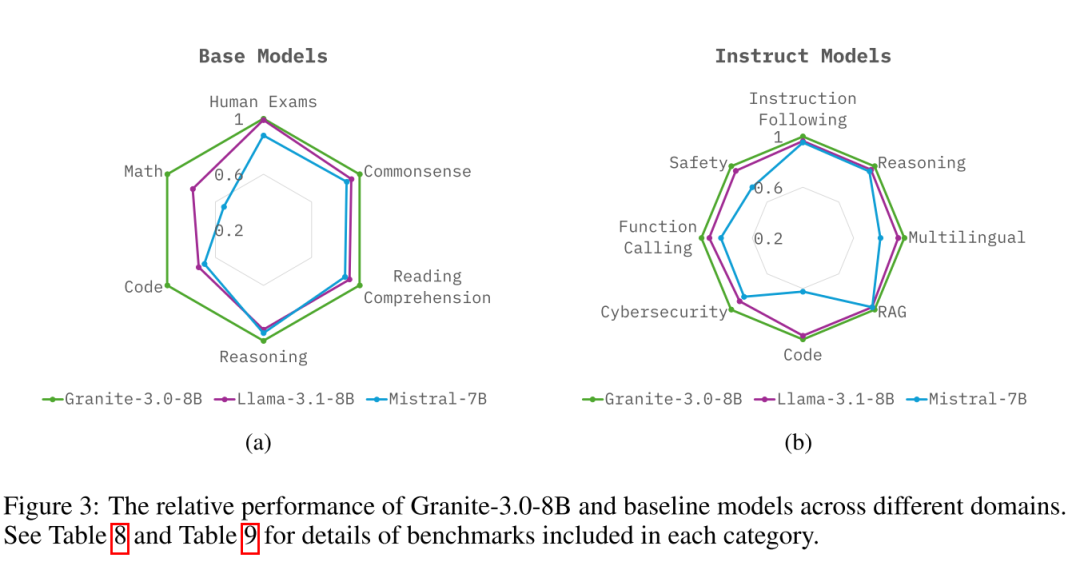
图:Granite-3.0-8B和基线模型在不同领域的相对性能
2 · 训练数据方面
-
Granite 3.0
数据量:Granite 3.0 使用了大量的高质量训练数据,涵盖了广泛的领域和主题。高质量的数据有助于模型学习到更丰富的语言模式和知识。
数据多样性:训练数据包括文本、代码、对话等多种类型,使得模型在多种任务中表现出色。
其他模型
· BERT:训练数据主要来自 Wikipedia 和 BookCorpus,总共有16GB的文本数据。
· GPT:训练数据来自 Internet,包括网页、书籍、新闻等多种来源,数据量更大。
· RoBERTa:使用了更大的训练数据集,包括 Common Crawl 和其他来源,数据量约为160GB。
· T5:训练数据来自 C4 数据集,这是一个从 Common Crawl 清洗后的数据集,数据量也非常大。
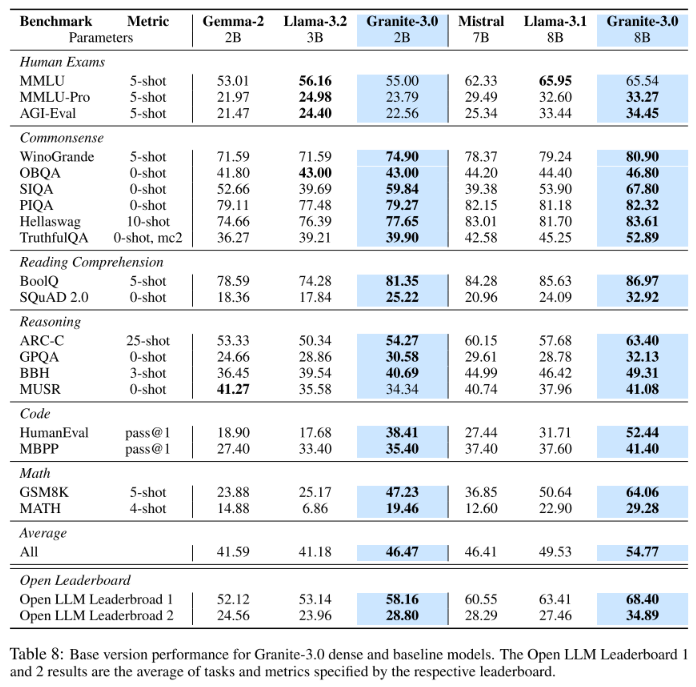
图:Granite-3.0密集和基线模型的基本版本性能
3 · 应用场景方面
-
Granite 3.0适用于:
1.内容创作:适用于文章生成、创意写作等任务。
2.智能客服:适用于构建对话系统和智能客服。
3.机器翻译:适用于跨语言文本翻译。
4.情感分析:适用于社交媒体监控、用户评论分析等。
其他模型
· BERT:适用于自然语言理解任务,如情感分析、命名实体识别等。
· GPT:适用于文本生成任务,如文章生成、创意写作等。
· RoBERTa:适用于自然语言理解任务,特别是在需要高精度的任务中。
· T5:适用于多种自然语言处理任务,特别是在需要多任务学习的场景中。
4 · 对Granite 3.0模型分析的总结
Granite-3.0 模型,无论是 8B 版本还是密集版本,都在多个任务和领域中展示了卓越的性能。特别是 8B 版本,凭借其大规模参数和高质量训练数据,能够在复杂任务中取得显著优势。而密集版本则在相同的参数量下,通过优化结构和训练方法,提高了模型的效率和性能,适合需要高性能和快速响应的应用场景。
Granite-3.0 模型在多个方面超越了基线模型,为自然语言处理任务提供了更强大的工具和支持。
Granite 3.0 模型在多个方面展现了其优越性,特别是在大规模参数、高质量训练数据、优化技术和多任务性能方面。与传统模型相比,Granite 3.0 在复杂任务和多样化数据中表现出更强的适应性和更高的性能。然而,这也带来了更高的计算资源需求。
参考文献与资源链接
[1] IBM 推出 Granite 3.0:专为企业打造的高性能AI模型.文章链接:https://china.newsroom.ibm.com/2024-10-22-IBM-Granite-3-0-AI
[2] IBM Granite 3.0体验.文章链接:https://www.ibm.com/granite
[3] Huggingface的国内官方镜像网站.资源链接:https://hf-mirror.com/
[4] IBM Granite 3.0官方训练完成后的模型参数下载地址.资源链接:
https://hf-mirror.com/ibm-granite/granite-3.0-8b-instruct/tree/main
[5] IBM Granite 3.0模型使用教程.资源链接:
https://hf-mirror.com/ibm-granite/granite-3.0-8b-instruct
[6] Granite 3.0的论文链接.资源链接:
https://github.com/ibm-granite/granite-3.0-language-models/blob/main/paper.pdf
作者 | 李文婷
本文转载自久章智能微信公众号(原文发布于 2024-11-28),内容保持原貌。扫码关注公众号「久章智能」,第一时间获取智能决策系列文章。阅读原文 ↗