【摘要】解决车辆路径问题(VRP)是许多工业应用的一项重要任务。尽管VRP传统上是在运筹学(OR)领域进行研究的,但最近它们已成为机器学习(ML)社区广泛工作的主题。OR和ML社区都开始将ML整合到他们的方法中,但方式截然不同。虽然OR社区主要依赖于简单的ML方法,但ML社区通常使用深度学习,但无法超越OR基线。为了解决这一差距,EURO Meets NeurIPS 2022车辆路线竞赛汇集了OR和ML社区,这是之前几场竞赛的共同努力,旨在解决由领先的车辆路线软件提供商ORTEC提供的现实世界数据上具有挑战性的VRP变体。挑战集中在具有时间窗口的“经典”确定性VRP(VRPTW)和新订单在一天内到达的动态版本上。超过50个团队在13周的提交时间内提交了解决方案,不仅在竞赛问题上争取最佳表现,而且还在争夺排行榜的最长统治地位。竞赛的目标已经实现,运筹学和最新技术在几个获奖作品中都发挥了重要作用。
【关键词】机器学习、组合优化、随机优化、带时间窗的车辆路径问题、动态调度问题
*详情可点击文末左下角“阅读原文”
全文共计:8588字
预计阅读:14-22分钟
01 · 介绍
每天,数以百万计的卡车和其他车辆在全球各地执行交付或服务。为这些车辆找到最佳路线对于公司降低成本和环境影响至关重要。车辆路径问题(VRP)是著名的旅行商问题(TSP)的推广,因此一直是重要研究活动的焦点。在VRP中,目标是为一组车辆和一组客户找到路线,这样每个客户都会被其中一辆车访问一次,并且行驶的总距离(或产生的旅行成本)最小化。文献中已经对VRP的许多扩展进行了研究(Vidal等人,2020),例如,包括时间窗口(称为VRPTW),它要求在特定时间段内向客户交付,以及随机变量(例如,客户之间的旅行持续时间不确定)或随时间变化的动态变量(Pillac等人,2013)。
VRP传统上是在运筹学(OR)领域进行研究的,解决方法主要依赖于使用精确方法或启发式方法搜索可行解的空间(Laporte等人,2014; Poggi和Uchoa,2014; Costa等人,2019)。近年来,该问题也引起了机器学习(ML)研究人员的关注(Nazari等人,2018;Kool等人,2018,Kwon等人,2020;Hottung等人,2020,Xin等人,2021b;d O Costa等人,2020),da Costa等人,2021,Xin等人,2021a;Kool等人,2022b;Bai等人,2021;Choo等人,2022),他们开发了各种使用深度神经网络(DNN)的方法,通过最优解或使用强化学习。虽然这些技术在针对特定问题的组件和通用搜索方案方面有所不同,但它们中的大多数目前都没有超越最先进的OR解决方案策略,OR解决方案战略通常基于快速局部搜索,并采用额外的元启发式策略来指导对解决方案空间的探索。
ML和OR社区在车辆路径问题上的工作进展截然不同,有时使用不同的解决方案评估实践、硬件和基准,对速度和解决方案质量的强调不同,对面向应用程序的工作和面向方法的工作有不同的观点。鉴于此,EURO Meets NeurIPS 2022车辆路线竞赛旨在将两个社区团结起来,共同解决相同的路线问题和基准,从而促进地区之间的异花授粉。该比赛是VeRoLog比赛的共同努力(Gromicho等人,2019年),欧洲车辆路径和物流优化工作组(VeRoLog),IJCAI AI 4TSP竞赛(Zhang et al.,2023)的EURO数据科学工作组满足优化(DSO),以及DIMACS实施挑战(Archetti等人,2021)由离散数学和理论计算机科学中心(DIMACS)组织。比赛涉及解决VRPTW的静态和动态版本,目标是为OR和ML社区提供利用学习算法和高级方法的机会。除了前三场比赛外,最近其他相关比赛的例子是亚马逊最后一英里路线挑战赛(Merch´an等人,2022)和CEC-12电动汽车路线问题比赛(Mavrouniotis等人,2020)。
本文概述了竞争和经验教训。我们在第2节中定义了竞争问题,在第3节中描述了赛程设置,在第4节中总结了决赛团队的方法,第5节讨论了最终结果,第6节进行了回顾。
02 · 问题陈述
长期以来,VRPTW一直是运筹学研究人员(Kallehauge等人,2005年)的重点,因为它出现在多种应用环境和问题变体中,例如家庭医疗路由(Fikar和Hirsch,2017年)、技术员路由(Paraskevopoulos等人,2017年)和集成卡车-无人机送货(Chung等人,2020年)。我们选择了VRPTW及其动态变体进行竞争,因为这些问题是规范的,易于建模,但由于客户访问的时间窗口限制和车辆的容量限制,寻找低成本的解决方案具有挑战性。除此之外,VRPTW的静态和动态版本没有得到机器学习社区的大量工作,这使它们成为使机器学习社区更接近现实世界应用程序并鼓励OR社区使用更先进的机器学习方法的主要目标。在下文中,我们将VRPTW形式化,从标准(静态)版本开始,然后是其动态变体。
静态问题设置:VRPTW是容量限制VRP(CVRP)的一种受限变体,其中每个客户都要求在指定的时间间隔内交付,称为时间窗口。静态问题的定义如下。本次竞赛中考虑的VRPTW问题实例由n个地点(一个仓库和一组n-1个客户)、一个n×n矩阵D组成,该矩阵指定了在每对地点之间行驶的时间(以秒为单位)(它表示实际的道路行驶时间,以秒为单位,既不是欧几里德也不是对称的)、每个客户i的产品需求量qi以及车辆可以携带的最大数量Q,也称为车辆的容量。
由节点i表示的每个客户还具有服务持续时间si和时间窗口[ei,li],其中ei<li,服务/交付必须在该时间窗口内开始,si表示为客户i提供服务所需的时间。允许车辆在时间窗口开始之前到达客户所在地,但必须等到交付窗口开始才能开始交付。时间窗口关闭后无法开始交付。通过这种方式,竞争对手将时间窗口约束视为硬约束。可用车辆的数量没有限制。
VRPTW的一个可行解决方案包括一组在停车场开始和结束的路线,这样每个客户在指定的时间窗口内都可以在一条路线上访问,并且分配给一条路线的总需求不超过车辆容量Q。目标是找到一个可行的解决方案,最大限度地减少所有路线的总驾驶时间。请注意,车辆数量、服务时间和等待时间不是本次比赛的目标。该问题定义遵循最近DIMACS VRPTW挑战中使用的惯例,除了矩阵D不是欧几里德矩阵,车辆数量是无限的。通过这些约定,即使在动态环境中,问题的可行性也得到了保证(见下一节)。
动态问题设置:对于问题的动态变体,请求在一天中到达不同的一小时时段。求解器可以选择在当前时间段中分派哪些请求,必须为哪些请求创建可行的路由,以及推迟到哪些请求与稍后可能到达的新请求合并。有些请求是“必须执行”的请求,必须在当前时间段内发送,因为将它们延迟到下一个时间段将使它们的时间窗口不可行。在最后一个时间段中,所有请求都必须执行。从静态VRPTW实例的数据中,对每个时间段的请求的位置、需求、服务时间和时间窗口进行统一采样,然后过滤具有不可行时间窗口的请求。
03 · 大赛详情
比赛分为资格赛阶段和最后阶段,资格赛阶段的前10名参赛作品将在100个隐藏测试实例上进行测试。在资格赛阶段,结果将显示在公共排行榜上。在资格认证阶段,静态问题的提交时间限制为3至8分钟,具体取决于实例的大小,动态问题的每个时间段时间限制为1分钟。在最后阶段,这个时间限制分别增加到每个时间段5到15分钟和2分钟。
在快速入门存储库中,提供了一个包含250个静态VRPTW实例的公共数据集。这些是ORTEC提供的真实实例,使用了来自美国一家食品配送服务公司的匿名数据。这些实例包含200到900个客户。根据这些静态实例,环境通过在5到9个时间段内从静态客户集中采样100个请求(之后过滤具有不可行时间窗口的请求)来创建动态实例,具体取决于实例。公共实例和提供的环境可用于开发求解器或训练机器学习模型。
所有实例均按照LKH3使用的惯例以VRPLib格式提供。由于静态问题是动态问题的特例,因此使用相同的协议对求解者进行静态和动态问题变体的评估。对于这个协议,我们使用了一个用Python实现的环境,该环境遵循OpenAI gym接口(Brockman等人,2016)。在这里,环境接受一个动作并返回一个观察结果、一个奖励、一个指示环境是否完成的标志,以及额外的信息。这个术语来自强化学习,在强化学习中,求解器可以被视为与环境交互的代理。在这个术语中,观察定义了每个时期的VRPTW/请求选择问题,动作是定义一组调度路线的解决方案,奖励是该时期解决方案(一组调度的路线)的成本(驾驶持续时间)的负值。解决一个问题直到完成(有多个时期)可以被称为环境的一个插曲。
3.1基线
我们为参与者在开发求解器时提供了一些基线。
静态基线:作为静态变体的基线,我们提供了混合遗传搜索(HGS)算法的实现(Vidal等人,2012;Vidal,2022),该算法将遗传算法与局部搜索相结合。HGS及其扩展已被用于为许多车辆路线问题变体产生最先进的结果(Vidal等人,2013,2014; Vidal,2022)。具体来说,我们提供的基线是Kool等人(2022a)使用的HGS-CVRP的扩展(Vidal,2022)赢得DIMACS实施挑战的VRPTW轨道,因此可以被认为是最先进的。该实现使用了Vidal等人(2013)的策略。通过搜索有效地评估时间窗约束。此外,与HGS-CVRP相比,它还包括Nagata等人(2010)的额外交叉。人口和社区规模管理的动态参数,以及一些代码优化。
动态策略:到目前为止,使用HGS解决的所有车辆路线变体都是静态的。在我们的情况下,扩展一个静态求解器来处理所需的动态请求,选择在任何给定的时间段上应该服务哪些请求。这样的扩展并非易事,需要额外的客户选择策略。
为了选择在每个时间段中要分派的请求,我们在快速启动代码库中提供了三个初始的简单策略:(1)贪婪:每个可用的请求都将在当前时间段内被分派。这意味着所有请求都包含在HGS路由优化中;(2) 懒惰:只会发送必须发送的请求。必去请求是不能因为违反时间窗(由环境指示)而被延迟到下一个时间段的请求;以及(3)随机:随机选择要在当前时间段中调度的请求:以50%的概率独立地调度每个请求。请注意,为了获得可行的解决方案,必须提交的请求将始终包含在内。
此外,在比赛期间,我们使用机器学习增加了两条额外的基线:(1)监督:使用甲骨文求解器(使用未来信息)创建示例,以训练神经网络来预测甲骨文发送的请求,以及(2)DQN:使用强化学习训练深层Q网络(DQN)(Mnih等人,2013)代理,通过与环境重复交互来选择请求。机器学习基线仅用于说明目的,并没有超越贪婪基线。这些基线共同提供了初步的比较结果,并被列入公共排行榜,但不是作为官方参与者。
3.2评分和提交系统
团队被要求提交可以在给定实例的情况下生成解决方案的代码:例如,手工设计的启发式算法,或用强化学习训练的策略。这允许我们在隐藏的测试实例上测试提交的代码,我们使用这些测试实例来根据这些实例上的解决方案质量来确定最终的赢家。如问题陈述中所述,每个实例的得分计算为所有车辆行驶的总时间(即不包括服务或等待时间)。鉴于此,较小的分数更可取。
对所有团队的静态问题的隐藏实例和所有团队的动态问题的隐藏实例的每个实例的得分进行平均,从而导致对这两个问题变体的团队进行单独的排名。然后,对每支队伍的两个排名进行平均,得出每支队伍在整个比赛中的最终排名。这确保了无论实际分数如何,这两个问题的权重都是相等的。如果平局,则将分数本身取平均值,而不是排名。
为了启用代码提交,我们使用了Codalab Competition平台,并在快速入门存储库中为参与者提供了说明。代码在基于Dockerfile的Apptainer/Singulity容器内执行,以确保为所有参与者提供相同的环境,以便他们可以重现以进行测试。该环境有一个CPU内核(Intel(R)Xeon(R)Gold 5118 [email protected])、一个GPU(Nvidia TitanRTX 24GB)和32GB RAM。
3.3奖品
我们为获奖者提供了以下奖项,总计超过5000 €。
1. 最佳表现:2022/750/500 € 排名第一/第二/第三
2. 评审团奖:250 €
3. 青年才俊奖:250 €
4. 排行榜奖品:总计1300 €
根据第3.2节所述的决赛隐藏数据集排行榜标准,对前三名奖项进行评分。为了进一步鼓励创新想法,即使它们没有带来最佳表现,组织者也会酌情将“评审团奖”授予一种提供新颖方法论想法的方法。对于这个奖项,我们寻求一种方法:(1)提供了一种新颖的解决方案;(2)使用了机器学习;(3)在规定时间内取得了良好的性能;(4)没有获得第一名。
“青年才俊奖”授予仅由学生和/或博士生组成的表现最佳的团队。最后,排行榜奖金为50/30/20 €,每周颁发给排行榜上1/2/3的数字,以鼓励早期竞争。
04 · 团队贡献总结
每个决赛团队都在一篇短文中描述了他们的方法,并在最后的研讨会上进行了介绍(见第6节)。论文和演示幻灯片均已发布在比赛网站5上。我们在这里概述了决赛选手的贡献。
Kleopatra Jungel et al. (2022):通过减少一些随机化步骤并在本地搜索迭代中为不变的路由实现缓存机制,改进了静态变体的HGS。对于动态问题,他们实现了一种可参数化的HGS(PC-HGS)奖品收集变体,该变体根据一组奖品来联合优化调度请求和路由的选择,这些奖品表示当前时代调度请求的偏好。最优奖励是先验未知的,但机器学习模型被训练来预测奖励,使用损失函数来鼓励PC-HGS结果接近预期的预言解决方案(见基线)。
OptiML vanDoornetal.(2022):通过删除Kool等人(2022a)引入的有序交叉、初始结构和不断增长的社区/人口组成部分,简化了基线人类基因组系统的实施。中所示。他们在父级选择步骤中添加了多样性标准,对本地搜索进行了代码优化,并对参数进行了广泛调整。对于动态问题,他们的方法模拟了未来请求的多种场景,为此,他们使用求解器作为oracle优化了路由(见基线)。在模拟中经常与必去请求结合的May-go请求也被标记为“必去”,并且这个过程会重复几次,以定义要分派的最终请求集。然后使用静态求解器优化该集合,并分派所有具有至少一个(原始)必须执行请求的路由。
Team SB Kwon et al. (2022):调整了HGS参数,并将二元锦标赛推广到k路锦标赛,其中k自动调整,以便如果最近找到新的最佳解,则更频繁地选择更高适应度的个体。此外,为了鼓励多样性,在产生一定数量的后代和温暖的重启机制后,将个体从种群中移除。动态变体使用了两个神经网络:一个用于预测请求的优先级,另一个用于选择必须分派的请求。这些用于HGS算法,具有修改后的目标,可以选择请求,根据额外距离权衡优先级。这两个网络都是使用强化学习进行训练的。
HustSmart Li et al. (2022):将EAX交叉添加到HGS中,并添加了SISR算法,以便在每次找到新的最佳解决方案时对解决方案进行优化。对于动态问题,他们为每个请求计算一个启发式定义的惩罚分数,并使用OR工具来解决VRPTW,同时允许以惩罚为代价放弃访问。这导致了一组请求,然后使用HGS算法对这些请求的路由进行了进一步优化。
Miles To Go Before We Sleep Reese et al. (2022):针对静态问题对HGS代码进行了多次性能改进,并在不同的训练实例子集上调整了参数。对于问题的动态变体,他们实现了两种启发式方法,用于根据请求与必须执行的订单的(基本)关闭程度来选择要发送的可能执行订单的请求。使用HGS对给定选择的路线进行优化。
ORBerto Hood Hildebrandt et al. (2022):针对问题的静态变体调整了HGS参数,并在一组采样的未来场景中优化了动态变体的调度请求集。为此,他们定义了一个考虑所有场景的单一集成问题,并使用列生成过程解决了该问题。使用HGS优化了结果请求集的路由。
HowToRoute Mesa et al. (2022):降低了强化过程的频率,并在HGS算法中实施了调整后的交叉。对于动态变体,他们发送了接近必去请求的可能去请求,并使用HGS找到了解决方案。然后,如果这降低了路由中请求的平均成本,他们应用了一种方法从路由中删除可能的请求(将被推迟)。使用HGS进一步优化了最终选择。
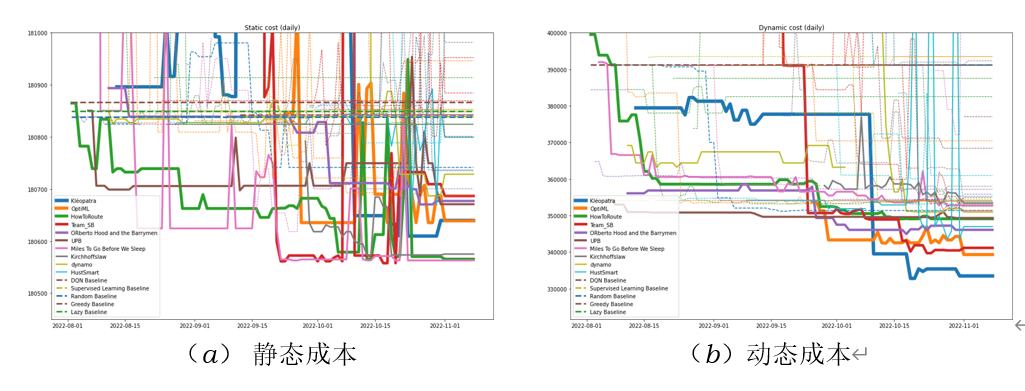
图1:比赛资格赛阶段的静态和动态结果
Kirchhoffslaw Ao and Zong (2022):针对问题的静态变体调整了HGS参数,并使用强化学习训练了一个神经网络,以选择动态变体的调度请求。操作对应于是否应该选择订单,最终奖励是通过将每个时期对所选请求运行HGS后的最终成本与贪婪基线方法的最终成本进行比较来计算的。
UPB Dieter (2022) :专注于问题的动态变量,并实施了一种后悔策略,该策略使用关于请求分布的可用信息来分析计算每个可走请求的遗憾值:当请求将被立即调度时,可能会错过的改进。遗憾值低于阈值的请求会立即发送,并使用HGS进行优化。
dynamo GhannamandGleixner (2022):为HGS增加了一个额外的HGreX交叉,以解决静态问题。对于动态变体,他们调整了HGS,允许在优化中包含一部分请求,其中以订单的平均成本(总驾驶时间除以请求数量)为目标。惩罚确保必须立即发出的订单,并支持额外的延迟条款,包括时间窗口提前结束的请求。
05 · 结果
图1显示了在资格赛阶段不同团队的静态和动态问题变体在公共排行榜上的结果。由于不同评估的结果可能略有不同,图表并没有严格减少,但对于这两种问题变体,随着比赛的进行,我们看到结果有明显的改善趋势。团队在静态和动态问题上的平均排名决定了排行榜上的整体排名,如图2所示。在比赛期间,排行榜上的参赛者人数稳步增加,一些决赛选手在资格赛阶段结束时才进入公共排行榜的前10名。
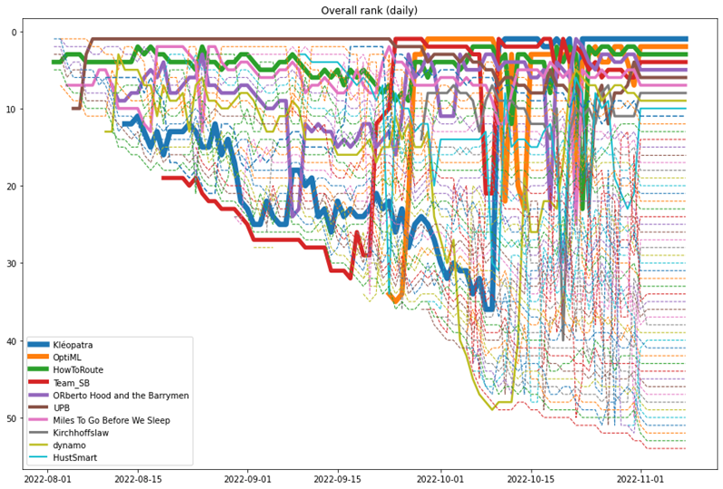
图2:比赛资格赛阶段的排行榜排名
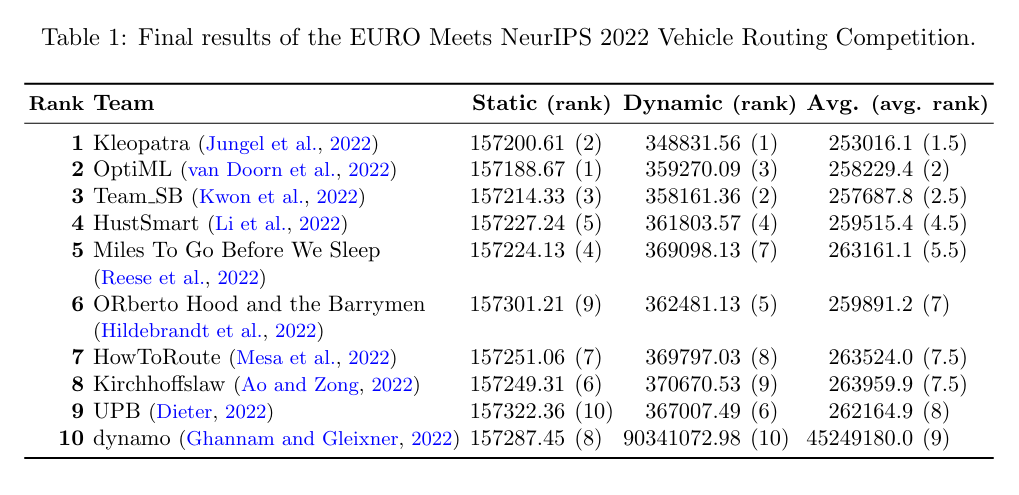
公共排行榜的前10名确定了决赛选手,在比赛的最后阶段对他们进行了全面评估。这是使用隐藏测试集完成的,它由100个实例组成,这些实例在静态和动态变体中都得到了解决,运行时间更长(见第3节)。表1显示了决赛选手的结果,其中团队根据他们在问题的静态和动态变体上的平均排名进行排名。Kleopatra队(Jungel等人,2022年)获得第一名,在动态问题上排名第一,在静态问题上排名第二,赢得2022欧元。OptiML团队(van Doorn等人,2022)在静态问题上排名第一,在动态问题上排名第三,总体排名第二,赢得了750欧元。SB队(Kwon等人,2022年)获得了第三名和500欧元,在静态问题上排名第三,在动态问题上名列第二。总的来说,我们观察到每个团队在问题的静态和动态变体上的表现之间存在很强的相关性,这表明团队能够在这两个问题之间很好地分配他们的努力。
评审团奖授予SB团队,因为他们使用基于机器学习的创新方法取得了优异的成绩。青年人才奖授予Kleopatra团队。最后,在资格认证阶段进入公共排行榜前三名的排行榜奖项授予了UPB、Kleopatra、SB、4pd vrp和OptiML团队。
大赛期间使用的所有真实数据,包括用于最终评估的隐藏数据集,都已在大赛GitHub存储库的CC BY-NC 4.0许可证下提供。我们希望这个数据集将继续被用作现实世界的基准。出于可验证性和再现性的目的,用于最终评估的所有设置和决赛选手找到的单个解决方案。此外,还发布了求解器,以及复制最终结果表的笔记本。大多数决赛队伍都公布了他们的代码,该代码链接在比赛网站上。
06 · 回顾
最终,近150支球队通过网站注册,其中50支球队提交了最终参赛作品。在资格审查阶段,共提交了800多份意见书。180人加入了Slack工作区,在那里交换了大约4500条消息,因此这被积极用于与参与者进行交流。参与者包括来自运筹学和机器学习社区的研究人员,以及来自学术界的许多团队和一些行业参与者。与会者来自世界各地。
NeurIPS的总结研讨会于2022年12月7日以虚拟会议的形式举行。约有30人参加了比赛,其中包括比赛组织者和10支决赛队伍的成员。录音可在比赛网站上找到。
事后看来,静态问题的(现实世界)数据集包含许多实例,这些实例太小,无法在HGS基线上进行改进,因为最佳或接近最佳的解决方案总是能在短的CPU时间内找到。尽管如此,这部分挑战仍然带来了有益的方法和实践发展。特别是,在静态变体方面排名第一的团队OptiML开发的软件已发布为PyVRP,这是一种最先进的开源VRPTW求解器,可以很容易地从Python中使用。这将有助于机器学习研究人员在未来的车辆路线问题上建立和贡献最先进的OR求解器。
与静态变量相比,问题的动态变量在基线策略之外取得了非常显著的进展。所有最好的方法都将机器学习作为其获胜策略的关键组成部分。这表明,机器学习不仅在未来很有前景,而且已经可以在动态优化问题上与其他方法竞争。
有两个问题变量的动机,但根据参与者的组合表现对参与者进行评分,是为了奖励对两个变量都有效的多才多艺的方法,并确保努力既用于提高静态性能,又用于处理问题的动态方面。在实践中,大多数团队为这两种变体实施了特定的解决方案策略,在少数情况下,只调整了静态变体的基线算法参数。
从技术角度来看,Codalab平台使我们能够评估代码提交,但我们需要进行许多调整才能使其适用于我们的用例。由于我们的评估需要GPU,我们不得不连接我们自己的计算工作器,虽然Codalab提供了Docker映像来支持此使用情形,但它假设全天候运行专用工作器,这浪费了(GPU)计算资源,因为大多数时间提交队列将是空的。为了将提交作为共享计算机群集上的作业进行评估,我们必须1)切换到Apptainer/Singulity(因为Docker需要不可用的根权限),2)调整Worker脚本以在队列为空时终止,以及3)设置单独的外部监控脚本以在队列中有新提交时启动作业。
除了评估,还有一些额外的挑战:Codalab排行榜没有正确计算排名,因此我们发布了一个正确的排行榜,该排行榜将在我们自己的比赛网站上自动更新。未来,鉴于挑战的组合,我们将研究Kaggle或AICrowd等其他平台。尽管如此,带有实时排行榜的提交平台在比赛中发挥了至关重要的作用,参赛队伍告诉我们他们每天刷新页面多次。公开的结果鼓励团队在比赛初期表现更好,积极参与,排行榜奖是额外的激励措施。
07 · 结论
作为比赛的组织者,我们很高兴地看到,这次比赛成功地将AI和OR研究人员聚集在一起,产生了新的方法,推动了最先进的ML和OR技术,以解决VRPTW的静态和动态版本。此外,我们还提供了比赛中的实例,作为研究人员可以用来测试新方法的现实世界基准。所有开发的基线方法和许多参与者的实现也都是公开的。未来,组织团队将继续努力,将OR和AI社区聚集在一起,解决相关的现实世界优化问题。
致谢
我们要感谢ORTEC赞助了大部分奖金池,以及EURO VeRoLog和DSO工作组,他们为评审团和年轻人才奖提供了额外的支持。比赛中使用的计算基础设施由埃因霍温理工大学HPC实验室慷慨赞助。最后,我们要感谢EURO和NeurIPS会议在组织本次比赛时给予的支持。
*参考文献从略,详情可点击文末左下角“阅读原文”。
翻译 | 一者科技
本文转载自久章智能微信公众号(原文发布于 2025-02-25),内容保持原貌。扫码关注公众号「久章智能」,第一时间获取智能决策系列文章。阅读原文 ↗