离散优化问题广泛存在于物流调度、网络设计、资源分配等多个领域。根据问题的规模和复杂性,选择合适的解决方法至关重要。本文将离散优化问题的解决方法按照问题规模划分为四个部分:小规模优化问题的精确式算法、中规模优化问题的元启发式算法、大规模优化问题的启发式算法,以及动态优化问题的深度强化学习算法。每部分将详细介绍其定义、使用原因、具体方法及经典应用。
一、小规模优化问题与精确式算法
- 什么是小规模的问题
小规模问题指的是决策变量和约束条件数量相对较少,能够在合理的计算时间内通过系统性方法求解的离散优化问题。通常,这类问题的解空间较小,适合使用精确算法来寻找最优解。
- 为什么用精确式算法
精确式算法旨在保证找到问题的全局最优解。对于小规模问题,由于解空间有限,精确算法能够在可接受的时间内穷举所有可能性或通过有效的剪枝策略快速定位最优解。因此,使用精确算法能够确保解的质量,适用于对解的精度要求较高的场景。
3.精确式算法有哪些
分支定界法(Branch and Bound):通过系统地枚举所有可能的解空间,并利用上下界剪枝,减少需要考虑的分支数量。
动态规划(Dynamic Programming):将问题分解为子问题,保存子问题的解以避免重复计算,逐步构建出原问题的最优解。
整数规划(Integer Programming):在数学规划中将变量限制为整数,通过线性规划的扩展方法求解最优解。
4.经典的应用
旅行商问题(TSP):在小规模情况下,分支定界法能够有效找到最短路径。
背包问题:动态规划方法可以精确计算最大价值组合。
资源分配:整数规划用于确定最优资源分配方案,确保约束条件得到满足。
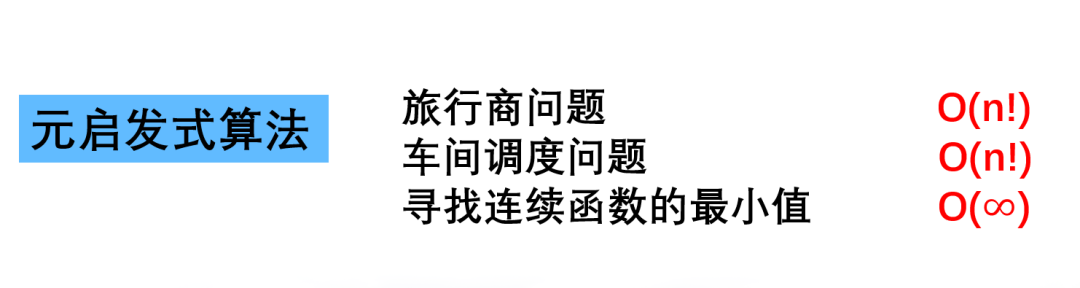
二、中规模优化问题与元启发式算法
- 什么是中规模的问题
中规模问题涉及较多的决策变量和约束条件,解空间较大,难以通过简单的精确算法在合理时间内求解。这类问题通常需要更高级的搜索策略来寻找高质量的近似解。
- 为什么用元启发式算法
元启发式算法结合了多种启发式策略,具有较强的全局搜索能力和灵活性,能够在复杂的解空间中有效探索,避免陷入局部最优。对于中规模问题,元启发式算法能够在合理的时间内找到接近最优的解,兼顾求解效率和解的质量。
3.元启发式算法有哪些
遗传算法(Genetic Algorithms):模拟自然选择和遗传机制,通过选择,交叉,变异等操作演化出更优的解。
禁忌搜索(Tabu Search):在局部搜索的基础上,引入禁忌表记录近期的搜索历史,避免重复访问和陷入局部最优。
蚁群优化(Ant Colony Optimization):模拟蚂蚁受食行为,通过信息素的积累和挥发引导搜索方向。
模拟退火(Simulated Annealing):模仿物理退火过程,通过控制"温度"逐步降低,允许接受劣质解以跳出局部最优。
4.经典的应用
调度问题:遗传算法和禁忌搜索常用于生产调度和任务分配,优化资源利用和工期。
路径规划:蚁群优化在交通路线优化和物流配送中表现出色,能够找到高效的路径方案。
图着色问题:模拟退火用于解决图着色问题,减少颜色冲突,提高着色效率。
车辆路径问题(VRP):元启发式算法能够有效处理多个车辆的路径优化,降低运输成本。
三、大规模优化问题与启发式算法
- 什么是大规模的问题
大规模问题涉及大量的决策变量和复杂的约束条件,解空间极其庞大,传统的精确算法和元启发式算法难以在合理时间内找到满意的解。此类问题通常需要快速生成可行解,尽管这些解可能不是最优的,但足以满足实际需求。
- 为什么用启发式算法
启发式算法具有高效性和可扩展性,能够在大规模问题中迅速生成可行解。虽然不保证找到最优解,但在实际应用中,启发式算法往往能够提供足够好的解,满足时间和资源的限制要求。
3.启发式算法有哪些
贪婪算法(Greedy Algorithms):每一步选择当前最优的局部选项,期望通过一系列局部最优选择达到全局最优。
局部搜索(Local Search):从一个初始解出发,通过在其邻域内搜索更优解,逐步改进。
启发式规则(Heuristic Rules):基于问题的特定结构设计启发式规则,引导搜索过程。
贪婪随机自适应搜索算法(GRASP):结合贪婪选择和随机化,通过多次迭代生成和改进解,寻找高质量的近似解。
4.经典的应用
最小生成树:贪婪算法如Kruskal和Prim算法能够高效生成最小生成树。
活动选择问题:贪婪算法用于选择最大数量的非重叠活动。
大规模调度:局部搜索和启发式规则用于快速生成可行的调度方案,满足时间和资源约束。
车辆路径规划:GRASP在车辆路径规划中能够高效生成和优化多车辆的配送路线。
四、动态优化问题与深度强化学习算法
- 什么是动态优化问题
动态优化问题指的是在问题求解过程中,环境或约束条件发生变化,需要实时调整策略以适应新的情况。这类问题通常涉及连续的决策过程,要求算法具备学习和适应能力。
- 为什么用深度强化学习算法
深度强化学习(Deep Reinforcement Learning, DRL)结合了深度学习和强化学习的优势,能够在复杂和动态的环境中通过与环境的交互学习最优策略。DRL具备较强的泛化能力和自主学习能力,适用于需要实时决策和动态调整的优化问题。
3.深度强化学习算法有哪些
深度Q网络(Deep Q-Network,DQN):结合Q学习与深度神经网络,能够处理高维状态空间,实现高效的策略学习。
策略梯度方法(Policy Gradient Methods):直接优化策略函数,通过梯度上升更新策略参数,适用于连续决策问题。
Actor-Critic方法:结合策略梯度(Actor)和价值函数(Critic),提升学习效率和稳定性。
迁移学习与多任务学习:利用在一个任务中学到的知识,提升在相关任务上的学习效率和性能,加快适应新环境的速度。
4.经典的应用
实时交通管理:DRL用于动态调整交通信号灯的配时,优化交通流量,减少拥堵。
动态资源分配:在云计算和网络环境中,DRL能够实时分配资源,优化系统性能和响应速度。
自适应供应链管理:根据市场需求和供应链变化,DRL算法能够动态调整供应链策略,提高效率和响应能力。
动态任务调度:在制造业和服务业中,DRL用于实时调整任务调度,适应突发事件和需求变化。
本文转载自久章智能微信公众号(原文发布于 2025-06-26),内容保持原貌。扫码关注公众号「久章智能」,第一时间获取智能决策系列文章。阅读原文 ↗