引言
设想这样一个场景:
你是某产业基金的投资经理。周一早晨九点到办公室,邮件里躺着上周末抄送过来的 6 份商业计划书,加上群里 FA 又转发了 2 份,待读清单一下子涨到 8 份。每份 PDF 平均 30 页,精读一份至少 1 小时,下午 3 点合伙人例会要给出“先跟哪三家”的初步意见。
你大概率会做这样几件事:先快速扫一眼摘要页,挑两份“看起来靠谱的”精读,其余的塞进“待办”文件夹里——然后下周一这堆里再加 8 份新的。
这种工作方式有三个明显的问题。
第一,绝大多数 BP 是没被认真读完的。通常一周看完 3-5 份就到顶了,剩下的全靠摘要页第一印象筛。
第二,跨行业项目没法客观排序。某智慧农业项目 Rating 81.9 分,某半导体上游项目 Rating 83.7 分,看似差不多,但赛道热度差很多,到底先跟谁?没标尺。
第三,基金匹配靠经验。项目推到对口基金能拿到 LP 引荐,推错了不仅没结果还伤 IR 关系——但匹配的判断完全在 IM 个人脑子里,离职就带走。
这套叫虚拟投资分析师的系统,就是为这三件事造的。
一、虚拟投资分析师是什么?
把“一份 BP 文件进 → 一份结构化分析报告 + 三维评分 + 推荐基金 + 赛道热度归类出”这条工作链路全自动跑完的虚拟投资分析师。
输入可以是 PDF 格式的 BP、PPTX 路演稿、文字描述、公司官网链接,或者一篇行业文章。输出是一份 6 维结构化报告(企业基本面 / 市场分析 / 经营数据 / 投资逻辑 / 估值 / 风险)+ 三维量化评分(基本面 40% + 基金匹配度 30% + 市场行业 30%)+ 1-3 个推荐基金 + 一级赛道归类与热度分,10 到 15 分钟交付。
它不会替你做投资决策——决策依然是人做的——但它能把“快速过一遍 + 给个初判 + 排个序”这件事从一小时压到十分钟。
二、3个最常被反馈的痛点,对应做了什么?
01 · BP看不过来,且AI写的报告未必能信
这是所有 IM 的一线痛。虚拟投资分析师的核心能力就是把 PDF/PPTX 在 10-15 分钟内变成一份结构化报告,6 个固定维度全部填齐,对齐到统一的 schema。
但只做到这一步还不够——市面上很多 AI 报告生成工具都能做到,问题是质量底线没保障。早期版本里也偶尔出现过这样的硬伤:
一份某硬科技标的的 BP 跑下来,AI 写的报告里出现了“累计申请专利 140 余项、授权发明专利 29 项”——但 BP 原文只提到核心技术专家个人持有的专利数(如某博士 5 项发明 + 数项国防专利),从未披露公司整体专利数量。
同一份报告里还把 BP 第 6 页明确披露的“产品直通率 >60%”写成了“当前直通率 >70%”,数字凭空涨了 10 个百分点。
这类“自信地胡编一个具体数字”是大模型最难根治的幻觉,也是 IM 在 deal flow 表里最不能接受的事。
虚拟投资分析师的解法是给报告生成 Agent 外裹一层异源评审——草稿出来后,由另一家厂商的模型(避免同源自评盲点)按 5 维 rubric(数据真实性 / 完整性 / 逻辑一致 / 基金相关度 / 格式)逐项核查,发现问题就把反馈打回去重写,最多 3 轮。
跑下来的一个真实例子:某新材料/智能硬件标的的 BP 在第 1 轮报告里出现两个硬伤:(1) 写“研发周期缩短 50% 以上”,但 BP 原文只写“研发周期缩短”未披露具体比例;(2) 写“已有某可穿戴产品和检测仪等产品上市”,但 BP 原文明确标注的是“样品展示”。第 2 轮按反馈重写后,两处全部修正——前者改成“研发周期显著缩短(BP 未披露具体比例)”,后者改成“已完成样机开发并展示,处于注册申报或临床验证阶段”。
真正交付到 IM 手上的报告,每个具体数字都能在原文里找到出处,而不是 AI 凭印象编的。
02 · 跨行业项目排序,单一 Rating 不够用
这是合伙人/老板的痛。Deal flow 里几十个项目,跨智慧农业、半导体、医疗器械、新材料、清洁能源等十几个赛道,下周例会要给个优先级。光看每个项目的"基本面 + 市场 + 匹配"加权 Rating 不够——80 分的清洁能源项目和 80 分的半导体项目根本不是一回事,赛道热度差很多。
虚拟投资分析师给的解法是 Composite 综合分:
Composite = 0.7 × Rating + 0.3 × Heat
其中 Heat 是赛道热度分,来自一张人工维护的“行业热度表”——15 个一级赛道 + 一个“其他/暂未定义”兜底,每个赛道给一个 0-100 的基准分。表的口径是 30% 资金面 + 25% 政策面 + 25% 行业共识 + 20% 退出活跃度,季度更新。AI 只负责把项目归类到具体赛道,分数由 Python 端从权威表里查,保证跨标的可比。
权重 0.7/0.3 不是定死的,可改一行配置就生效。基金老板觉得行业风口更重要可以调到 0.5/0.5,觉得公司本身要更重要可以调到 0.85/0.15。
下面是当前 deal flow 表的真实排序(9 个标的,公司名脱敏):
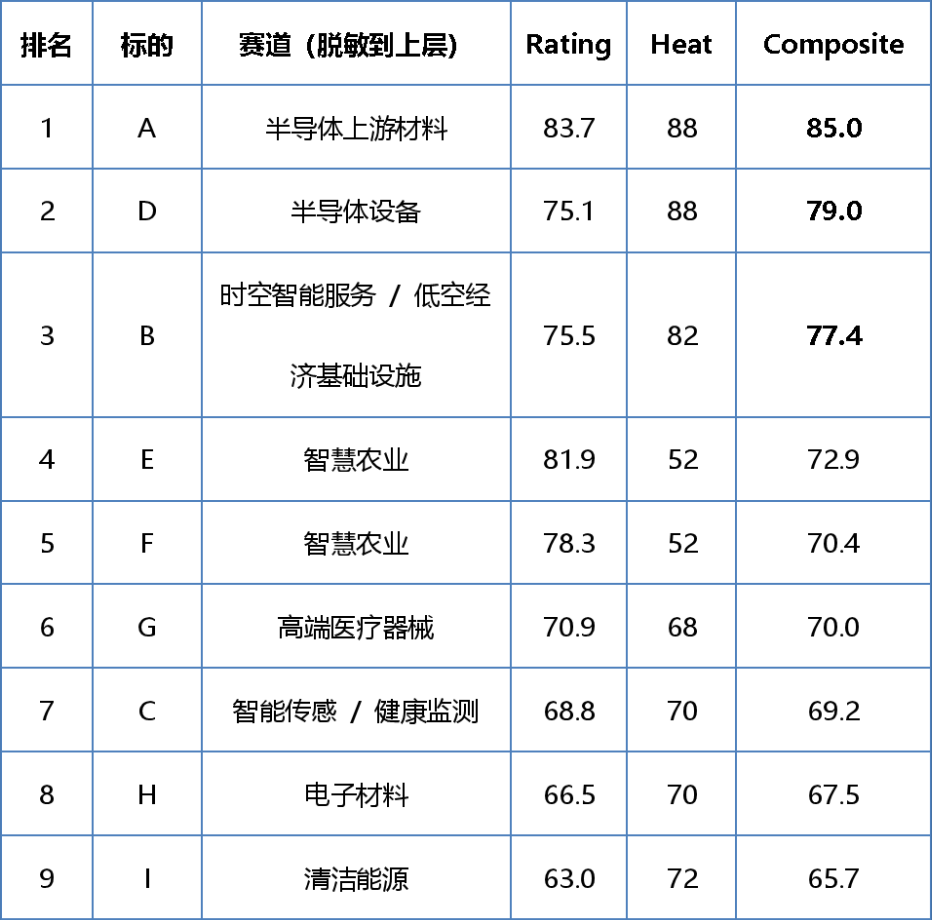
注意 E(智慧农业)和 F(智慧农业)——单看 Rating 它们分别是第 1 和第 3,但 Composite 排序里掉到了第 4 和第 5,因为智慧农业赛道当前热度只有 52。反过来 D(半导体设备)Rating 只有 75.1(第 5),但 Composite 反超到第 2,因为半导体设备热度 88。
这正是 Composite 想解决的问题。Rating 衡量的是“这家公司本身怎么样”,Heat 衡量的是“这条赛道值不值得现在投”。两者加权后才接近真实的“基金 IM 该不该把它放在 deal flow 前列”的判断。
03 · 基金匹配不能出错
这是 IM 自尊心和 IR 关系的双重痛。把项目推到对口基金能拿到引荐机会,推错了——比如把天使轮项目推给只投 B 轮以后的基金、或者推荐了一个根本不在 fund 库里的基金名字(AI 偶尔会拼写错或者凭印象编一个)——结果就是 IR 那边尴尬一次,机构对你的“专业度”打折。
虚拟投资分析师在基金匹配这一环做了一个最严格的“事实核查 Agent”,权重设计上把“基金真实存在性”放到了所有维度里最高的 40%:
-
推荐的每个基金名,必须 逐字符 出现在你维护的基金画像文件里,对不上直接判错重写
-
每条推荐理由必须 点名引用 该基金画像里实际写过的偏好(如“某基金画像写明偏好半导体上游材料,本项目属于该赛道”),不能笼统说“匹配度高”
-
推荐基金的阶段必须与项目轮次兼容
-
每个项目推 1-3 个基金,不能 0 个也不能超 3 个
举一个真实例子:B 标的(时空智能 / 低空经济基础设施)的 matching 评审一次通过,得分 98(满分 100),系统给出两个推荐基金(皆为脱敏后的“某国资创投 X”和“某产业基金 Y”),每条理由都精确引用了基金画像里写过的具体偏好(如“基金 X 画像中写明偏好基础设施类项目和高精度位置服务场景,本项目属于该赛道”)。
而 C 标的(智能传感 / 健康监测)就是个典型反例:系统给出 2 个候选基金后,match_score 分别只有 58 和 42,并在 overall_reasoning 里直接点明“现有 7 支基金中多数赛道不匹配,仅 1 支在 AI/传感器大方向有弱关联但细分领域不符”。
系统不会硬推。它会诚实告诉 IM:“这个项目跟你的基金库匹配度差,慎重推。” 这比一个“为了交差强行推 3 个”的报告更值钱。
三、它怎么工作?
整套系统的工作链条是这样:
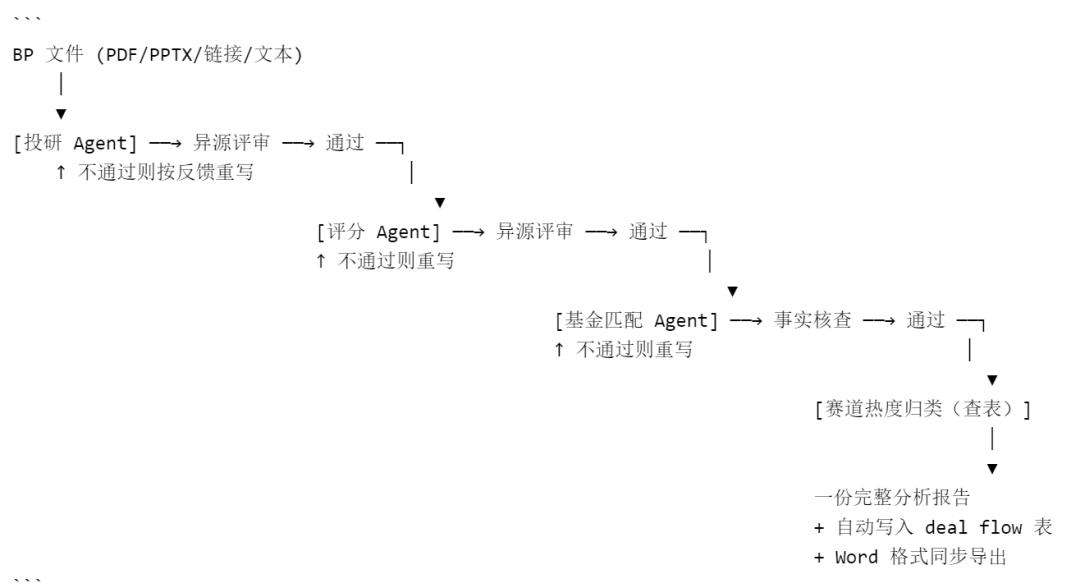
每一段的“评审 Agent”都用一家不同厂商的模型,避免同源自评盲点。每次评审不仅给分,还把发现的硬伤记到一个累积的“失败案例库”里——下次再跑新 BP 时,系统会把最近的失败案例作为“前车之鉴”自动塞进 prompt,让它知道“上次踩过这个坑这次别再踩”。
对使用者,整个流程是透明的:命令行敲一行 `analyze --bp 某BP.pdf`,等 10-15 分钟拿到结果。多份 BP 可以一行 `batch` 命令串行跑完。完全无人值守可以启动 `watch` 模式,让系统每 60 秒扫一次输入目录,新文件自动跑——周末把 10 份 BP 丢进去,周一早上结果都摆好。
四、真实使用效果
下面是脱敏后的关键数字:
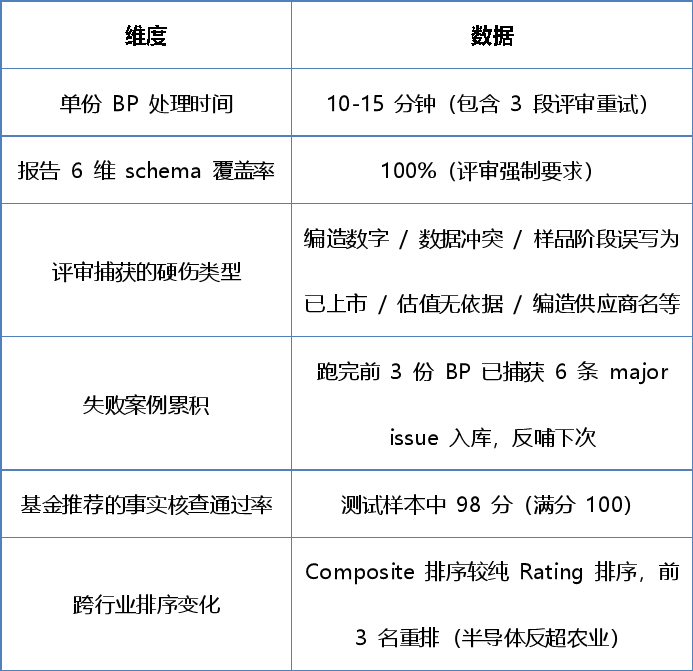
一个具体的对照:同一份某硬科技标的的 BP,旧版本系统跑出来 Rating 79.4 / Composite 82.0;加了评审机制后重跑,Rating 83.7 / Composite 85.0——评分本身更准确了,因为评审环节强制要求“基金匹配度”的 reasoning 必须点名具体基金,不能笼统说‘匹配度高’,所以新版本能识别出旧版本漏掉的强匹配项。
五、适合谁用?
按这个产品的能力边界,最合适的几类使用者:
-
基金投资经理 / 分析师: 一线 BP 阅读量大,需要把“快速过一遍 + 给个初判”提速 5-6 倍
-
基金合伙人 / GP: deal flow 跨行业排序、决策辅助、报告标准化
-
个人天使投资人 / 小型 LP: 没有团队帮看 BP,需要一个“副驾驶”
-
FA / 财务顾问: 给项目找匹配机构、批量出 teaser 报告
-
企业战投部 / 上市公司投资经理: 给老板写决策报告、行业研究、跨项目对比
如果你是创业者,也可以反向用:把自己的 BP 喂给它,看它怎么打分、推荐了哪些类型的基金、风险点列了什么——本质上是预演了一次“对口基金 IM 第一眼看到你 BP 的反应”。
不太适合的场景:纯做并购/重组/PIPE 这种重交易结构设计的工作(这套系统不做估值建模和交易结构推演),以及完全只做二级市场的投资决策(这套是给一级市场早期-成长期项目设计的)。
写在最后
虚拟投资分析师不是想替代基金 IM 的判断,它的定位非常明确:把 IM 工作流里“必须做但最耗时”的那部分(读 BP、写初稿、初筛、匹配候选基金)从一小时压到十分钟,让 IM 把节省下来的时间放回判断、谈判、构建关系这些 AI 不能替代的事上。
它也不是一个完美的系统。三段评审里偶尔会出现评审 Agent 自己挂掉的情况(输出超长截断、模型协议兼容问题),这些都是设计内的容错路径——评审挂了不会阻塞主流程,会保留当前结果继续往下走。每次失败和成功的经验,都会沉淀到失败案例库里反哺下一次。系统的智能不来自任何一个 Agent 单独的能力,而来自它“愿意承认自己会犯错并把错误记下来”的机制。
了解更多智能决策的前沿技术与行业应用
智能决策进行时:久章智能在物流与制造领域的探索与实践
做投资初筛,政府公开数据该怎么查?|附基金偏好优先级矩阵
智能决策 同路人
信息交流
欢迎垂询
邮箱|[email protected]
本文转载自久章智能微信公众号(原文发布于 2025-06-30),内容保持原貌。扫码关注公众号「久章智能」,第一时间获取系列文章。阅读原文 ↗